
Arborをオープンソース公開:Agentに盲目的な試行錯誤ではなく、研究者のような科学研究をさせる
中国人民大学高瓴人工知能学院 × Microsoft Research が自律科学研究フレームワークArborをオープンソース化。Hypothesis-Treeで複数回の実験を蓄積可能な研究状態へと組織し、HuggingFaceデイリーランキング首位を獲得。長期タスクのheld-outゲインはCodex・Claude Codeの平均の2.5倍超。
Arborをオープンソース公開:Agentに盲目的な試行錯誤ではなく、研究者のような科学研究をさせる
中国人民大学高瓴人工知能学院 × Microsoft Research が自律科学研究フレームワークArborをオープンソース化。Hypothesis-Treeで複数回の実験を蓄積可能な研究状態へと組織し、HuggingFaceデイリーランキング首位を獲得。長期タスクのheld-outゲインはCodex・Claude Codeの平均の2.5倍超。
今のAIエージェントはコードを書き、実験を走らせ、方針を直せる。しかし大多数はひとつの中核的な敷居を越えられない:実行はできても、自律的な科学研究ができない。ある方向を試して失敗し、別の方向を試してまた失敗し、たまに成功しても、その成功の背後にあるメカニズムを知見として沈殿させられない。中国人民大学高瓴人工知能学院 × Microsoft Research の研究者たちは Arbor をオープンソース化した——汎用かつ実用的な自律科学研究フレームワーク&ツールキットで、「仮説ツリー(Hypothesis-Tree)」によって短命な実験の数々を、長期的に蓄積でき監査可能な研究状態へと組織する。論文はHuggingFace Daily Paperの日別ランキング1位に立った。
この記事では、Arborが解決する問題、中核メカニズム、実測効果、始め方を順に分解する。
何を解決するのか
論文は自律科学研究を Autonomous Optimization(AO) として形式化する:初期artifact(モデル学習コード、agent harness、データ生成pipeline)+研究目標+実行可能なevaluatorを与えられ、Agentは段階ごとの人的監督なしに、devセットだけを見て、複数ラウンドの実験を通じてartifactを改良し続け、最終的にtestセットで効果を向上させる。
既存のAgentは3つの点で立ち往生している:
- 対話履歴が長くて散らかっており、構造化された研究判断を担えない
- 作業ディレクトリはコードの変化しか記録せず、その変化に対応する仮説を説明しない
- ログは結果を保存しているが、Agentになぜ成功・失敗したかを教えられない
その結果、Agentは多くのtrialを走らせても、それらのtrialが本当のresearch progressへ収束しない。
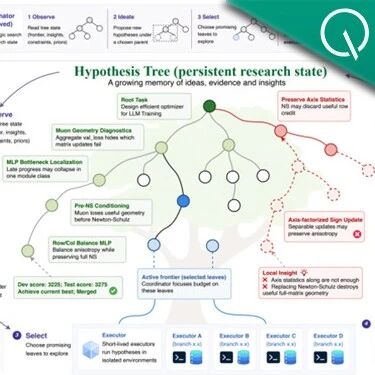
上図はあるMath-Reasoning Data Synthesis実行で得られた仮説ツリーと、対応するdevelopmentスコア曲線だ。
中核メカニズム:Hypothesis-Tree+insightの伝播
Arborの鍵は、Agentに何度も試させることではなく、探索の組織の仕方を変えることにある。
Hypothesis-Tree(仮説ツリー)
研究空間を木構造へ構造化し、各ノードを検証待ちの仮説とする。Agentは仮説を軸に隔離実行、エビデンス比較、探索木の更新を行い、一本の軌跡上で突き進み続けるのではない。
insight伝播メカニズム
最も中核的なコンポーネント。失敗は捨てられる負例ではなく、帰因・抽象・伝播される研究エビデンスであり、成功も孤立したスコア向上ではなく、再利用可能な局所的発見である。これらのinsightは木に沿って上方へ伝播し、以降の探索分布を形成し続ける——Agentは失敗済みの経路を繰り返すことが減り、有効なメカニズムの周りで掘り下げやすくなる。
Arborは2つの設計ポイントを強調する:
- 汎用性:特定のbenchmarkやタスク形態に縛られない。最適化すべきartifact、明確な目標、実行可能なフィードバック信号があれば、model / harness / data のどれでも最適化できる。
- 実用性:独立CLIとAgent SDKをオープンソース化しており、直接組み込める。
実測効果
6つの実AOタスク(数学推論データ合成、SWE、Terminal-Benchなど)とMLE-Bench Liteにおいて:
- 6タスクで CodexとClaude Codeの平均に対し相対held-out gain 2.5倍超 の向上を獲得
- Terminal-Bench 2.0:held-out pass rate を初期69.81から 77.36 へ向上
- MLE-Bench Lite:Arbor with GPT-5.5 が 86.36% Any Medal を達成、現在のSOTA
消融実験もinsight伝播の重要性をさらに裏付けた(MLE-Bench Lite上):
| 構成 | Any Medal |
|---|---|
| 完全なArbor | 81.82% |
| 仮説ツリーを除去 | 63.64% |
| ツリーを保持し、insightの上方伝播のみ除去 | 54.54% |
直感に反する結論がひとつ:洞察の伝播だけを除くと、木全体を取り除くよりも落ち込む。経験を伝播しない木は実験を「順番に並ばせる」ことしかできず、その後の意思決定に本当に必要な意味的記憶を与えられない。
💡 ヒント:Arborのトークン消費はClaude Codeなどのベースラインと同水準でありながら、より大きいheld-outゲインを手にしている。これはボトルネックが計算量の多寡ではなく、計算がどう組織されるかにあることを示す。
始め方
- 論文:https://arxiv.org/pdf/2606.11926
- コードリポジトリ:https://github.com/RUC-NLPIR/Arbor
- プロジェクトページ:https://ruc-nlpir.github.io/Arbor/
Arborは独立CLIとAgent SDKを提供する。最適化すべきartifact、実行可能なevaluator、明確な目標があれば、接続して自律最適化を走らせられる。
誰に向くか
- AI研究者:Arborを長距離自律実験の実行基盤とし、複数回の試行錯誤を再利用可能な研究メモリへ沈殿させる。
- モデル/Agentチーム:学習コード、agent harness、データpipelineの最適化に使い、素のcoding agentを走らせるより安定したheld-out向上を得られる。
- 長期タスク開発者:「ひとつの研究対象を継続的に最適化する」必要のあるシーンはすべて、ArborのAO定義に収まる。
現時点の限界
著者たちは率直に認める:Arborは、Agentが人間研究者級の創造性を備えたことを意味しない。現状のAgentが生成するideaの品質にはまだ大きな改善余地があり、困難なタスクでは真に新規なメカニズムを提起できなかったり、有望な方向を早々に手放したりするおそれがある。より高品質な仮説の生成、真の向上と偶然の過剰適合の区別、より長い周期での信頼できる記憶の維持は、いずれもopen questionだ。
参考
- 論文:Toward Generalist Autonomous Research via Hypothesis-Tree Refinement(arXiv:2606.11926)
- GitHub:https://github.com/RUC-NLPIR/Arbor