
Baidu が Unlimited OCR をオープンソース化:アクティブ500Mの小モデルが40ページを一息に記憶喪失なしで読み切る
Baidu がオープンソース化した Unlimited OCR は、総パラメータ3B / アクティブ500MのエンドツーエンドOCRモデル。OmniDocBench の SOTA を更新し、単一推論で数十ページの文書を記憶喪失なしに転写します。
Baidu が Unlimited OCR をオープンソース化:アクティブ500Mの小モデルが40ページを一息に記憶喪失なしで読み切る
Baidu がオープンソース化した Unlimited OCR は、総パラメータ3B / アクティブ500MのエンドツーエンドOCRモデル。OmniDocBench の SOTA を更新し、単一推論で数十ページの文書を記憶喪失なしに転写します。
文書のデジタル化、契約書の解析、長い PDF の転写をしたことがあれば、共通の問題に悩まされた経験があるでしょう。OCR モデルがページを追うごとに「記憶喪失」し、数十ページの文書は外部スケジューラでつなぎ合わせるしかなく、後半になるほど遅く、乱れていくのです。Baidu が新たにオープンソース化した Unlimited OCR はこの痛点を直接狙っており、単一推論で最初のページから最後のページまで読み切り、KV キャッシュの占有は一定です。
長文書のエンドツーエンド解析が必要な開発者、RAG ナレッジベースを構築するチーム、OCR を本番パイプラインに組み込みたいのに「ページ単位処理」に足を引っ張られている人に適しています。モデルとコードはすべて公開済みで、すぐに使えます。

Unlimited OCR とは
一言でまとめると、「参照スライディングウィンドウアテンション」(R-SWA)を極限まで活用したエンドツーエンドの OCR MoE モデルです。
- 総パラメータ3B、実際のアクティブはわずか500M——大モデル時代にはほぼ無視できる規模
- OmniDocBench v1.5 で93.23%、v1.6 で93.92%を達成し、エンドツーエンドの SOTA を更新
- 同じ土俵の競合では、235B の Qwen3-VL が89.15、72B の Qwen2.5-VL が87.02、Gemini-2.5 Pro が88.03
アクティブパラメータは彼らの端数にも満たないのに、ベンチマークスコアではすべてを引き離しています。これが Unlimited OCR の最も直感的な売りです。
コアメカニズム:R-SWA が「ページ単位の記憶喪失」を解決
標準的なアテンション機構では、出力が長くなるにつれて KV キャッシュが雪だるま式に急増します——メモリが耐えきれなくなり、速度もどんどん落ちます。これこそ、すべての OCR モデルにページ単位処理を強い、頻繁に「記憶喪失」させている本当の原因です。
Baidu の解法は **Reference Sliding Window Attention(R-SWA、参照スライディングウィンドウアテンション)**で、人が本を書き写すときのアテンションのパターンに対応します。
- 1つのトークンを生成するたびに、モデルはすべての「参照トークン」(画像全体の視覚トークン+プロンプト)を見に行き、完全な原文を常に「見えている」状態に保つ
- ただし出力側では、直前の128トークンしか振り返らない。本を書き写すときに、今書いたばかりの数行だけをちらっと見るのと同じです
- すべてのアテンション層を R-SWA に置き換えると、KV キャッシュは固定容量のキューになり、1万トークンの出力も10万トークンの出力もメモリ占有はまったく同じ
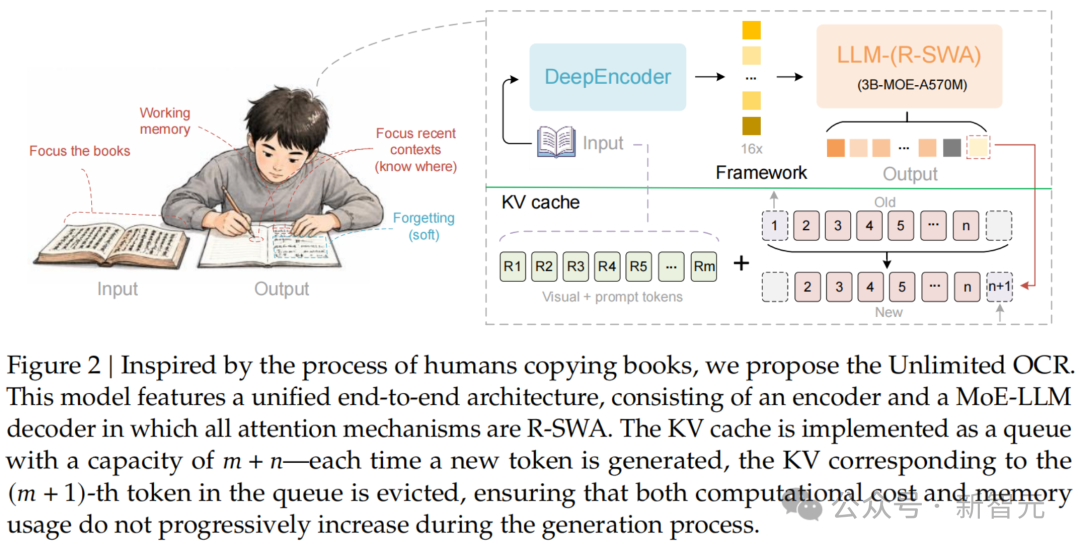
当初 DeepSeek OCR で登場した DeepEncoder エンコーダーとの組み合わせにより、1024×1024の PDF ページ1枚がわずか256個の視覚トークンに圧縮されます(16倍の圧縮率)。視覚トークンは R-SWA 下では状態遷移に参加しないため、文書がどれだけ長くても画像情報は常に明瞭で、デコード過程で劣化しません。
単一推論で数十ページを読み切る
標準的な 32K コンテキストでは、Unlimited OCR は1回の順伝播推論で数十ページの文書を転写できます。
| 入力文書 | 編集距離(原文との逐字比較) | 繰り返し出力 Distinct-35 |
|---|---|---|
| 20ページ | 0.057 | — |
| 40ページ以上 | < 0.11 | 97% |
数十ページを一息に転写しても、復唱はほとんどありません。
スコア比較では、OmniDocBench v1.5 の総合スコアは93.23%で、DeepSeek OCR の87.01%を6.22ポイント上回ります。テキストの編集距離は0.073から0.038に低下し、数式の CDM は83.37から92.61へ急上昇、表の TEDS は84.97から90.93に向上。9つの主要文書タイプ(PPT、論文、雑誌、新聞など)のうち、テキストと読解順序の2項目で DeepSeek OCR を全面的に上回り、さらに7つのカテゴリで DeepSeek OCR 2 をリードしています。
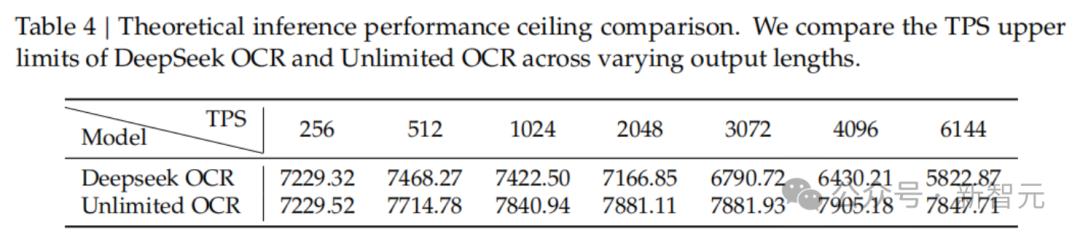
効率も圧倒的です。6144トークン出力時の TPS は、Unlimited OCR が7847であるのに対し、DeepSeek OCR はすでに5822まで落ちており、差は35%。これは500Mアクティブの MoE 小モデルが、DeepSeek OCR をベースにわずか4000ステップ追加学習した結果です——R-SWA は解析タスクにとってほぼ「無料のランチ」のようなものです。
使い方
リポジトリとモデルの重みはどちらも公開されています。
- GitHub リポジトリ:https://github.com/baidu/Unlimited-OCR
- Hugging Face ウェイト:https://huggingface.co/baidu/Unlimited-OCR
リポジトリを直接取得して README どおりにデプロイするだけでよく、重みはローカル推論に対応しています。OCR を本番パイプラインに組み込みたいが、ページ単位のスケジューリングロジックに足を引っ張られたくないチームにとって、評価に値する新しい道です。
適用シーン
- 長文書のエンドツーエンド転写:契約書、論文、レポートを一気に読み切り、外部のページ分割スケジューリングを省く
- RAG ナレッジベース構築:安定した全文出力はチャンク分割とベクトル化に好都合
- 表 / 数式 / 混合組版の解析:TEDS、CDM 指標で明確にリード
- エッジ / 低計算力デプロイ:500M アクティブの規模で、ハードウェアに優しい
💡 ヒント:現行版のコンテキストウィンドウは32Kです。論文の展望では、次のステップとして128Kまで学習させ、prefill pool を構築してモデルに自動ページめくりを学ばせることに触れています——そのとき OCR の境界は「1ページの文字の認識」から「1冊の本全体の理解」へと拡大します。
背後の人々
技術報告書の署名で興味深いディテールがあります。コア貢献者は3人で、技術ディレクターは「YY」というイニシャル表記です。GitHub の謝辞欄では Deepseek-OCR と Deepseek-OCR-2 が上位2位に並んでいます。能力、タイムライン、署名の仕方を総合すると、外界では YY は DeepSeek を離職した OCR のコア著者である魏浩然(DeepSeek OCR の一代から二代まで、DeepEncoder と MoE デコーダーを含めて一手に構築した人物)だと広く推測されています。
利用者にとってより実際的な意味は、この R-SWA パラダイムが ASR(音声認識)や翻訳へさらに展開されれば、Baidu が手にするのは単なる OCR モデルではなく、汎用的な長距離解析の技術フレームワークになるということです。長期的に注目に値します。