
Baidu が Unlimited OCR をオープンソース化:32K コンテキストで一冊の本を一度に読み切る
Baidu が Unlimited OCR をオープンソース化。DeepSeek OCR をベースに R-SWA 注意力機構を導入し、OCR モデルが 32K の標準コンテキスト内で単一の順伝播推論により数十ページの文書を解析します。OmniDocBench v1.5 では 93.23% のエンドツーエンド SOTA を獲得。
Baidu が Unlimited OCR をオープンソース化:32K コンテキストで一冊の本を一度に読み切る
Baidu が Unlimited OCR をオープンソース化。DeepSeek OCR をベースに R-SWA 注意力機構を導入し、OCR モデルが 32K の標準コンテキスト内で単一の順伝播推論により数十ページの文書を解析します。OmniDocBench v1.5 では 93.23% のエンドツーエンド SOTA を獲得。
DeepSeek OCR はビジュアル token の圧縮を極限まで追求しましたが、尻尾が残っています。入力側は強く圧縮しても、出力が長くなるとデコード段階の KV Cache はやはり膨らみ続けるため、多くの OCR システムは最終的に「1 ページずつループ呼び出し」という工学的妥協に退いています。Baidu が今回オープンソースにした Unlimited OCR が受け取ったのはまさにこのバトンです——エンコーダを変えず、デコード側に特化し、モデルが 32K の標準コンテキスト長で 1 回の順伝播推論により本一冊を読み切れるようにします。
結果は明確です。文書解析の主流ベンチマーク OmniDocBench v1.5 で総合スコア 93.23% のエンドツーエンド SOTA を獲得し、DeepSeek OCR をちょうど 6 ポイント上回りました。モデル、技術報告、プロジェクトコードはすべてオープンソースです。
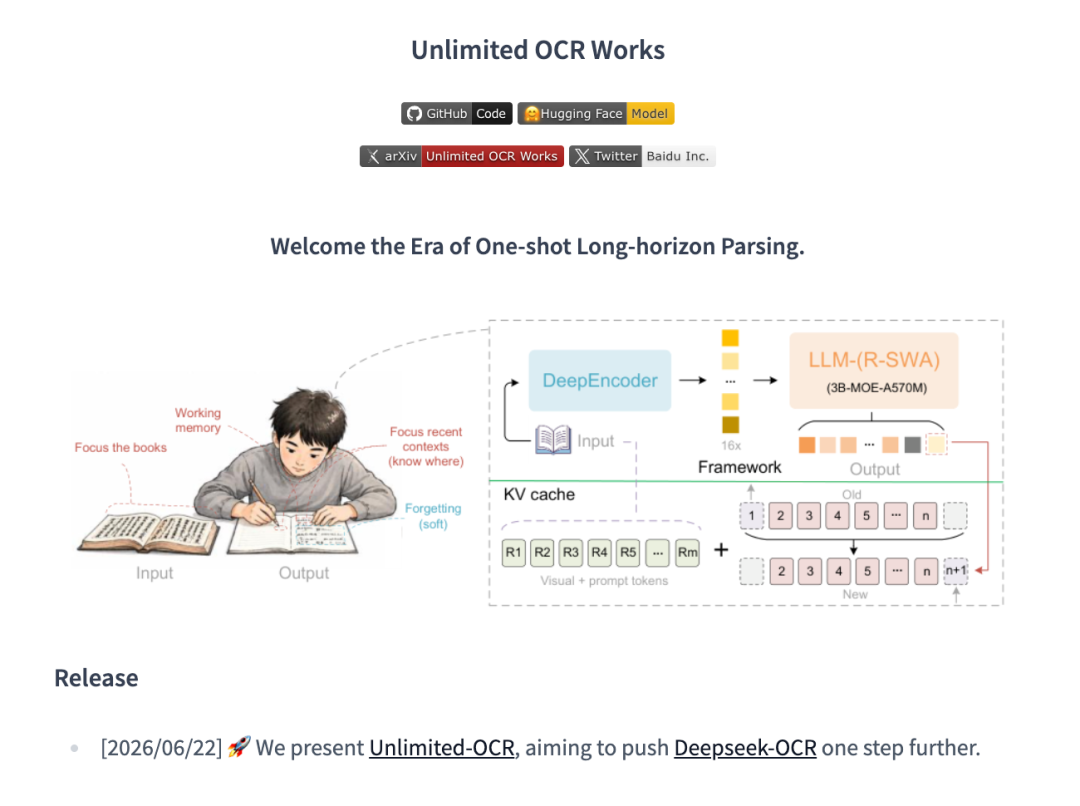
ページ単位の処理でもなく、for-loop でタスクに分解するのでもなく、単一の順伝播推論で数十ページの文書解析を直接完了します。
何を解決したのか
従来の OCR は長文書をページ単位の解析で処理します。モデルは 1 ページ目を認識し終えると状態をクリアし、2 ページ目を認識し、外部スケジューラが断片を繋ぎ合わせます。これは工学的には動きますが、意味の連続性は分断されます——モデルは自分が本一冊規模の連続した書き起こしをしていることを知りません。
Unlimited OCR の発想は、ひとつの類比から来ています。人が本を手書きで書き写すとき、注意は本全体に均等に配分されません。目は原本のページを見つめ、頭の中には書き終えたばかりの数文字を留め、そして注意を次の文字へ移します。今の文字を書きながら、前に書き写した数百ページを完全に思い返したりはしません。
この「ソフトな忘却」機構のおかげで、人間は本一冊を途切れず書き写せます。Unlimited OCR はこれを注意力機構に持ち込みました。
核心の革新:R-SWA リファレンススライディングウィンドウ注意力
Unlimited OCR は DeepSeek OCR の上に直接構築されており、総パラメータ 3B、活性化パラメータ 500M。DeepEncoder をそのまま使い、積極的なビジュアル token 圧縮を行います(1024×1024 の 1 ページがわずか 256 個のビジュアル token になります)。Baidu の鍵となる変更は、標準的なマルチヘッド注意力(MHA)を R-SWA(Reference Sliding Window Attention) に置き換えたことです。
R-SWA はモデルが見られる情報を 2 つに分けます:
- Reference tokens(参照情報):元文書のビジュアル token + prompt。常に「目の前」に置かれ、忠実度は時間とともに衰えません
- 直近 128 個の出力 token:直前に生成した短い区間だけを作業記憶として保持し、「書き終えたばかりの数文字だけを覚えている」状態を模します
R-SWA:生成される各 token は、すべての参照 token(ビジュアル+prompt)と前方 n=128 個の出力 token に注目します。デコード全体を通して KV cache は一定に保たれます。
なぜこれが鍵なのか
通常のスライディングウィンドウはビジュアル token も一緒に外へ滑り出させるため、長距離生成では視覚特徴が次第にぼやけます。一方、標準 MHA は出力が長くなるほど KV cache が膨らみ続け、後半になるほど遅くなり、VRAM が逼迫します。
R-SWA はビジュアル token を参照キャッシュに固定し、出力 token を固定ウィンドウに制限するため、次のようになります:
- KV cache が全工程で一定。出力長に比例して増えることがなくなります
- デコード遅延が一定。Flash Attention v3 カーネルでの 1 回の呼び出し時間はほぼ一直線で、DeepSeek OCR ベースラインでは明確な遅延スパイクが現れます
- GPU VRAM 使用量が固定
実測結果
メインベンチマーク:OmniDocBench v1.5
Unlimited OCR は 93.23% でエンドツーエンド SOTA を獲得しました。PPT、新聞、雑誌、ノートのような複雑なレイアウトの文書でも見劣りせず、R-SWA が純テキストにだけ優しいわけではないことを示しています。
複雑なレイアウトでも見劣りしません。
長距離解析:40+ ページを一度に飲み込む
Baidu は内部の長文書テストセットを構築し、ページ数で 2/5/10/15/20/40+ ページのいくつかのグループに分けました:
- 20 ページを同時入力しても比較的良い効果を維持
- 40+ ページの場面でも編集距離は 0.11 未満を保ち、Distinct-35 は約 97%(反復出力に陥りにくい)
長出力での速度優位
出力が 256 token の時点では 2 つのモデルの速度はほぼ同じですが、6000 token まで出力すると、DeepSeek OCR の TPS は Unlimited OCR より 35% 遅れます。出力が長いほど、R-SWA の優位は明確になります。
MHA は KV cache が長くなるほど遅くなり、R-SWA は出力側の KV cache を固定ウィンドウに閉じ込めるため、デコードのオーバーヘッドは出力長とともに膨らみません。
使い方
オープンソースのリソースは揃っています:
- 技術報告:
Unlimited-OCR Works(HuggingFace 上で直接 PDF を閲覧可能) - GitHub:
github.com/baidu/Unlimited-OCR - Hugging Face:
huggingface.co/baidu/Unlimited-OCR
モデルは DeepSeek OCR がベースで、「DeepSeek OCR のデコード側の注意力を入れ替えたもの」と理解できます。すでに DeepSeek OCR を使っているワークフローなら、移行コストは主に注意力層の置き換えです。
応用シーン
- 本一冊 / 長報告のデジタル化:1 回の順伝播で PDF 一冊を書き起こし、ページ単位の制御は不要
- 学術資料の大量解析:ページをまたぐ数式、図表、参考文献が意味的につながったまま
- アーカイブ / 新聞 / 雑誌:複雑な多段組みレイアウトも 1 回の推論で完了
- RAG の文書前処理:長文書解析が外部の連結器によって意味を分断されなくなります
💡 ヒント:HuggingFace の謝辞欄には「DeepSeek-OCR、DeepSeek-OCR-2 に感謝」と明記され、技術報告中の DeepSeek OCR への引用は 40 回に上ります。すでに DeepSeek OCR のエコシステムにいるチームにとって、Unlimited OCR は路線に沿ったアップグレードで、スタックの乗り換えではありません。
プロジェクトアドレス:github.com/baidu/Unlimited-OCR
関連記事
OpenWorker:呉恩達(Andrew Ng)がオープンソース化したデスクトップAI同僚、成果物をそのまま納品できる
呉恩達(Andrew Ng)がオープンソース化した OpenWorker(MIT)は、ローカル優先・モデル非依存のデスクトップ Agent。25以上のツールに接続し、「顧客向けブリーフを準備して」を、開ける成果物のドキュメントに変えてくれます。
AutoMIA:画像2枚から3Dプリント可能な鏡像イリュージョンを生成、RTX 3090の1枚で動く
清華大学発 CVPR'26 Highlight のオープンソースプロジェクト AutoMIA。画像2枚を入れるだけで、3Dプリント可能な体素の鏡像イリュージョンアートモデル(STL-ready)を生成できます。RTX 3090 の1枚で、1デザイン約76秒。
Macaron-V1:MoLで個人の経験をLoRAへ圧縮するオープンソースCoding大規模モデル
心洲科技 Mind Lab がオープンソース化した Macaron-V1(Venti/Coding-Venti/Tall の3段階)。GLM-5.2 744B + 1B LoRA エキスパート4つからなる Mixture-of-LoRA アーキテクチャで、無料 hosted API と UI4A プラグインも提供します。
UniWorld-View:1枚の画像/動画から任意のカメラ軌跡を生成、WorldScore首位の完全オープンソース
北京大学 + 兔展智能 + 鵬城実験室がオープンソース化した UniWorld-View は、1枚の画像/動画から任意のカメラ軌跡の新視点動画を生成し、李飛飛チームの WorldScore ランキングで首位。コードと重みは Apache-2.0 で完全オープンソース、ワンクリックダウンロードにも対応します。
Claude Managed Agentsの6項目更新:スキル上限を500へ引き上げ、実践APIペイロード付き
Anthropic のマネージドエージェントプラットフォーム CMA が6項目の更新を一挙公開。セッションのスキル数は20から500へ引き上げられ、effort の5段階を per-agent のモデル設定へ書き込めるほか、initial_events 付きでシードセッションを1ステップ生成できます。
DojoAgents:10分でローカルに金融リサーチエージェントを構築する
深涌智能(Alpha-Dojo)がオープンソース化したエージェントフレームワーク。A株/米国株/香港株に対応し、市場のメイントレンドを自律的に分析する金融リサーチエージェントを10分でローカル構築できます。