
BaiduがUnlimited OCRをオープンソース化:1回の順伝播推論で本1冊を読み切る
BaiduがDeepSeek OCRをベースに発表したUnlimited OCRは、R-SWA機構により32Kコンテキストの長距離解析を実現。OmniDocBench v1.5でエンドツーエンドSOTAの93.23%に達した。
BaiduがUnlimited OCRをオープンソース化:1回の順伝播推論で本1冊を読み切る
BaiduがDeepSeek OCRをベースに発表したUnlimited OCRは、R-SWA機構により32Kコンテキストの長距離解析を実現。OmniDocBench v1.5でエンドツーエンドSOTAの93.23%に達した。
DeepSeek OCR が残した長文書解析の難題を、Baidu が引き受けた。Baidu は HuggingFace で新モデル Unlimited OCR をオープンソース化した。標準の最大コンテキスト長32Kという条件の下で、OCR モデルが初めて本1冊を一息に読み切れるようにした——ページ逐次処理でも、for-loop 式のタスク分割でも、外部スケジューラによる結果の継ぎ合わせでもなく、真正に1回の順伝播推論で数十ページの文書解析を直接完了する。本稿は、何を解決したのか、どう使うのか、オープンソース化後に何ができるかを分解して紹介する。
Unlimited OCR とは
「長文書を読める DeepSeek OCR Plus」と理解すればよい。DeepSeek OCR の基盤の上に直接構築されている——視覚圧縮の部分は DeepSeek OCR がすでに極限まで詰めてあり(1024×1024の文書ページ1枚がエンコード後わずか256個の視覚 token になる)、Unlimited OCR はエンコーダを作り直さず、すべての力をデコード段階に注いだ。プロジェクトページのひとことはこうだ:「push DeepSeek-OCR one step further」。
どのような核心的問題を解決したのか
旧モデルのボトルネック:デコード側の KV Cache 膨張
なぜ DeepSeek OCR はこれほど視覚 token を圧縮しているのに、長文書処理がまだ難しいのか。答えはデコード側にある。
視覚 token を圧縮しても、モデルが生成するテキストは消えてなくならない。出力が長くなるほど、デコーダ内の KV Cache は増大し続ける。出力が長いほど VRAM 使用量は増え、履歴が長いほどアテンション計算は重くなり、生成速度はどんどん遅くなる。
だからこそ、かつての大方の OCR システムは最終的にページ逐次解析モードへ退いた——どんなに効率的なエンコーダでも、デコード段階で膨らみ続ける履歴の負担は解決できない。
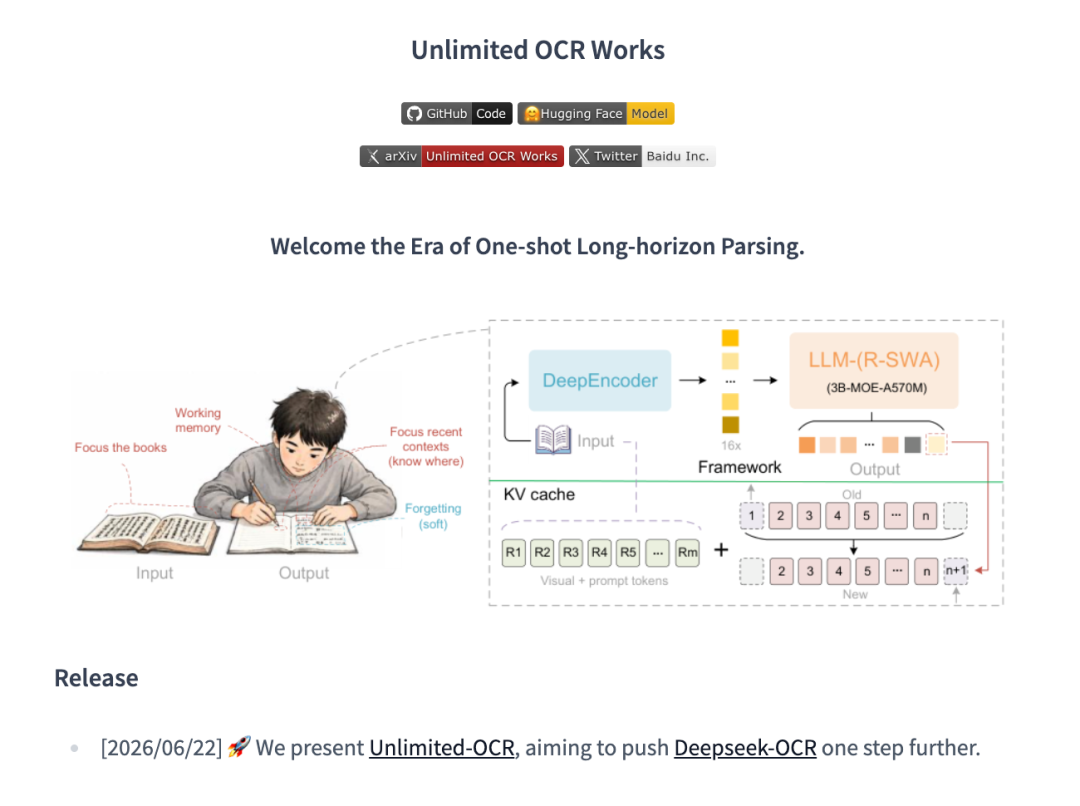
重要なのは「複数ページを処理できるか」ではなく「ページ逐次モードへ退化せずに処理できるか」だ——Unlimited OCR は後者を選んだ。
R-SWA 機構:長距離依存を失わずにコストを制御する
Unlimited OCR が導入した核心機構は R-SWA(Rotary Sliding Window Attention、回転スライディングウィンドウアテンション) だ。解決する問題は明快だ。長距離依存のモデリング能力を犠牲にせずに、アテンション計算のコストを制御する。簡単に言えば、モデルは数十ページ前の内容も見られるのに、計算量はページ数に応じて指数的に爆発しない——これが本1冊を一度に走り切れる根本の理由だ。
コア機能とベンチマーク成績
性能データ
文書解析の主要ベンチマーク OmniDocBench v1.5 では:
- Unlimited OCR は 93.23% の総合スコアでエンドツーエンド SOTA を獲得
- DeepSeek OCR をちょうど 6ポイント 上回った
OmniDocBench v1.5 は文書解析分野の標準ベンチマークで、93.23%は実文書(論文、教材、契約書など)のエンドツーエンド抽出で現在の最良水準に達することを意味する。
適用シーン
1回の順伝播推論で数十ページを処理できるため、Unlimited OCR はとりわけ次に向く:
- 本1冊 / 長レポートの一括解析:以前はページ逐次で走らせて人手で継ぎ合わせる必要があったのが、今は1回で済む
- ページ横断の一貫性の維持:図表、引用、用語集のページまたぎ参照がページ逐次処理で分断されない
- 構造化文書の抽出:長い契約書や長い論文の複雑な表、数式、レイアウトも、本全体を読み切ってから抽出できる
使い方
モデルはすでに HuggingFace でオープンソース化されており、重みとコードは直接取得できる:
- モデルアドレス:HuggingFace で「Unlimited OCR」を検索(Baidu 公式)
- ベース:DeepSeek OCR ベースで、元の工程との互換性が良い
- デプロイ:標準の transformers / vLLM フローでロードでき、特別なフレームワークは不要
💡 ヒント:DeepSeek OCR の上に築かれているため、すでに DeepSeek OCR を使っている工程はスムーズに移行できる。主な作業はアテンション実装の置き換えと新しい重みのロードで、データパイプラインを作り直す必要はない。
実際の体験
優位性
- 真の長距離:1回の順伝播推論で本1冊を処理し、ページ継ぎ合わせの工学的複雑さとお別れできる
- 堅牢なベース:すでに極限まで圧縮された DeepSeek OCR の肩に乗っており、工学的な移行コストが低い
- 完全なオープンソース:重み + コードが開放され、ローカルデプロイや二次ファインチューニングが可能
境界
- ハードウェアの敷居:32K コンテキストの長距離推論は VRAM に依然として要求を課す。ローカルデプロイには相応のスペックの GPU が必要だ
- 領域適合:ベンチマークで SOTA でも、すべての垂直文書(高度に専門的な医療画像など)で最適というわけではない。重要なシーンでは引き続き自己テストが必要だ
応用シーン
- 出版・学術:教材1冊、論文1編の構造化抽出。ナレッジベース構築でもうページ逐次処理しなくてよい
- 法務・コンプライアンス:長い契約書や長大な記録文書のエンドツーエンド条項抽出
- 企業ドキュメント基盤:従来のページ逐次 OCR パイプラインを置き換え、工学的複雑さを下げる
- 個人の長文書処理:ローカルデプロイ後、PDF1冊を一度に構造化テキストへ変換する