
Claude Skillを上手に書くための実戦7カ条
Anthropic公式によるSkill執筆経験のまとめ:コンテキストの簡素化、落とし穴リストの蓄積、安定工程のスクリプト化で、AIとの協働効率を倍増させます。
Claude Skillを上手に書くための実戦7カ条
Anthropic公式によるSkill執筆経験のまとめ:コンテキストの簡素化、落とし穴リストの蓄積、安定工程のスクリプト化で、AIとの協働効率を倍増させます。
Anthropic が、社内で Claude Code を使う中で蓄積してきた Skill 執筆の経験を公式に公開しました。これらの経験は、AI コーディング支援ツールを使うすべての人に当てはまります。Claude Code、Codex、Cursor のどれを使っていても、核心の論理は共通です。
この記事はそれらの経験を、そのまま真似できる7つの操作リストに蒸留しました。「Skill を書いたのに使いにくい」というよくある罠を避ける助けになります。
核心の認識:Skill は軌道修正であり、補講ではない
多くの人は Skill を「AI に仕事のさせ方を教える説明書」と理解しています。この理解だと、冗長で非効率な Skill ができ上がります。
正しい認識はこうです。Claude はそれ自体すでに強力であり、Skill は「補講」ではなく、軌道修正+試行錯誤の削減のためのものです。Claude はタスクを実行するたびに、どのツールを、どんな順序で、どんな基準で使うかといった大量の意思決定を行っています。Skill がないとき、それは汎用知識で推測し、大部分は当たりますが、一部は外れます。Skill の価値はまさにその「外れる少数」に集中しています。
判断基準は1つだけ:この1文を書かなかったら、Claude は間違えるか遅くなるか?ならないなら、削る。
第1条:核心資産は「落とし穴リスト」であって、手順書ではない
Anthropic のやり方はこうです。Claude があるタスクで失敗するたびに、失敗原因を1条にまとめて Skill に書き戻します。たとえば「この API のフィールド名は user_id で userId ではない」「このライブラリのドキュメントは誤っていて、実際の挙動は X である」、といった具合です。
なぜこれが核心なのか。手順は Claude がおおむね自力で導出できますが、罠は「経験」であり、経験は蓄積でしか得られず、推論では得られません。3か月使って20個の罠を溜めた Skill のほうが、書いたばかりの「完璧な」Skill よりはるかに価値が高いのです。
操作方法: よく使う Skill ごとの SKILL.md に「既知の罠」というセクションを固定で設けます。Skill の実行結果がおかしくて AI を訂正したら、その場で「これを Skill の罠に書き足して」と一言言うだけです。
第2条:SKILL.md は目次であって、全文ではない
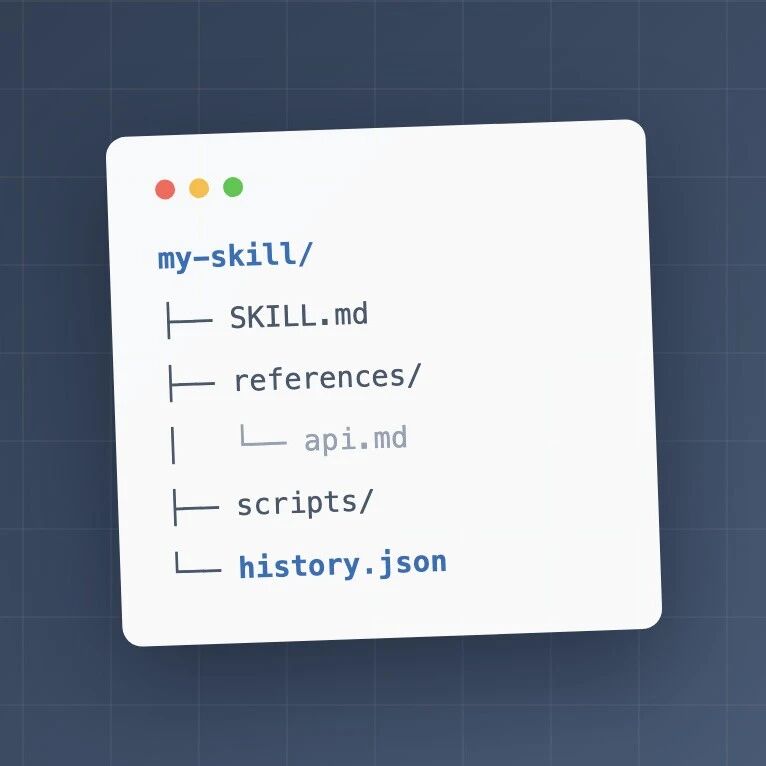
公式が推奨するディレクトリ構成:
SKILL.md        -- 核心のフロー、短いほどよい
references/     -- 詳細ドキュメント、必要なときだけ読む
assets/         -- テンプレート、サンプルファイル
scripts/ -- 実行可能スクリプトなぜか。SKILL.md は起動時に丸ごとコンテキストに詰め込まれるからです。コンテキスト内の無駄話はタダではありません。本当に重要な指示への集中を散らせてしまいます。
自己チェック基準: あなたの SKILL.md を開き、各段落に「実行のたびに必ず使うか?」と問うてください。使わないなら外に出し、references/ ディレクトリに移して、主ファイルに「X の状況を処理するときは references/x.md を読む」と1行書きます。
第3条:description には「生の言葉」を埋め込む
Skill の description は、起動されるかどうかを決めます。鍵はモデルに向けて書き、「ユーザーが実際に口にする言葉」を埋め込むことです。
ユーザーが「今週の週報を見てて」と言うとき、description に「社員の報告文書を分析」とだけ書いてあればマッチ度は弱く、「週報を見る」「日報を読む」「水増しを見抜く」といった原話を書いておけば、即座に命中率が上がります。
また、description にはいつ起動すべきでないかも書く必要があります。Skill が増えると、互いの誤起動が新たな問題になります。「X のときのみ使用。Y の場合は別の Skill を使う」の1文を加えておくほうが、事後の訂正より楽です。
第4条:ハード制約とデフォルトの好みを区別する
初心者が最も犯しやすいミスは、Skill をステップ1-2-3-4-5 の硬直した手順として書くことです。その結果、少しの変化で手順全体が固まってしまいます。
正しい書き方は、2種類の内容を区別することです:
- ハード制約(必ず守らせる):出力フォーマット、ブランド上の禁忌、安全のレッドライン。「必ず」「してはならない」と明示して書きます。
- デフォルトの好み(状況で覆せる):「デフォルトは X。Y の状況では Z にしてよい」という形で書きます。
悪い書き方:「ステップ3:動画にプログレスバーを付ける」 良い書き方:「動画にはチャプターのプログレスバーが必要。ただし素材が1分未満の場合は除く」
前者は動作を描写し、後者は意図と境界を描写しています。意図を渡されてこそ、モデルは応変できます。
第5条:確定したことはコードで、判断が必要なことはモデルに
AI がその場でコードを書くたびに結果にはランダム性がありますが、スクリプトは実行のたびに完全に一致した結果を返します。
1つのタスクの中で「毎回同じ部分」――API の呼び出し、フォーマット変換、ファイルのアップロード――は scripts/ のスクリプトとして固定し、モデルには「スクリプトの呼び出し+判断系の仕事の処理」だけを担わせるべきです。
自己チェック方法: Skill の実行履歴を振り返って、AI が毎回ほぼ同じコードを書いている箇所があれば、そこはスクリプトとして沈殿させるべき箇所です。スクリプト化した工程が多いほど、速く、安く、安定して走ります。
第6条:Skill に記憶を持たせる
やり方はシンプルです。Skill のフォルダに JSON かログファイルを置き、毎回の実行後にその回の重要な情報を書き込み、次回の実行前にまずそれを読ませます。
記憶がなければ、毎回の実行は「初めて」です。記憶があれば、Skill は使うほどあなたを理解するようになります。
最も向いているシーン:
- 期間をまたいでの比較が必要なもの(週報を読む Skill なら、今週の重要データと異常を記録し、次回自動で比較する)
- 重複排除が必要なもの(テーマ選定 Skill なら、すでに扱ったテーマを記録し、重複を避ける)
第7条:使用頻度に応じて改善の労力を配分する
Skill が20個を超えたあたりで、実態は必ずこうなります。3〜5個が高頻度で使われ、半分はほとんど手つかずです。
- 高頻度のもの:全面アップグレードの価値あり。罠リスト、記憶、スクリプト化
- 低頻度だが起動実績のあるもの:数行の最簡形態を維持し、労力を割かない
- 一度も起動していないもの:description があなたの話し方らしくない(起動語を変える)か、そもそも偽の需要(削除する)
アップグレードの労力を高頻度 Skill に集中させるのが、費用対効果が最も高い道です。
まとめ:操作チェックリスト1枚
| 番号 | 操作 | 核心理由 |
|---|---|---|
| 1 | 「既知の罠」セクションを追加し、継続的に蓄積する | Skill の価値は経験の蓄積に由来 |
| 2 | SKILL.md を痩身させ、詳細は references/ へ | コンテキストの無駄話が注意力を薄める |
| 3 | description に排他説明を加える | 誤起動を防ぐ |
| 4 | ハード制約とデフォルトの好みを分けて書く | 手順でなく意図を書く |
| 5 | 重複コードはスクリプトに固定する | スクリプトはランダム性ゼロ |
| 6 | history.json の記憶を追加する | 使うほど理解が深まる |
| 7 | 使用頻度に応じて改善労力を配分する | 高頻度 Skill こそ全面アップグレードに値する |
参考リンク: Anthropic 公式ブログ Lessons from Building Claude Code: How We Use Skills