
DeNovoSWE:初の長距離Doc2Repo訓練セット、Code Agentにリポジトリ構築を学ばせる
中国人民大学高瓴学院がDeNovoSWEを発表。「ドキュメントから完全なリポジトリを生成する」初の長距離訓練セットで、4818件の実タスクインスタンスを含む。Qwen3-30BはBeyondSWE-Doc2Repoで5.8%から47.2%へ向上した。
DeNovoSWE:初の長距離Doc2Repo訓練セット、Code Agentにリポジトリ構築を学ばせる
中国人民大学高瓴学院がDeNovoSWEを発表。「ドキュメントから完全なリポジトリを生成する」初の長距離訓練セットで、4818件の実タスクインスタンスを含む。Qwen3-30BはBeyondSWE-Doc2Repoで5.8%から47.2%へ向上した。
中国人民大学高瓴人工知能学院が DeNovoSWE を発表した——長距離ソフトウェアエンジニアリングタスク、とりわけ「リポジトリレベルのコードゼロからの生成」(Doc2Repo)に特化したデータセットだ。これは1つの重要な問いに答えるものだ。Code Agent が「1つの issue を修正する」「数行のバグを直す」をどんどん得意になっていくとき、1つのドキュメントから出発してアーキテクチャを計画し、ファイルを作成し、API を設計し、モジュールを連携させ、最終的に完全に実行可能なリポジトリを生成する能力をどうやって身につけさせるのか。答えは——長距離タスクに特化した訓練環境を構築する必要がある、だ。データセット、コード、モデルはいずれもオープンソース化されている。
DeNovoSWE が解決する問題
この1年、Scale-SWE などの大規模 SWE データのスケーリングにより、コードエージェントは SWE-bench 系のタスクで急速に進歩した。しかし BeyondSWE-Doc2Repo と NL2RepoBench における最先端モデルの成績は芳しくない。
現実のソフトウェア開発は、往々にして1つの関数の修正や条件分岐の追加ではなく、次のようなものだ:
- 要件の理解
- アーキテクチャの計画
- ファイルの作成
- API の設計
- 依存関係の処理
- モジュール間の連携
- リポジトリ全体をテストで通す
これが long-horizon repository-level generation(長距離リポジトリレベル生成)だ。DeNovoSWE はこの目標を体系的に、訓練可能・検証可能・拡張可能なデータセットへと構造化した。
コアデータ
- 規模:4818件の高品質な document-to-repository タスクインスタンス
- 特徴:実行可能・評価可能・訓練可能な長距離ソフトウェアエンジニアリング環境
- 構築方法:sandboxed multi-agent workflow による自動構築で、人手で書いたドキュメントではない
| 評価ベンチマーク | 元のモデル | Scale-SWE 訓練 | DeNovoSWE 訓練 |
|---|---|---|---|
| BeyondSWE-Doc2Repo | 5.8% | 29.2% | 47.2% |
| NL2RepoBench | 4.3% | 18.3% | 23.0% |
ベースモデルは Qwen3-30B-A3B-Instruct。これは「バグ修正」向けのデータが「完全なリポジトリ生成」向けの長距離データを完全には代替できないことを示している。
より強力な Qwen3.5-35B-A3B バックボーンでも、DeNovoSWE は同様に安定した利益をもたらす。BeyondSWE-Doc2Repo は43.8%から50.0%へ、NL2RepoBench は23.5%から27.1%へ向上し、利益が高品質な長距離データそのものに由来することをさらに裏付けた。
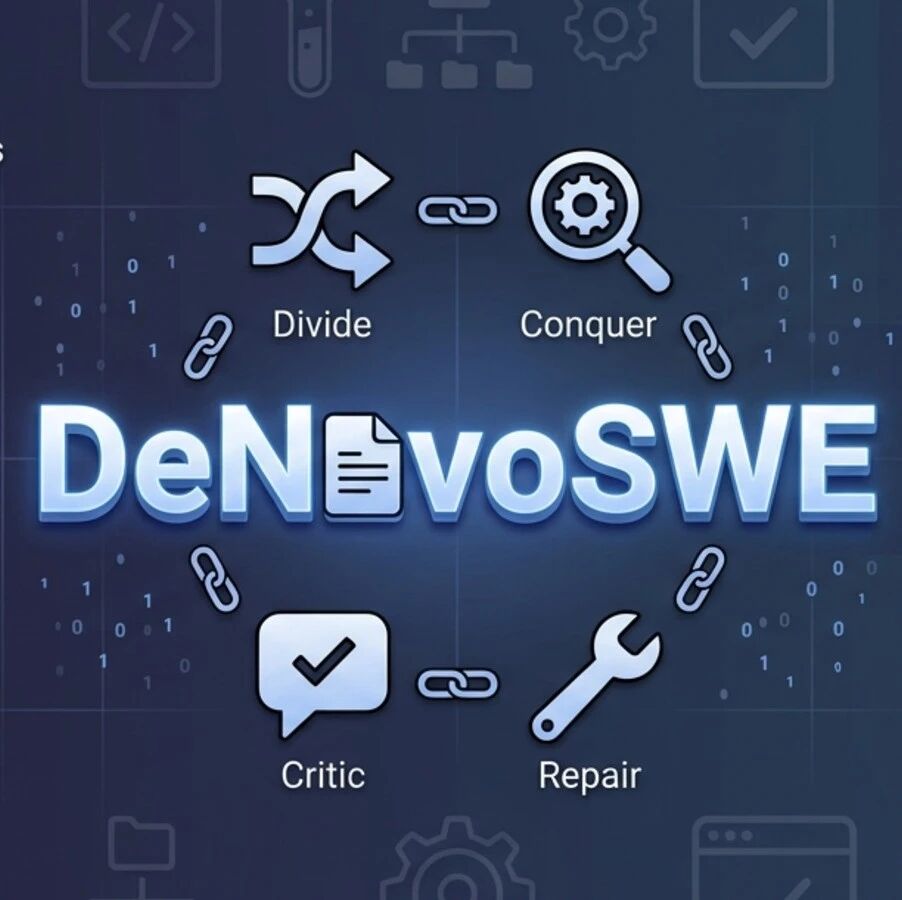
手法:Divide & Conquer + Critic & Repair
全体の手法は2ステップに分かれる。
Divide 段階:リポジトリ能力への分解
システムが対象リポジトリを分析し、複数の repository capabilities に分解する。各 capability は1つのコア能力またはワークフロー(認証と接続、データの読み書き、バッチ処理、エクスポートフローなど)に対応する。本来膨大なリポジトリ生成問題が、構造の明確な複数のドキュメント章へ分割される。
同時に、DeNovoSWE は元のユニットテストを実行して実行 trace を収集し、どの関数・クラス・インターフェースが実際に evaluation に影響するかを識別したうえで、さらに3類に区分する:
- direct components:テストから直接呼ばれるインターフェース。詳細に記録しなければならない
- core indirect components:観察可能な動作に影響するコアの間接コンポーネント。カバーが必要
- non-core indirect components:コア外の内部実装。エージェントの自由裁量に任せる
Conquer 段階:Draft-Critic-Repair ループ
Draft-Critic-Repair 機構を使い、能力ごとにドキュメントを生成する:
- Draft agent が初稿を書く
- Critic agent が重要な API、動作契約、構造情報の漏れがないか検査する
- Repair agent がフィードバックに基づいてドキュメントを修復する
ループは、各能力の章が十分に明確・完全・evaluation と整合するまで反復する。最終的に、異なる能力のドキュメントが1つの完全なタスクドキュメントへ統合される。
キーデザイン:高品質タスクドキュメントの2条件
document-to-repository generation において、ドキュメントは README でもなければ単純な API 一覧でもなく、エージェントがリポジトリ全体を再建するための唯一のタスク入口だ。高品質なドキュメントは少なくとも2点を満たす必要がある。
1. well-organized でなければならない
リポジトリレベルのタスクは本質的に複雑だ。ドキュメントが関数の説明を寄せ集めただけなら、エージェントは断片情報の中で迷子になりやすい。ドキュメントはこうあるべきだ:
- まず明確なリポジトリ全体の概観を示す
- 次に能力またはワークフローごとに章を分ける
- 各部分が明確な機能境界に対応するようにする
2. 信頼できる evaluation から出発しなければならない
ドキュメントは少なすぎても(タスクが欠定義問題になり、モデルが当てずっぽうでなければ evaluation を通せなくなる)多すぎても(実装の詳細が直接漏れ、タスクが挑戦性を失う)いけない。
真に高品質なドキュメントは、evaluation が依存する重要な動作を記述すべきだ。import path、公開 API、入出力、デフォルト引数、例外動作、設定項目、パターン文字列、戻りフィールドなど。ドキュメントはエージェントがテスト可能な動作を再現できるだけの情報を備えるべきだが、実装コードのコピーになってはならない。
難度:なぜ長距離タスクなのか
DeNovoSWE のタスクの難度は、1つの根本的な変化に由来する。もはや issue-level fixing ではなく、whole-repository generation だ。
エージェントが向き合うのは、クリーンアップ済みの環境だ:
- 元のソースコードとテストは除去されている
- git 履歴はリセットされている
- キャッシュ、site-packages の残骸、pip wheel、一時コンパイル産物などの潜在的なリーク経路はすべて消去されている
つまりエージェントは、リポジトリ全体の再建を本当にドキュメントに依存して完了しなければならない。プロジェクト構造の計画、モジュールファイルの作成、公開インターフェースの定義、ファイル横断的な連携の実装、依存と設定の処理を行い、複数ラウンドの編集とテストフィードバックの中でエラーを修正し続ける。
1つの API シグネチャ、戻りフィールド、例外型、デフォルト動作のズレが、テスト失敗につながりうる。エラーは長距離の過程で蓄積もする——初期に設計が不合理なモジュール1つが、後続の複数ファイルと呼び出しチェーンに影響しうる。
difficulty-aware trajectory filtering
リポジトリごとの難度差に対処するため、DeNovoSWE は難度を考慮した軌跡フィルタリングを提案する。易しいタスクにはより高い合格率を求め、難しいタスクは満点に達していないという理由だけで全部捨ててはならない。構造複雑度と LLM による難度判断に基づき、難度区間ごとに異なるフィルタ閾値を設定し、品質と多様性のバランスを取る。
リソースリンク
- 論文:https://arxiv.org/pdf/2606.10728
- コードリポジトリ:https://github.com/AweAI-Team/DeNovoSWE
- データセット:https://huggingface.co/collections/AweAI-Team/denovoswe
応用シーン
- Code Agent の訓練:モデルを「リポジトリ保守者」から「アーキテクト」へ進化させ、リポジトリレベルのコード生成を習得させる
- 長距離タスク評価:BeyondSWE-Doc2Repo、NL2RepoBench などのベンチマークの訓練と改善
- SWE データのスケーリング研究:「完全なリポジトリ生成」向けの長距離データの不足を補う
- エージェントワークフロー研究:Divide & Conquer、Critic & Repair、Draft-Critic-Repair などの機構を直接参考にできる
コードエージェントの次の段階は、単一の issue をより速く直すことではなく、ドキュメントを理解し、アーキテクチャを計画し、モジュールを組織し、インターフェースを実装し、最終的に完全に実行可能なソフトウェアリポジトリを生成できることだ。DeNovoSWE はこの目標を体系的に、訓練可能・検証可能・拡張可能なデータセットへと構造化した。