
Doubao オーディオ生成モデル 1.0:1 本のプロンプトで映画級音声を直接出力
Volcano Engine が Doubao-Seed-Audio 1.0 を発表。セリフ、BGM、効果音、環境音を 1 本の Prompt に詰めて一度に出力し、複数キャラクターの対話、2 分間の長距離一貫性、参照音色による続きの生成に対応します。音声モデルにおける Seedance の瞬間と評されています。
Doubao オーディオ生成モデル 1.0:1 本のプロンプトで映画級音声を直接出力
Volcano Engine が Doubao-Seed-Audio 1.0 を発表。セリフ、BGM、効果音、環境音を 1 本の Prompt に詰めて一度に出力し、複数キャラクターの対話、2 分間の長距離一貫性、参照音色による続きの生成に対応します。音声モデルにおける Seedance の瞬間と評されています。
十数秒のオーディオドラマを作るのに、従来はまずキャラクター A のセリフを生成し、次にキャラクター B、それから BGM を探し、足音、風の音、金属の打撃音を重ね、最後に編集ソフトに読み込んで段階的に揃えていく必要がありました。Doubao オーディオ生成モデル 1.0(Doubao-Seed-Audio 1.0)がなくしたいのは、まさにこの流れ作業です——「誰が話すか、どんな感情か、どんなシーンか、途中にどんな音があるべきか」を 1 本のプロンプトに書くと、納品できる完成品級の音声を直接吐き出します。
Volcano Engine は本日、Volcano Ark 上で Seed-Audio 1.0 の体験と API の招待テストを開放しました。個人ユーザーには 30 分の制作枠があり、今後は CapCut、Jimeng、Fanqie などのプロダクトにも組み込まれます。オーディオブック、ポッドキャスト、ショートドラマのアフレコをやったことがある人にとって、このモデルで最も試す価値があるのは、「人が話しているように聞こえる」を超えて、声で一つのシーンを演出できる点です。
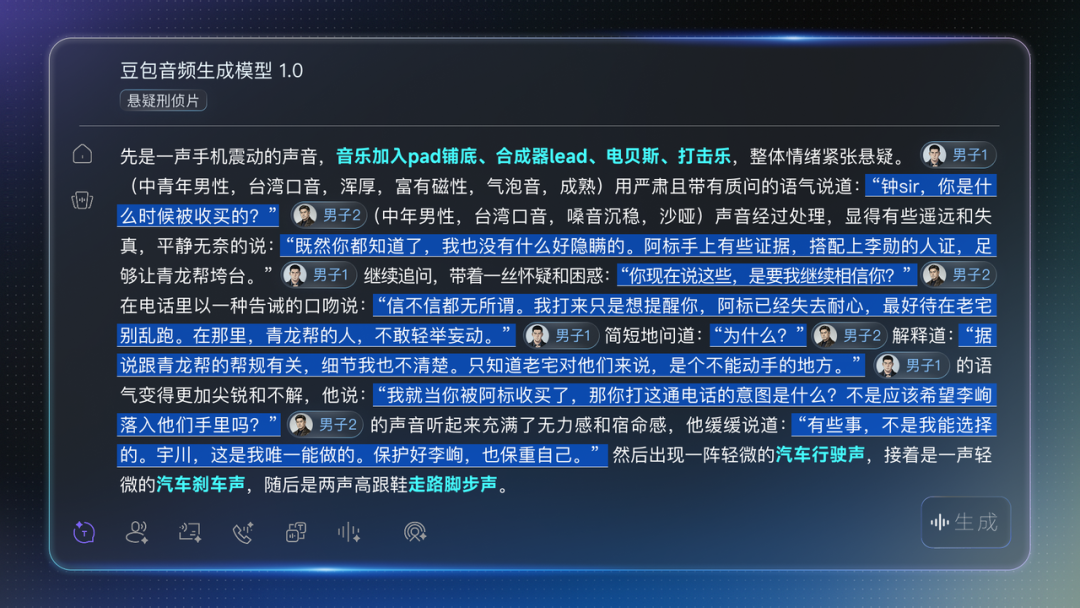
1 回の順伝播で、複数キャラクターのセリフ、BGM、効果音、環境音をひとまとめにした完成品級の音声にします。
核心のアップグレード:「音声合成」から「オーディオ生成」へ
名前の変化に、最大の方向転換が隠れています。前のバージョンはまだ「Doubao 音声合成モデル 2.0」という名前でしたが、今回は「オーディオ生成モデル 1.0」へ一足飛びです——「人間らしい一言を合成する」から「完全な一つのシーンを生成する」へのアップグレードです。3 つの能力が今回の鍵です:
- 映画級の全要素ダイレクト出力:複数キャラクターのセリフ、感情のリズム、BGM、環境効果音を 1 本の Prompt で一度に産出し、マルチトラックミキシングと位置合わせを省きます
- 長距離の音色一貫性:1 回最大 2 分で、生成済みの 2 分を参照にして先へ延長でき、数十分の間で音色、語気、環境が一致し続けます
- 参照音声生成:参照音声を 1 本アップロードするだけで似た音色の音声を生成でき、
@で複数の音声を参照して多人数・多音色を実現できます
セリフ、非言語表現(笑い/ため息/間/方言)、音楽・効果音がすべて一体で生成されます。
使い方:4 要素 Prompt 法
モデルはすでに Volcano Ark 体験センターに公開されており、入口は文末です。プロンプトは凝って書く必要はなく、4 つのことを明確に書けば十分です:
- 誰が話すか:年齢、性別、音色の特徴(例:「老いて嗄れ、見下ろすような」)
- どんな感情か:怒り、軽蔑、高揚、目覚めた直後の朦朧
- どんなシーンか:古風アニメの戦場、ワールドカップの実況席、夕方の成都の旧市街
- どんな音があるべきか:霊剣が鞘を抜く音、金属の打撃、人々のどっとした笑い、油鍋のジュージュー音、電話の話中音
ステップ 1:体験センターを開く
Volcano Ark オーディオ生成 1.0 体験ページにアクセス:
https://ark.volcengine.com/region:cn-beijing/experience/voice?model=doubao-seed-audio-1-0ステップ 2:複数キャラクターのシーン Prompt を書く
3 人の古風アニメを例に、ナレーター(青年男性)、長老(老年男性)、少年という 3 つのキャラクターのセリフと語気を、古筝、大太鼓、霊剣が鞘を抜く音、人々のどっとした笑いなどの効果音とともに、同じ 1 本の Prompt に直接書きます。モデルはキャラクターごとに音色を分けて出力し、背景音と人の声は 1 つのシーンに統一され、「二人が同じ空間にいない」という断絶感は生じません。
💡 ヒント:対話が同じ空間で起きているように聞こせたいなら、鍵は台詞だけでなく環境の記述を Prompt に書くことです。例:「長老が公堂で尋問し、少年が殿前で激しく叱る。背景に鐘の音と遠くの足音の擦れる音」。
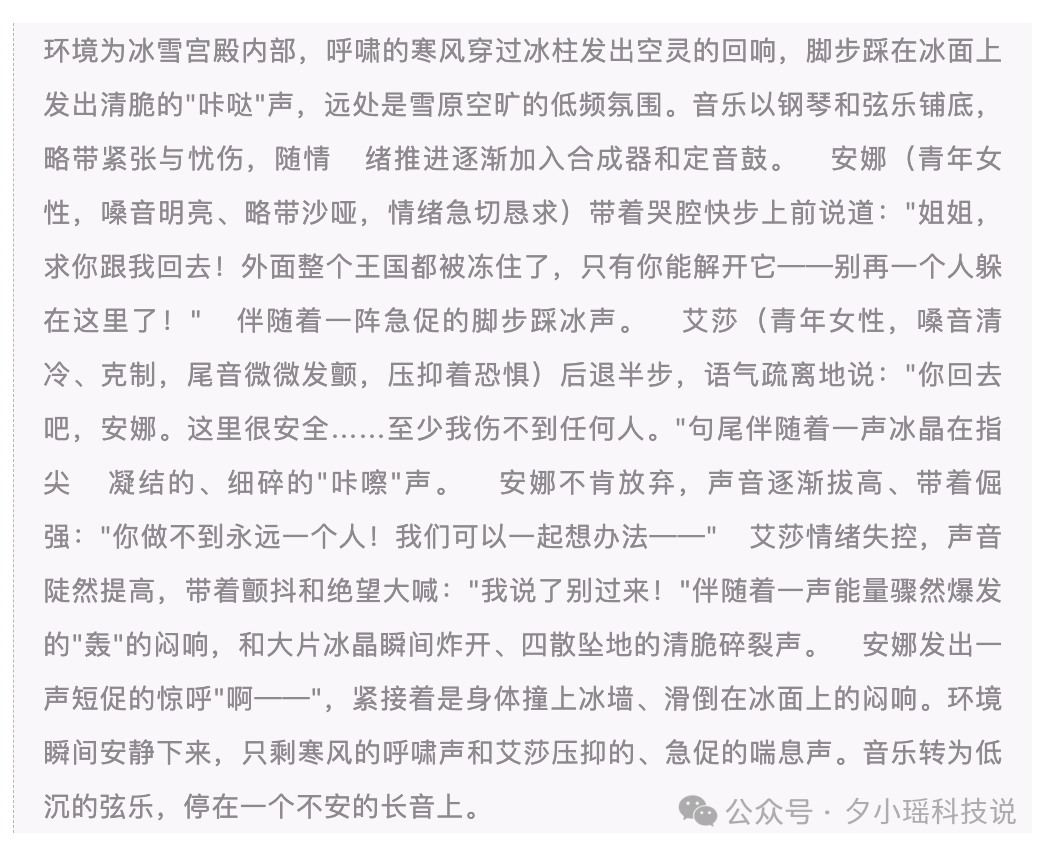
エルサが大技を放つ場面の効果音のプロンプトは、「エネルギーが一気に爆発するドーンという鈍い音 + 氷晶が弾けて地面に落ちる澄んだ砕ける音」の一文だけでした。
ステップ 3:参照音声で続きを生成
テキスト入力欄で @ を使って既存の音声を 1 本参照すると、音色を固定したまま先へ生成を続けられます。実測で話題になったデザイナーの独白(音声合成 2.0 で生成)も参照音声として投げ込まれ、1.0 がその後 1 分のストーリーを続けて生成しました——クライアントの上司が騒音で目覚める眠気、電話を切った後の 3 秒の完全な沈黙、話中音まで、すべて一度に生成されています。
複数の音声を @ すれば、多人数・多音色の対話も実現できます。
ステップ 4:長編には延長モードを
1 回の出力は 2 分です。最初のバージョンでキャラクターの状態が合っていれば、この 2 分を参照にさらに延ばすことで、数十分のオーディオブックやポッドキャストを、音色・語気・環境を一致させたまま作れます——これは従来、手作業での音の修正が最も難しかった工程です。
延長モードでは、前後数十分のキャラクターの声をモデルが一度に納品し、区間ごとに照合して繰り返し音を直す必要はありません。
実測でどこまでできるか
実測は 3 つの典型的シーンをカバーしており、効果の差は明確です:
- 複数キャラクターのアニメアフレコ:ナレーター、長老、少年の 3 役の音色は明瞭に分かれ、背景の古筝/大太鼓/金属打撃がセリフのリズムと合っており、ほぼそのまま納品できます
- 試合会場の実況:カーボベルデがスペインと引き分けたワールドカップの実況では、人の声が手前、現場の観客の声が奥に配置され、実況者の感情が試合の流れに沿います(抑える→加速→爆発→引く)。実際の実況席らしい奥行きがあります
- 方言シーン:成都の旧市街にあるボーボージー屋台の四川方言では、おばあさんが客を呼ぶ声、油鍋のジュージュー音、呼び声の起伏が、すべて同じ 1 本の音声に収まっています
また、純粋に静かなケースもテストしました——李白の「将進酒」です。長距離延長の一貫性はここで最も顕著でした。多くのモデルは長い文を読むと「ずれ」、前後で声が同じ人物に聞こえなくなりますが、1.0 は 1 回 2 分以内で音色と感情の起伏を安定させて保ちます。
誰が使うのに向くか
- オーディオブック / アニメ / ショートドラマのアフレコチーム:トラック別収録 + ポストミックスから、「1 人が Prompt を書いて演出する」へ切り替えられます
- ポッドキャストと講座の制作者:長距離延長モードで、数十分にわたり音色が一致した完成品を直接産出できます
- ブランド音声 / 広告効果音:1 段の記述を、そのまま公開できる音声 1 本に換えられます
- 方言コンテンツ制作者:四川方言の能力が検証されており、環境音付きのシーン化された断片を直接生成できます
💡 ヒント:参照音声生成は今回最も実用的で、かつ最も見落とされやすい能力です。手元に既にある、旧版の音声合成で作った良質な音色の断片を作り直す必要はありません——アップロードして参照にし、1.0 に新しいストーリーを続けさせれば OK です。
体験入口:Volcano Ark オーディオ生成 1.0 体験センター(原文をクリックで直接アクセス)。API は招待テストを開放済みで、音声制作者に向けて CapCut、Jimeng、Fanqie への搭載が近日予定です。
関連記事
MaineCoon:22Bパラメータで47.5 FPS、史上最速のストリーミング音声・動画ソーシャルモデル
Catnipチームがストリーミング音声・動画ソーシャルモデルMaineCoonを発表。22Bパラメータで47.5 FPSの推論を実現し、30分以上の音声・映像同時出力に対応。コストはVeo 3のわずか1/2000。
業務をSkillに分解する:AI時代の本当のメタ能力
AIが使えないのではなく、分解の仕方を知らないだけ。目標から動作、判断まで、頭の中のあやふやな経験をAIが実行できる構造化Skillに変える方法を1本で解説。
Claude Code Artifacts:ターミナルでの開発を共有可能なウェブダッシュボードに変える
AnthropicがClaude CodeにArtifactsを追加。開発過程をリアルタイムで共有可能なウェブページとして生成し、チーム協働での手動転述からおさらば。
Codex Record & Replay:あなたが一度やれば、AIが代わりにやり方を覚える
OpenAIがCodexにRecord & Replayを投入。Mac上でのあなたの操作フローを記録し、再利用可能なSkillを自動生成します。自動化について考え直すときが来ました。
Odysseus:トップインフルエンサーが手作りしたローカル版ChatGPT、3日で3万スター
元「世界一のYouTuber」PewDiePieがオープンソース化した完全セルフホストのAIワークスペース。無料、追跡なし、Agent内蔵で、3日間で3万スターを荒稼ぎ。
Xiaomi Miloco 2.0:スマートホームについに本当のAI執事が登場
Xiaomiが全屋スマートホームAIソリューションXiaomi Miloco 2.0をオープンソース化。マルチモーダル感知、能動的インテリジェンス、家庭の記憶を備え、Agentをスマートホーム生態系に持ち込む。