DyRef 実践ガイド:Qwen 画像編集モデルに複数参照の一貫性を加え、7枚の参照図でも崩れない
ハルビン工業大学(深圳)の DyRef(ECCV 2026 Oral)は、Qwen-Image-Edit-2511 の上に重ねる複数参照一貫性のファインチューニング手法 + RL 動的報酬トレーニングフレームワークで、最大7枚の参照図でも被写体・ポーズ・スタイルの一貫性を保ちます。本稿ではローカルでの推論と、任意の SFT/RL トレーニングの実行方法を解説します。
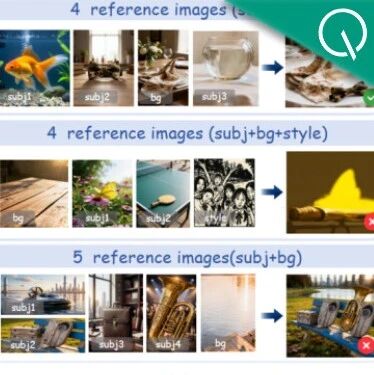
DyRef は、ハルビン工業大学(深圳)の朱涛涛研究室(第一著者 Wenwang Huang ら)が発表した画像編集トレーニングフレームワークで、論文《Scaling Multi-Reference Image Generation with Dynamic Reward Optimization》(arXiv 2606.26947)が ECCV 2026 Oral に採択されました(2026-07-24 発表)。
その切り口は非常に具体的です。既存のオープンソース画像編集モデル(Qwen-Image-Edit-2511、FLUX.2-klein-base-9B など)は、参照画像を1枚だけ渡すときはまずまずの性能を発揮しますが、役割の異なる参照画像を複数枚同時に押し込むと(被写体人物 / 背景 / ポーズ / ライティング / スタイル)、「人物の顔が変わる」「ポーズが揃わない」「スタイルが漂う」といった問題が起きます。DyRef はまさにこの弱点を補うもので、最大で約 7枚 の異なる役割の参照画像を同時に処理できます。
まず、何であって何でないのかをはっきりさせます:本サイトは2026-07-21に qwen-image-3(Alibaba Qwen の第3世代画像生成基盤モデル) をすでに紹介しました。DyRef は新しい基盤モデルではありません。Qwen-Image-Edit-2511 の上に重ねる「複数参照一貫性のファインチューニングレシピ + RL 動的報酬トレーニングフレームワーク」であり、オープンソース画像編集モデルに装着する「複数参照の制約プラグイン」と理解できます。独立した記事として取り上げる理由はそこにあります。
どの問題を解決するのか
複数の参照画像をオープンソース画像編集モデルに渡したときによく起きる失敗:
- 被写体のドリフト:A の人物 + B の背景を指定したのに、生成された人物の顔が変わってしまう
- ポーズのずれ:ポーズの参照画像を渡したのに、最終的なポーズが30度ずれる
- スタイルの混線:サイバーパンク風を指定したのに、出力は写実寄りになる
DyRef は2段階トレーニング(SFT + RL)でモデルに複数参照の制約下での一貫性を保たせ、著者らが提案した OmniRef-Bench(専門家がアノテーションした395サンプル、5種類の参照タイプ × 10種類の組み合わせをカバー)において、クローズドソースの Nano Banana Pro と対等に渡り合い、Seedream 4.5 を上回る結果を示しています。
オープンソース成果物(すべて Apache-2.0、1件ずつ確認済み)
| 成果物 | URL | 説明 |
|---|---|---|
| コードリポジトリ | github.com/Weistrass/DyRef | sft/、rl/、model_inference/、benchmark/ ディレクトリを含む、318 stars |
| モデル重み | huggingface.co/Weistrass/Qwen-Image-Edit-2511-DyRef | LoRA 重み |
| トレーニングデータ | huggingface.co/datasets/Eason0438/OmniRef-training | 約14K サンプルでトレーニング完了 |
| 評価ベンチマーク | huggingface.co/datasets/Eason0438/OmniRef-Bench | 395件の複数参照サンプル |
| 論文 | arxiv.org/abs/2606.26947 | ECCV 2026 Oral |
💡 ヒント:トレーニングのデータ効率は非常に高く、わずか約 14K サンプル で SFT+RL の一連のフローを実行できます。VRAM と時間の予算に優しい設計です。
始める前の準備
- ハードウェア:NVIDIA GPU(PyTorch + CUDA 環境)が必要。トレーニング段階では VRAM 24GB 以上を推奨
- アカウント:GitHub(コード取得)+ Hugging Face(重みとデータセット取得)
- 基盤モデル:Qwen-Image-Edit-2511(FLUX.2-klein-base-9B もサポート)
- 所要時間の目安:推論のみなら10分。SFT+RL のフルトレーニングはデータ規模次第
ステップ1:conda 環境を作成する
リポジトリは SFT と RL それぞれに独立した環境設定(Python 3.11 ベース)を用意しています。目的に応じて選んでください。
重みを使って推論だけしたい場合(入門読者に推奨)——SFT 環境だけで十分です:
conda create -n dyref_sft python=3.11 -y
conda activate dyref_sft
cd DyRef/sft
pip install -e .
SFT + RL の完全トレーニングを走らせたい場合——両方の環境をインストールします:
# SFT 環境(同上)
conda create -n dyref_sft python=3.11 -y && conda activate dyref_sft && cd DyRef/sft && pip install -e .

# RL 環境(deepspeed 付き)
conda create -n dyref_rl python=3.11 -y && conda activate dyref_rl && cd DyRef/rl && pip install -e .[deepspeed]
💡 ヒント:RL 環境は
pip install -e .[deepspeed]でインストールします。Stage 2 のトレーニングが分散最適化に DeepSpeed を使うためです。
ステップ2:LoRA 重みを取得する
Hugging Face から公式公開済みの LoRA 重みを取得し、ローカルの指定パスに置きます(README のデフォルトでは HF Hub から自動ダウンロードされますが、中国国内のユーザーは先に手動でローカルへダウンロードしておくことを推奨):
# 重みのURL
# https://huggingface.co/Weistrass/Qwen-Image-Edit-2511-DyRef
これは Qwen-Image-Edit-2511 の基盤モデルに重ねる LoRA アダプタで、完全なモデル重みよりはるかに小さいサイズです。
ステップ3:複数参照の推論を動かす(最速の入口)
「複数参照の画像編集」の効果を試すだけでトレーニングは不要、という場合は、公式の推論スクリプトを直接実行します:
conda activate dyref_sft
python model_inference/Qwen-Image-Edit-2511.py
このスクリプトは基盤モデル + LoRA 重みをロードし、複数の参照画像(被写体 / 背景 / ポーズ / ライティング / スタイルの各役割)を受け取り、すべての制約を統合した合成画像を1枚出力します。まずは OmniRef-Bench の395サンプルからいくつかの組み合わせを選んで試し、環境が正しいことを確認するのがおすすめです。
ステップ4(任意):Stage 1 SFT の教師ありファインチューニング
自分の複数参照データでファインチューニングしたい場合は、SFT 段階に入ります。公式はすぐ使えるトレーニングスクリプトを提供しています:
cd DyRef/sft
bash all_scripts/Qwen-Image-Edit-2511_lora.sh
この段階では複数参照データ上で LoRA ファインチューニングを行い、モデルにまず「複数枚の参照画像の制約を読み解く」ことを覚えさせます。トレーニングデータは公式公開の OmniRef-training(約14K サンプル)をそのまま使っても、自分の複数参照データセットに差し替えても構いません。
ステップ5(任意):Stage 2 RL 強化学習(核心のイノベーション)
ここが、DyRef を普通の LoRA ファインチューニングと分ける部分です。Stage 2 では強化学習による追加最適化を行い、2つの動的報酬メカニズムを提案しています:
- DRS(Discriminative Reward Scaling、判別的報酬スケーリング)
- DAR(Difficulty-aware Advantage Reweighting、難易度考慮のアドバンテージ再重み付け)
両者が解決するのは同じ痛点です:RL トレーニングにおいて、報酬信号が簡単なサンプルと難しいサンプルの間で識別度を持たない——簡単なサンプルは満点、難しいサンプルは全滅となり、モデルは難しい複数参照の組み合わせに対する繊細な制御を学べません。DRS + DAR は報酬信号を難易度グラデーション上でより「引き離し」、モデルは難しい組み合わせをより堅牢に学習します。
公式の RL スクリプトを実行します:
conda activate dyref_rl
cd DyRef/rl
bash scripts/qwen2511-gdpo-rank64-add2k5-csd-siglipv2_flat-sigmoid0.65-focal_loss.shスクリプト名の情報密度は非常に高いです:rank64 は LoRA ランク、siglipv2 は報酬に使う視覚エンコーダ、sigmoid0.65 と focal_loss は DAR の難易度考慮の実装ディテールです。
検証結果
トレーニング完了後、OmniRef-Bench のテストセットで複数参照の一貫性を検証します:
# benchmark/ ディレクトリで評価を実行
cd DyRef/benchmark
# 公式の benchmark スクリプトは395サンプル、5種類の参照タイプ × 10種類の組み合わせを実行する
成功の目安:被写体の一貫性(人物の顔が漂わない)、ポーズのアライメント、スタイルの忠実度の3指標が、基盤の Qwen-Image-Edit-2511 に比べて明確に向上し、論文が報告する「Nano Banana Pro と対等、Seedream 4.5 を上回る」水準に達することです。
よくある質問
- VRAM が足りない場合は:SFT は LoRA(デフォルト設定)なので VRAM の負荷は小さめです。RL 段階では DeepSpeed ZeRO-2/3 のシャーディングを有効にします。入門ユーザーはまずステップ3の推論だけ走らせるのがおすすめです。
- 自分の複数参照データがない場合は:公式の OmniRef-training(約14K サンプル)を使えば論文の結果をそのまま再現できます。
- 基盤モデルを変えたい場合は:リポジトリは FLUX.2-klein-base-9B もサポートしており、
model_inference/ディレクトリの対応するスクリプトを参照してください。 - トレーニングスクリプト名が長すぎて読めない場合は:あのパラメータ列は DyRef 論文の核心的なハイパーパラメータ(rank、sigmoid、focal_loss など)です。変更する前に、まず論文の RL 部分を読んでから手を付けることを推奨します。