
FuseSearch:40 億パラメータの小型モデルが商用大規模モデルのコード特定能力を圧倒する仕組み
Ant Group の ACL 2026 新作 FuseSearch-4B。適応的並列検索戦略により、コード特定タスクで Claude Haiku 4.5 と同等の性能を達成。速度 93.6% 向上、Token 68.9% 削減
FuseSearch:40 億パラメータの小型モデルが商用大規模モデルのコード特定能力を圧倒する仕組み
Ant Group の ACL 2026 新作 FuseSearch-4B。適応的並列検索戦略により、コード特定タスクで Claude Haiku 4.5 と同等の性能を達成。速度 93.6% 向上、Token 68.9% 削減
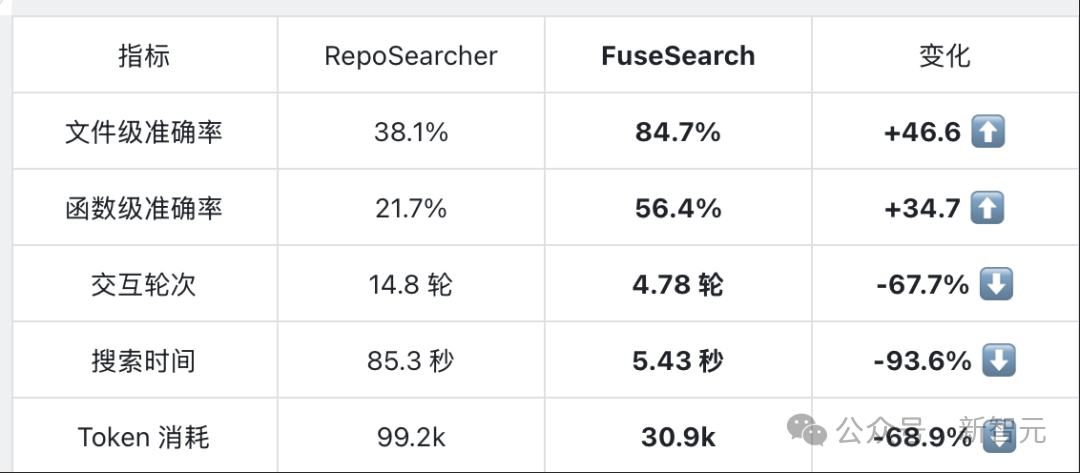
AI コーディングの実利用では、計算リソースの 50% 超がコード検索・特定の工程で消費されています。Ant Group の FuseSearch-4B は直感に反する解決策を提案しました:パラメータを積む必要はなく、モデルに「いつ、どれだけ検索すべきか」を学ばせるだけでよい。このわずか 40 億パラメータのオープンソースモデルは、SWE-bench Verified で 84.7% のファイルレベル F1 に達し、Claude Haiku 4.5 の特定能力に匹敵します。
問題:なぜコード特定はこれほどコストがかかるのか
AI コーディング Agent が数十万行のコードを持つ大型プロジェクトで、どのファイル・どの関数を変更すべきかを探すとき、既存のアプローチには 2 つの流派それぞれに課題があります:
- 単段階直列検索:各ラウンドで 1 つのツールだけを呼び出して範囲を徐々に絞り込み、ラウンド消費が驚異的
- 無思考な並列:毎ラウンド固定で 8 つのツールを呼び出すと、34.9% 超の冗長呼び出しが発生し、ノイズ信号を持ち込む
核心的な矛盾はここにあります:並列が少なすぎると情報が足りず、多すぎるとリソースを浪費する。FuseSearch の洞察は——重要なのはどれだけ並列にするかではなく、いつ多めに並列し、いつ控えめに並列するか、です。
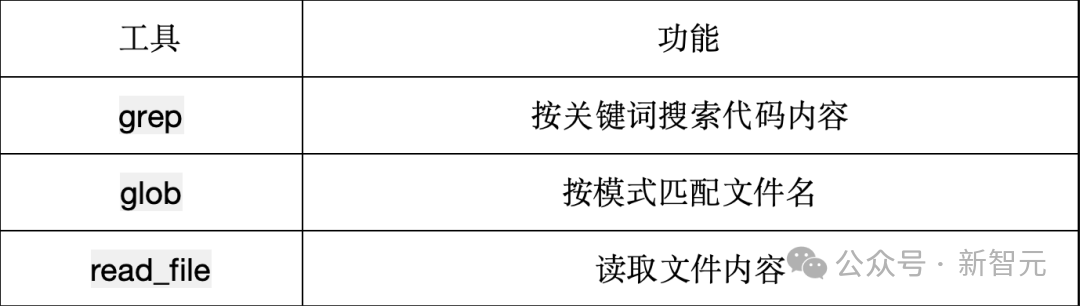
FuseSearch は 3 つの読み取り専用ツールしか使いません:glob でファイルを探し、grep で内容を検索し、read_file で詳細を読みます。
核心的な革新
3 本の「スイスアーミーナイフ」
FuseSearch のツールボックスは極めて抑制的で、3 つの読み取り専用ツールしかありません:
- glob:ファイル名パターンでファイルを検索
- grep:ファイル内容を検索
- read_file:ファイルの詳細を読み取る
依存ゼロで、すぐに使えます。コード知識グラフも構文パーサも不要です。言語非依存で、Python と Java のリポジトリどちらでも使えます。
「情報利得」で検索品質を定量化
論文が初めて提案する**ツール効率(Tool Efficiency)**指標:
情報利得 = 新しく発見されたコード実体数 / 総返却コード実体数
効率が高いほど毎回の検索が新しい領域を探索していることを示し、低いほど重複作業をしていることを示します。この指標は「検索品質」を定量化可能な訓練目標に直接変えました。
2 段階訓練
段階 1:教師あり微調整(SFT)
233 個の高品質 GitHub リポジトリから約 21,000 件の issue-patch ペアを抽出し、Kimi-K2-Instruct で検索軌跡を生成。二重のふるい基準:特定 accuracy >= 0.8、ツール効率 >= 0.5。最終的に約 24,000 件の候補から約 6,000 件の高品質データを精選しました。
段階 2:強化学習(RL)
報酬関数の設計が極めて精妙です:
報酬 = 0.8 x 特定精度 + 0.2 x (特定精度 x ツール効率)あの積項に注目してください:「正しく見つかる」と「無駄なく検索する」が同時に満たされて初めて追加報酬を得られます。特定が完全に誤っていれば、効率がどれだけ高くても報酬はゼロ——モデルは「効率よく間違える」ことはできません。
訓練結果:まず網を打ち、後に引き締める
RL 訓練を経て、モデルは自動的に「ベテラン運転手」的な適応検索パターンを獲得しました:
- 初期段階:広く網を打ち、高並列度でコードベースを素早くカバー
- 中期段階:徐々に絞り込み、手がかりに向かって掘り下げる検索
- 後期段階:精確に検証し、低並列度で重要な位置を確認
この「まず広く、後に深く」というパターンは、報酬信号からモデルが自ら学んだもので、人工ルールは一切ありません。
実験データ
核心指標(SWE-bench Verified、386 インスタンス)
| 指標 | FuseSearch-4B | vs. 従来手法 |
|---|---|---|
| ファイルレベル F1 | 84.7% | 正解率 2 倍 |
| 速度 | 93.6% 高速 | 速度 16 倍 |
| Token 消費 | 68.9% 低減 | 約 70% 節約 |
商用クローズド大規模モデルとの比較
ローカルデプロイ可能な 4B のオープンソース小型モデルが、特定能力で Claude Haiku 4.5 と同等であり、しかもより速く、より省コストです。
下流 Agent への接続
FuseSearch-4B を Kimi-K2-Instruct の「前方検索エンジン」として使うと、修復効果に影響を与えず、コストを直接半分近く削減できます。
実用情報
- 論文タイトル:FuseSearch: Learning Adaptive Parallel Execution for Efficient Code Localization
- 採録会議:ACL 2026 Findings
- 著者所属:Ant Group
- 論文リンク:https://github.com/sxthunder/FuseSearch
- デプロイコスト:依存ゼロ、3 つの読み取り専用ツール、任意のコードリポジトリに即時デプロイ可能
適用シーン
- AI コーディング Agent 開発者:コード検索の Token 消費とレイテンシを下げる必要がある
- 企業レベルのコード修復:コストとレイテンシに敏感な産業級シーン
- ローカルデプロイの需要:4B パラメータはコンシューマー GPU で実行可能