
Gemma 4 12B:16GBノートPCでマルチモーダルAIモデルを動かす
Googleが120億パラメータのオープンソースマルチモーダルモデルを発表。テキスト、画像、音声入力に対応し、9GBのVRAMがあればノートPCでローカル実行できます。Apache 2.0ライセンス。
Gemma 4 12B:16GBノートPCでマルチモーダルAIモデルを動かす
Googleが120億パラメータのオープンソースマルチモーダルモデルを発表。テキスト、画像、音声入力に対応し、9GBのVRAMがあればノートPCでローカル実行できます。Apache 2.0ライセンス。
ノートPCに16GBのVRAMまたはユニファイドメモリがあれば(たとえばM1/M2/M3 ProのMacBook)、文字、画像、音声を同時に理解できるAIモデルを今すぐ動かせます。Googleが発表したばかりのGemma 4 12Bはまさにそのために生まれました。
Gemma 4 12Bとは
Gemma 4 12BはGoogle DeepMindが最新でオープンソース化したマルチモーダル大規模モデルで、パラメータ量は120億です。Gemma 4シリーズの一員で、エッジデバイス向けのE4Bと、より能力の高い26BのMixture of Expertsモデル(MoE)の中間に位置します。
いくつかの重要なデータ:
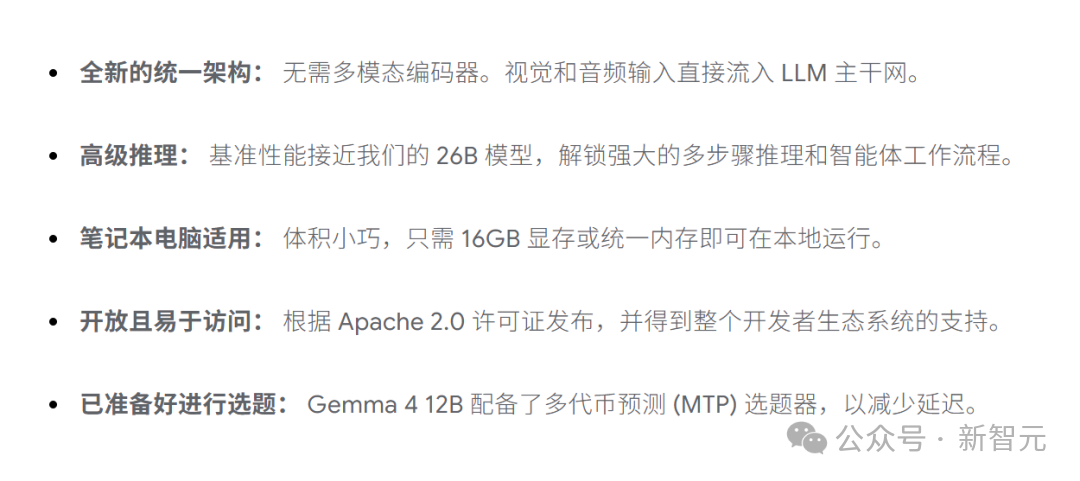
- 120億パラメータ、9GBのVRAMで実行可能(完全なモデルで約16GBのメモリ使用量)
- マルチモーダル入力:テキスト、画像、音声をネイティブサポートし、追加のエンコーダが不要
- Apache 2.0ライセンス:商用利用可能で、Googleへの支払いは不要
- 1.5億回ダウンロード:Gemma 4全シリーズの累計ダウンロード数
- Google AI Edge対応:Macデスクトップでのローカル実行をサポート
なぜノートPCで動くのか
従来のマルチモーダルモデルは、非テキスト入力を処理するために独立したビジョンエンコーダとオーディオエンコーダを必要とし、これらのエンコーダは追加のレイテンシとメモリオーバーヘッドをもたらします。Gemma 4 12Bは「エンコーダーレス」アーキテクチャを採用しました:
ビジョン処理:元の27層のビジョンTransformerを、わずか35Mパラメータの超軽量埋め込みモジュールで置き換えました。生のピクセルは1回の行列乗算と座標ルックアップを経て、LLMのバックボーンネットワークに直接入ります。
音声処理:オーディオエンコーダを完全に除去しました。16kHzの生音声信号は40ミリ秒の断片に切り分けられ、線形投影によってテキストトークンと同じ次元空間へ直接マッピングされます。
これは、ビジョン、音声、テキストが同じ重みセットを共有することを意味します。LoRAファインチューニングでは、1回のフォワードパスで全モダリティを同時に更新できます。
実際のパフォーマンス
RTX 4090での実測比較(タスク:サードパーティライブラリに一切依存しない、純手書きのHTML5 Canvas物理アニメーション):
| 指標 | Gemma 4 26B-A4B | Gemma 4 12B |
|---|---|---|
| VRAM使用量 | 15GB | 9GB |
| 生成トークン数 | 6.9k | 8.9k |
| 速度 | 138 tok/s | 80 tok/s |
| タスク完成度 | すべて合格 | すべて合格 |
12Bは半分未満のVRAMで、ほぼ同等の品質をたたき出しました。16GBメモリのノートPCユーザーにとって、これは理想的なローカルマルチモーダルモデルです。
ローカルで実行する方法
Ollamaを使う
ollama run gemma4:12bLM Studioを使う
LM Studioで「gemma-4-12b」を検索すればダウンロードして実行できます。
LiteRT-LMを使う(コマンドライン)
litert-lm import --from-huggingface-repo=litert-community/gemma-4-12B-it-litert-lm gemma-4-12B-it.litertlm gemma4-12b
litert-lm serve
Google AI Edge Galleryアプリを使う
GoogleはすでにAI Edge GalleryをmacOSプラットフォームに公式移植し、Apple SiliconのGPU向けに低レベル最適化を施しています。チャットバブルの中でPythonコードを直接実行してグラフを描け、すべてオフラインで動きます。
誰に向くか
- フロントエンド開発者:画像を見て、音声を聞いて、コードを書けるAIアシスタントをローカルで動かしたい
- プライバシー重視シーン:医療、法律などデータをローカルから出せないシーン
- 個人開発者:ゼロコストのマルチモーダル推論能力
- エッジデバイス開発者:コンシューマー向けハードウェアでAIアプリを構築
注意点
- Gemma 4 12Bはモデルであってアプリではありません。OllamaやLM Studioなどのツール経由で実行する必要があります
- 「ローカル実行」とはモデルがあなたのPC上で動くという意味で、効果はハードウェア構成に依存します
- 26B版と比べると、12Bは複雑な推論タスクではある程度差がありますが、日常使用には十分です
モデルのダウンロード先:https://huggingface.co/google/gemma-4-12b-it
関連記事
DeepSeek V4 実測:Agentコーディング能力が躍進、API料金と始め方ガイド
DeepSeek V4がオープンソースで公開。1.6Tパラメータ、100万tokenコンテキストを擁し、Agentコーディング能力はOpus 4.6に迫ります。API料金、実測ケース、入手先も併記。
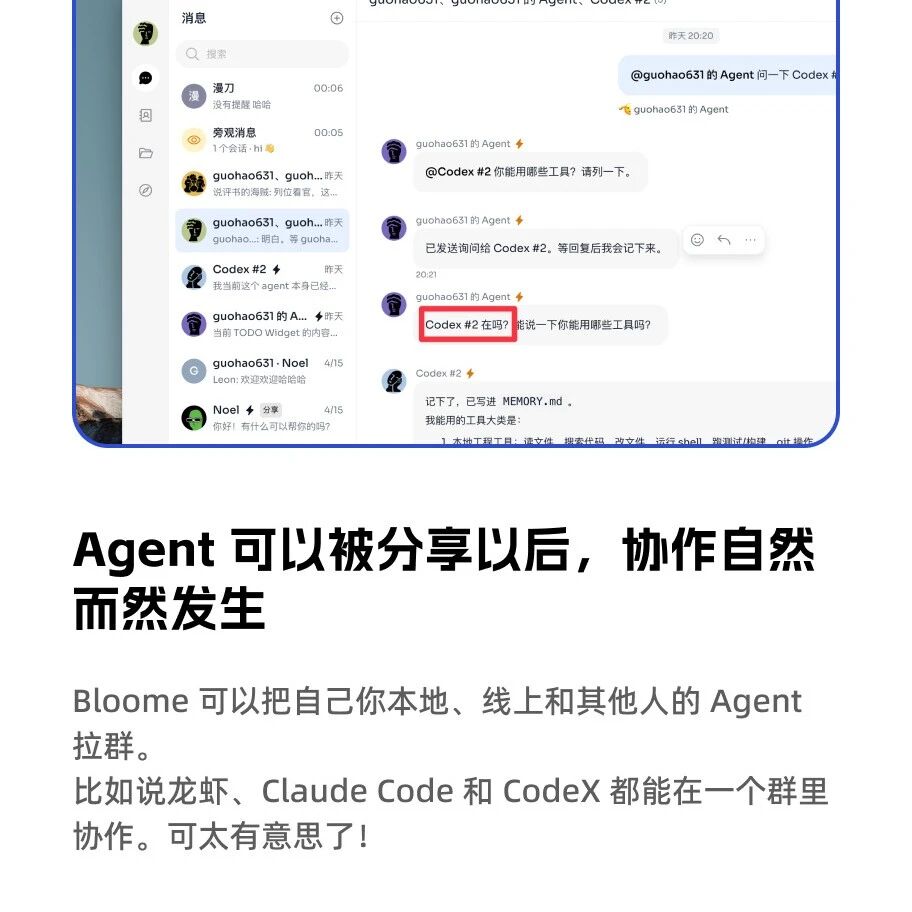
Bloome:ローカルとクラウドのAgentをグループチャットで協業させる
BloomeはローカルAgent(OpenClaw、Claude Code、Codex)とクラウドAgentのグループ協業に対応。ワンクリックでAgentを追加でき、QRコード共有、オープンなAPIで課金は不要です。
GPT-Image-2 徹底実測:マーケティング画像からゲームUIまで、一言で完結
GPT-Image-2が正式リリース。複雑なプロンプトなしで、高品質なマーケティングポスター、知識カード、ゲームUI、ウェブデザイン案を生成できます。6つの主要シーンを全面的に実測。
GPT-Image-2 実践プロンプトガイド:一言で思い通りの画像生成
GPT-Image-2 の実用的なプロンプトテンプレートを、運営画像・商品ポスター・ゲームUI・解説図など 8 大シーンに分けて整理した、コピーしてすぐ使える実践ガイドです。