
Gemma 4 オープンソース実測:31B が世界トップ3入り、2B はスマホでオフライン Agent 実行
Google が Gemma 4 シリーズをリリース。Apache 2.0 による真のオープンソースで、2B から 31B までを網羅し、スマホでオフライン実行できるマルチモーダル Agent です。ローカルデプロイガイド付き。
Gemma 4 オープンソース実測:31B が世界トップ3入り、2B はスマホでオフライン Agent 実行
Google が Gemma 4 シリーズをリリース。Apache 2.0 による真のオープンソースで、2B から 31B までを網羅し、スマホでオフライン実行できるマルチモーダル Agent です。ローカルデプロイガイド付き。
一言でいうと
Gemma 4 は、Google DeepMind が Gemini 3 と同系統の技術をもとに作ったオープンソースモデルシリーズです。4つのサイズ(E2B/E4B/26B MoE/31B Dense)がすべて Apache 2.0 ライセンスを採用しており、商用利用・改変・製品への組み込みが可能です。
主要データ
まず最も重要な数字から見ていきましょう:
| モデル | 実効パラメータ | コンテキストウィンドウ | Arena AI ランキング | 典型的なデプロイ場面 |
|---|---|---|---|---|
| E2B | 2B | 128K | - | スマホ / IoT / Raspberry Pi |
| E4B | 4B | 128K | - | モバイル / Jetson Nano |
| 26B MoE | 3.8B 有効化 | 256K | オープンソース第6位 | 低遅延 Agent / 高速推論 |
| 31B Dense | 31B | 256K | オープンソース第3位 | ワークステーション / シングル H100 |
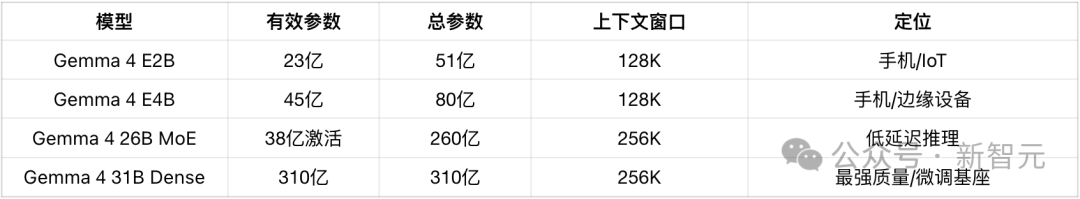
なぜこの順位が重要なのか? 31B Dense の Arena AI Elo スコアは 1452 で、前にいるのは 745B の GLM-5 と 1T の Kimi K2.5 です。Gemma 4 は 31B のサイズで千億パラメータ級の勝負の土俵に食い込みました。パラメータ効率が極めて高いのです。
前世代からの飛躍
Gemma 3 27B と比較した、Gemma 4 31B の3つのコアシーンにおける向上幅:
- 数学推論(AIME 2026):20.8% -> 89.2%、4倍の向上
- コード能力(LiveCodeBench v6):29.1% -> 80.0%、世代を超える断層的な進化
- Agent ツール呼び出し(tau2-bench):6.6% -> 86.4%、使えないレベルからベンチマーク級へ

エッジの能力:スマホでオフライン Agent 実行
E2B と E4B は、今回のリリースで最も注目に値する部分です。
この2つのモデルは、Google Pixel チーム、Qualcomm、MediaTek との綿密な連携で最適化されており、Pixel スマホ、Raspberry Pi、Jetson Orin Nano 上で完全オフラインで実行でき、遅延はほぼゼロです。削減版ではなく、完全なマルチモーダル Agent 能力です:
- 画像と動画の入力をネイティブサポート
- ネイティブな音声入力(E2B/E4B 専用)
- ネイティブな関数呼び出し、JSON 構造化出力、システム指示
- 140以上の言語サポート
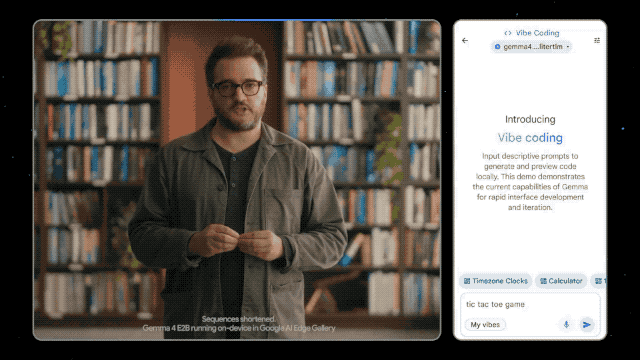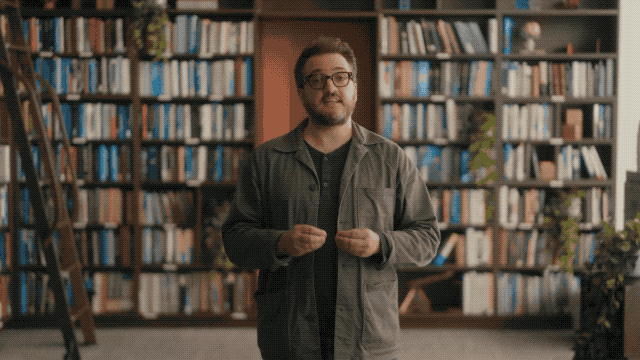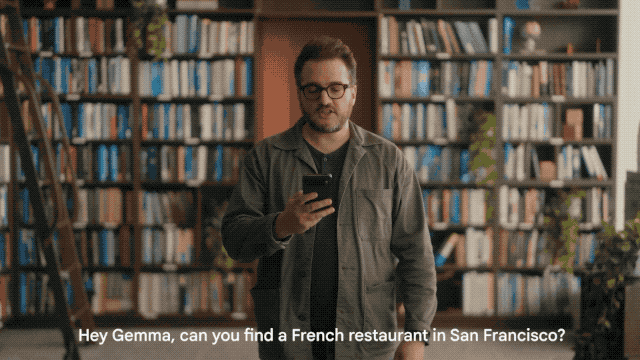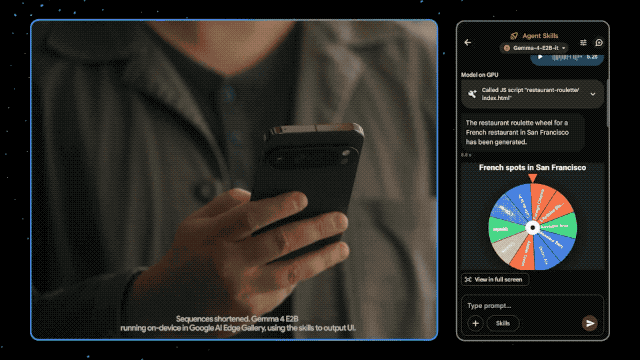
直感的な比較をひとつ:E2B は科学知識ベンチマーク GPQA Diamond で 43.4% を獲得し、前世代の Gemma 3 27B は 42.4% でした。スマホの 2B モデルが、前世代 27B のデスクトップモデルに追いついたのです。
Google はさらに、Android アプリ Google AI Edge Gallery(Google Play からダウンロード可能)をリリースしました。Skills の体験ゾーンを内蔵しており、スマホ上で直接 Agent モードを試せます。
アーキテクチャのハイライト
Gemma 4 は派手な概念を積み上げるのではなく、実証済みのいくつかの技術を最適な形で組み合わせています:
レイヤーごとの埋め込み(PLE) -- E2B/E4B 専用。デコーダーの各層に独立した低次元の埋め込みテーブルを備え、層数を増やさずにパラメータ利用効率を大幅に向上させます。
共有 KV キャッシュ -- 最後の N 層が前の層の KV テンソルを再利用し、推論時の VRAM と計算量を削減します。長いコンテキストの生成でとりわけ恩恵があります。
交互注意力機構 -- 局所スライディングウィンドウとグローバル注意を交互に使い分け、速度と深い認識を両立します。
ローカルデプロイガイド
方法1:Ollama(最も手軽に始められる)
# 安装 Ollama 后直接拉取
ollama run gemma4:31b

# 26B MoE 版本(更快)
ollama run gemma4:26b-moe

# 端侧小模型
ollama run gemma4:e4b
方法2:Hugging Face + Transformers
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "google/gemma-4-31B-it"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    torch_dtype="auto"
)
モデルの重みは Hugging Face、Kaggle、Ollama で公開済みです。リリース初日から対応している主要フレームワークは Transformers、vLLM、llama.cpp、MLX、Unsloth、SGLang、Keras です。
ハードウェア要件の目安
| モデル | bfloat16 VRAM | 量子化後(4bit)VRAM |
|---|---|---|
| 31B Dense | ~62 GB(シングル H100 80GB) | ~18 GB(コンシューマー GPU) |
| 26B MoE | ~52 GB | ~15 GB |
| E4B | ~8 GB | ~3 GB |
| E2B | ~4 GB | ~1.5 GB |
Apache 2.0 の実質的な意味
今回は「オープンウェイト」ではなく、本当の Apache 2.0 オープンソースです:
- 商用利用、改変、再配布が完全に自由
- 特許保護の仕組みを内蔵
- 独自条項なし、グレーゾーンなし
- ハードウェア製品や業務デバイスに合法的に組み込み可能
Hugging Face CEO の Clément Delangue 氏はこれを「重要なマイルストーン」と評しました。2024年2月の初代リリースから現在までに、Gemma シリーズの総ダウンロード数は4億回を超え、コミュニティ派生のバリアントは10万を超えています。
Toolin's Take
誰に向いているか:
- ローカルデプロイなど、データをデバイスの外に出さない運用が必要な企業(医療、金融、工業)
- エッジデバイスで Agent を動かしたいモバイル開発者
- コストパフォーマンスの高いオープンソース基盤でファインチューニングしたい AI エンジニア
誰に向いていないか:
- 最強の総合能力が必要なユーザー(Claude Opus 4.6、GPT-5 が依然として最高水準)
- 複雑なマルチモーダルタスク(Simon Willison の実測:小規模モデルは複雑な視覚生成ではまだ不足あり)
核心的な強み: Apache 2.0 + エッジでのマルチモーダル + パラメータ効率。この3つの組み合わせは、現在の市場に他にありません。
制限: MoE モデルは有効化されるパラメータが 3.8B とはいえ、26B すべてのパラメータをメモリに読み込む必要があります。エッジモデルの実際のマルチモーダル能力はまだ改良の途中です。
関連リンク:
- Hugging Face モデルコレクション:https://huggingface.co/collections/google/gemma-4
- 公式テックブログ:https://blog.google/innovation-and-ai/technology/developers-tools/gemma-4/
- Google AI Edge Gallery:Google Play で検索してダウンロード
関連記事
Baidu Miaoda 3.0 + DuMate 実測:たった一人の AI カンパニー
Baidu Miaoda 3.0 と DuMate の 2 つの AI ツールを徹底実測。ノーコードでのペット出張給餌プラットフォーム構築から、カスタマーサポート・マーケティング・データ分析の自動処理まで、一人会社の全業務フローを完走させます。
Codex モバイル版完全ガイド:いつでもどこでもリモートプログラミング
OpenAI Codex が ChatGPT スマホアプリに正式登場。iOS・Android に対応し、無料ユーザーでもスマホから PC 版 Codex をリモート操作してプログラミング作業を実行できます。