
Hallo-Live:リアルタイム・テキスト駆動の音声付き動画デジタルヒューマン
オープンソースのリアルタイムデジタルヒューマン生成ソリューション。テキスト入力だけで発話動画と音声を同期生成し、20.38 FPSのスループットと0.94秒のエンドツーエンド遅延を実現します。
Hallo-Live:リアルタイム・テキスト駆動の音声付き動画デジタルヒューマン
オープンソースのリアルタイムデジタルヒューマン生成ソリューション。テキスト入力だけで発話動画と音声を同期生成し、20.38 FPSのスループットと0.94秒のエンドツーエンド遅延を実現します。
テキスト駆動の音声付き動画デジタルヒューマンは、「生成できる」から「リアルタイムに対話できる」へと進みつつあります。上海創智学院、復旦大学などの機関による Hallo-Live プロジェクトは、2枚の NVIDIA H200 GPU 上で 20.38 FPS のスループットと 0.94 秒のエンドツーエンド遅延を実現しながら、教師モデルに迫る視覚品質と音声・映像の同期効果を保っています。
論文アドレス:arxiv.org/abs/2604.23632 コードアドレス:github.com/fudan-generative-vision/Hallo-Live
Hallo-Live とは何か
従来の音声駆動デジタルヒューマンはリップシンクだけで済みましたが、テキスト駆動の方式は2つのことを同時にこなす必要があります。まずテキストの中の人物、シーン、語調を「理解」し、それから対応する発話動画と音声を同期して生成します。口の形、発音、表情、さらには上半身の動きまで、すべて同じタイムラインに厳密に揃えなければなりません。
教師モデル Ovi と比べた Hallo-Live の主要指標:
| 指標 | Hallo-Live | 向上 |
|---|---|---|
| スループット | 20.38 FPS | 16.0倍に向上 |
| エンドツーエンド遅延 | 0.94 秒 | 99.3%低下 |
アニメ調、実写人物、複数人シーンに対応しており、GitHub でオープンソース化されています。
コア技術
非同期双ストリーム拡散(Asynchronous Dual-Stream Diffusion)
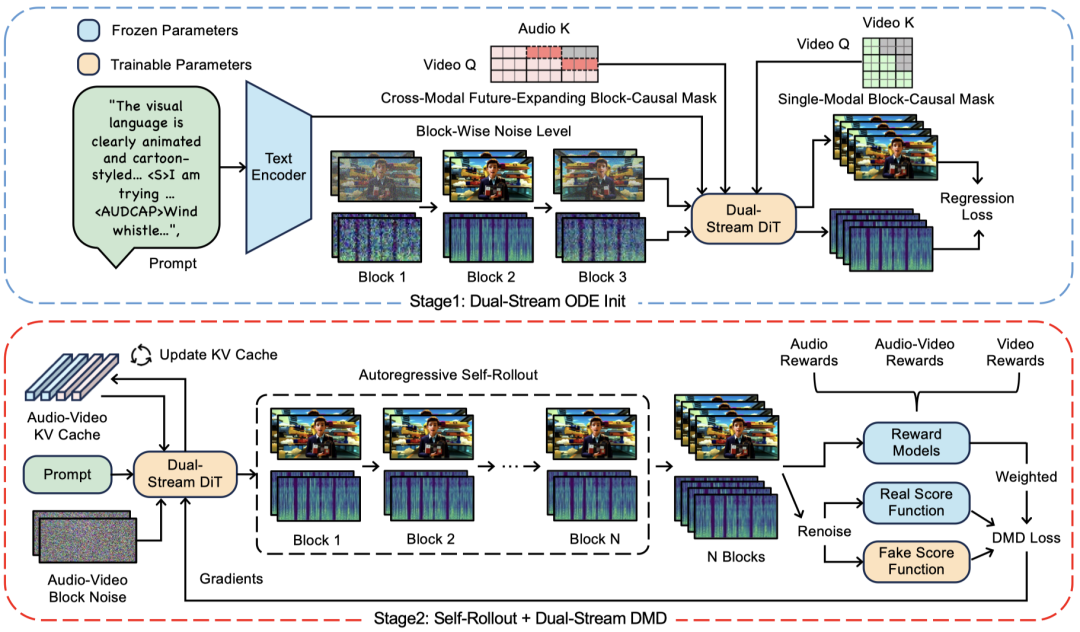
Hallo-Live の訓練は2段階に分かれます:
- Stage 1 -- Dual-Stream ODE Init:モデルに異なる noise level の音声・映像 blocks を同時に入力し、単一モーダルおよびクロスモーダルの Block-Causal Mask に基づいて双ストリーム DiT を訓練
- Stage 2 -- Self-Rollout + Dual-Stream DMD:学生モデルが音声・映像の KV Cache に基づいて完全な音声・映像を自己回帰生成し、さらに音声・映像の同期に関連する reward を導入して few-step モデルへ蒸留
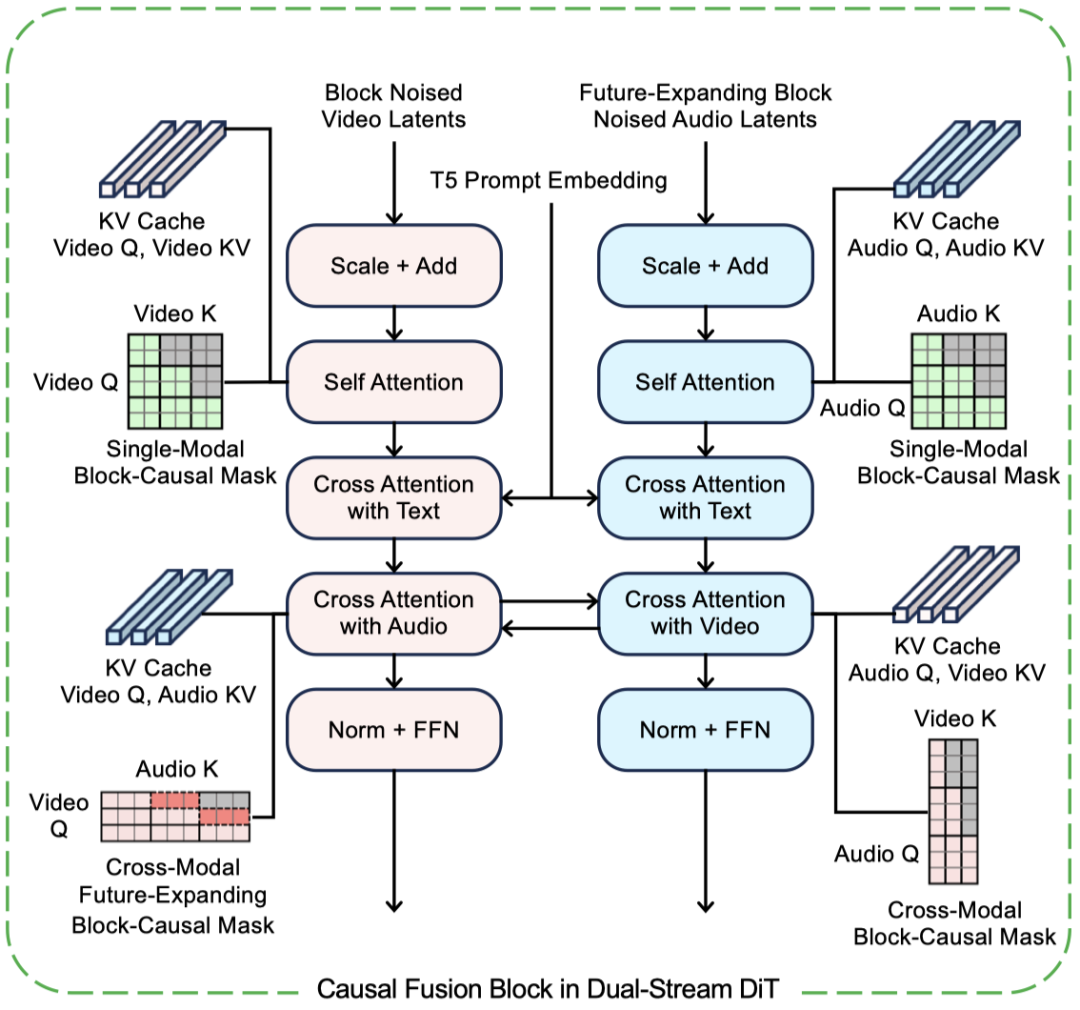
Causal Fusion Block
これは双ストリーム DiT の中核ユニットです。映像ストリームと音声ストリームはまずそれぞれ単一モーダルの Block-Causal Self-Attention を行い、次にテキスト条件を注入し、その後クロスモーダルな Block-Causal Cross-Attention で情報を交換して、ストリーミング生成のもとで音声と映像の融合を完了します。
Future-Expanding Attention
実際の発話では、唇の動きはしばしば音声に先んじて現れます(協同調音現象)。厳密に因果なブロック単位のアテンションは「短時間の未来」の音声情報を見られず、口の形が不自然になります。
Hallo-Live は映像から音声へのクロスモーダルアテンションを「非対称」にします:映像は現在のブロックに注視しつつ、音声のキー・値の範囲だけが前に少し拡張された look-ahead ウィンドウを持ち、いわば映像ストリームに短時間の「先読み領域」を与えます。
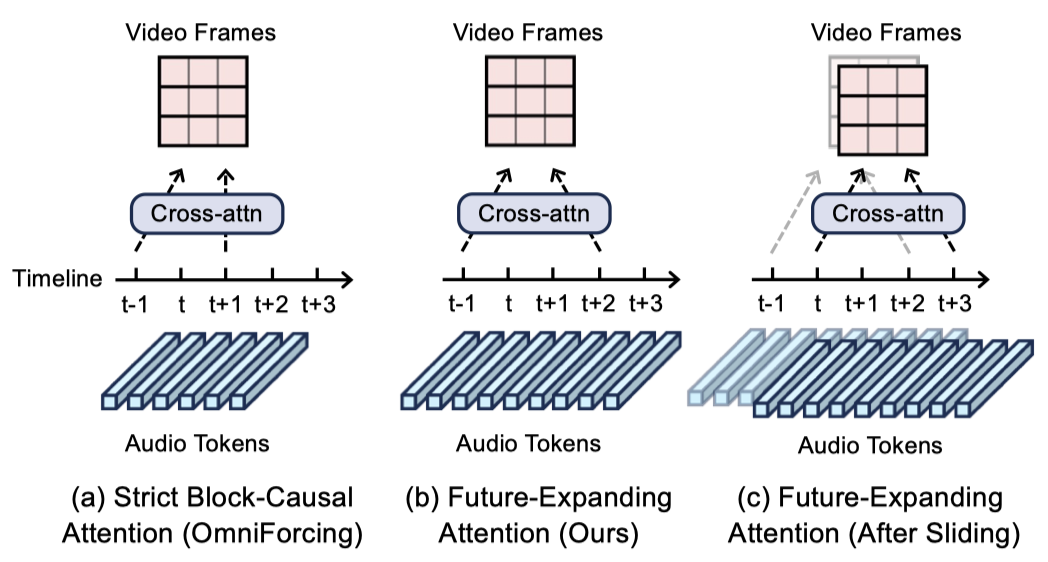
この未来の音声ブロックは最終出力ではなく一時的な経過ブロックで、音声品質を損ないません。
人間の嗜好に導かれた蒸留
少ステップ蒸留は高速化できますが、「平均化」という劣化を招きやすいものです -- 映像の質感がぼけ、音声がより機械的になり、音と映像の位置合わせがずれます。Hallo-Live は音声、映像、音声・映像の同期に関連する reward を導入して双ストリーム DMD 損失を重み付けし、高速化しつつ生成品質を維持します。
応用シーン
- バーチャル配信者 / デジタルヒューマンのライブ配信:リアルタイムのテキスト駆動で、ライブ配信のインタラクションに適する
- カスタマーサポートのデジタルヒューマン:テキスト入力から音声と動画の返信をリアルタイム生成
- コンテンツ制作:音声付きデジタルヒューマン動画をバッチ生成
- 教育/研修:デジタルヒューマンの講師を生成して講義を行う
技術要件
- ハードウェア:2枚の NVIDIA H200 GPU(論文の実験環境)
- 入力:テキスト + 参照人物画像
- 出力:同期した発話動画 + 音声
- 遅延:0.94秒エンドツーエンド
プロジェクトは GitHub でオープンソース化されており、デジタルヒューマン対話やリアルタイムストリーミング生成に取り組む研究者・開発者に適しています。
参考リンク:
関連記事
Claude Codeで70万行のコードを管理する実戦メソッド
CLAUDE.md、Skills、MCPの3層コンテキスト構築により、AIにあなたのコードベースを本当に理解させます。OpenAI Symphonyの並列オーケストレーション方式との比較つき。
Neat.Skill:AI Agentを使うほど賢くなるオープンソースツール
オープンソースのAgentドキュメント保守ツール。プロジェクトのドキュメント体系を自動レビューして繰り返し更新し、Claude Code、Codex、OpenCode、OpenClawの4プラットフォームに対応します。
10分で作るClaude AIデスクトップマスコット:オープンソースハードウェアチュートリアル
Anthropicがオープンソース化したClaude-Desktop-Buddyプロジェクト。深圳製M5StickC Plus開発ボードでAIデスクトップマスコットを作り、作業状態の表示や操作の承認ができ、18種類のアニメーションキャラを内蔵しています。
DeepSeek V4 実戦ガイド:コストはGPT-5.5のわずか10分の1
DeepSeek V4がオープンソースで公開されました。MITライセンス、100万tokenのコンテキスト、出力100万tokenあたりわずか3.48ドル。実測でコーディングコストが83%急減し、移行の最良のタイミングです。
GPT Image 2:OpenAI初の「考える」画像モデル
GPT Image 2は登場早々Arenaのテキストから画像生成ランキングで首位を獲得し、2位に241点差をつけました。ネイティブな思考能力を備え、文字レンダリングの正確率は99%、APIでの画像生成は1枚わずか$0.21です。