
Karpathy の LLM Wiki:RAGなしで個人ナレッジベースを構築する
Andrej Karpathy 氏が LLM Wiki ワークフローを紹介。Markdown ファイル + Claude Code で複雑な RAG アーキテクチャを置き換え、進化し続ける個人ナレッジベースを構築します。
Karpathy の LLM Wiki:RAGなしで個人ナレッジベースを構築する
Andrej Karpathy 氏が LLM Wiki ワークフローを紹介。Markdown ファイル + Claude Code で複雑な RAG アーキテクチャを置き換え、進化し続ける個人ナレッジベースを構築します。
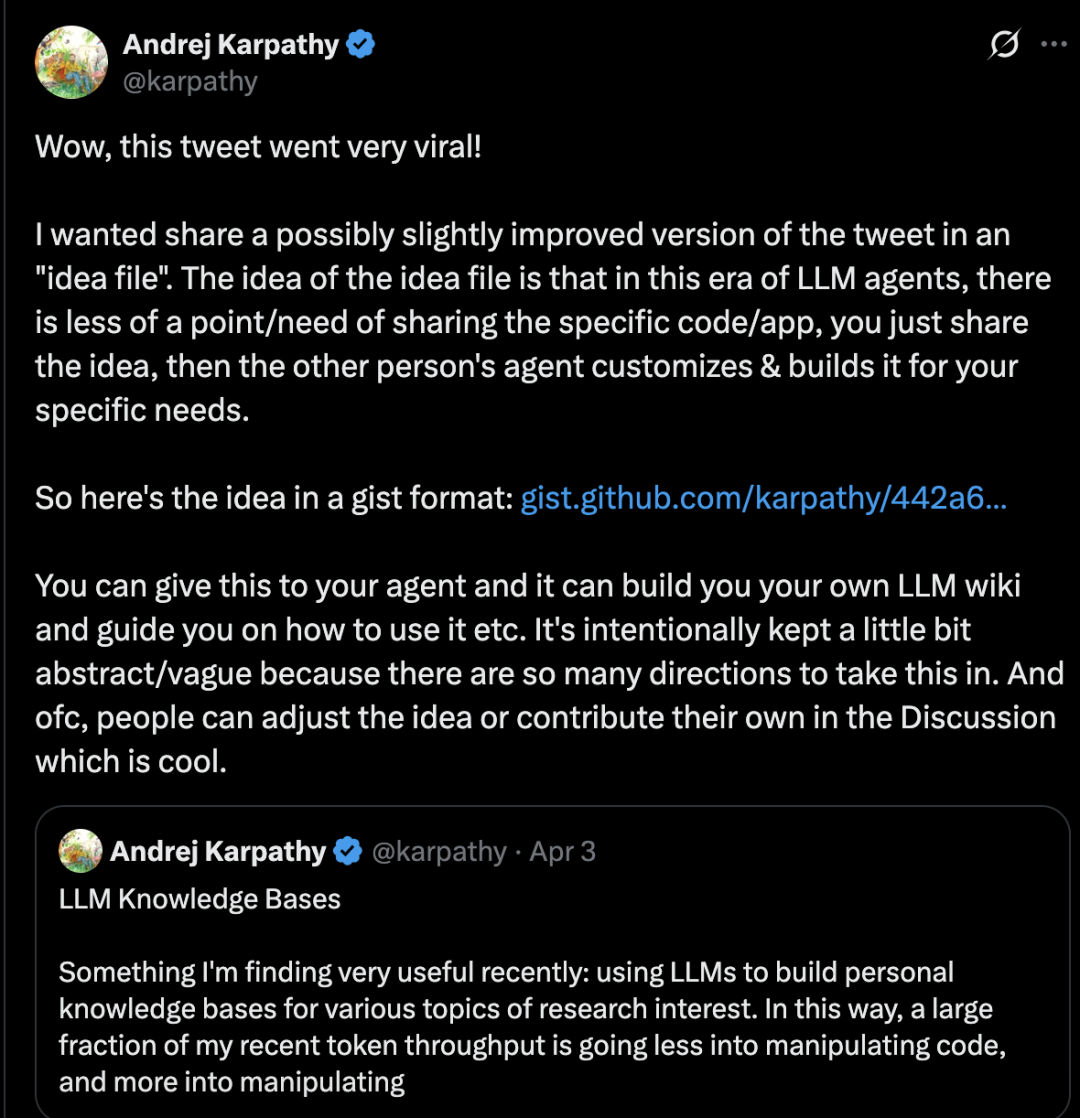
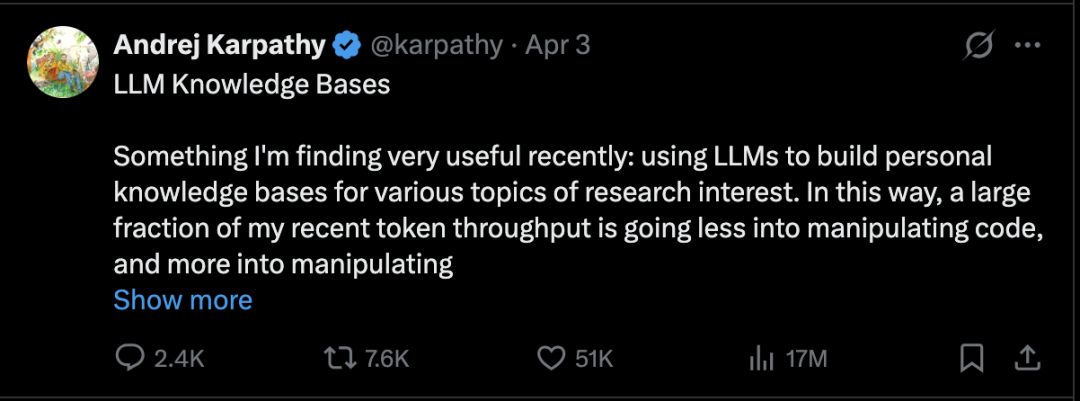
Andrej Karpathy 氏が最近、「LLM Wiki」と名付けたワークフローを紹介しました。大規模モデルを主にコード作成に使うのではなく、個人の研究関心を中心とした「進化し続けるナレッジベース」の構築にトークンを消費するというものです。システム全体のアーキテクチャは極めてシンプル――データベースも、ベクトル埋め込みも、サーバーも不要。必要なのは Markdown ファイルと高性能なモデルだけです。
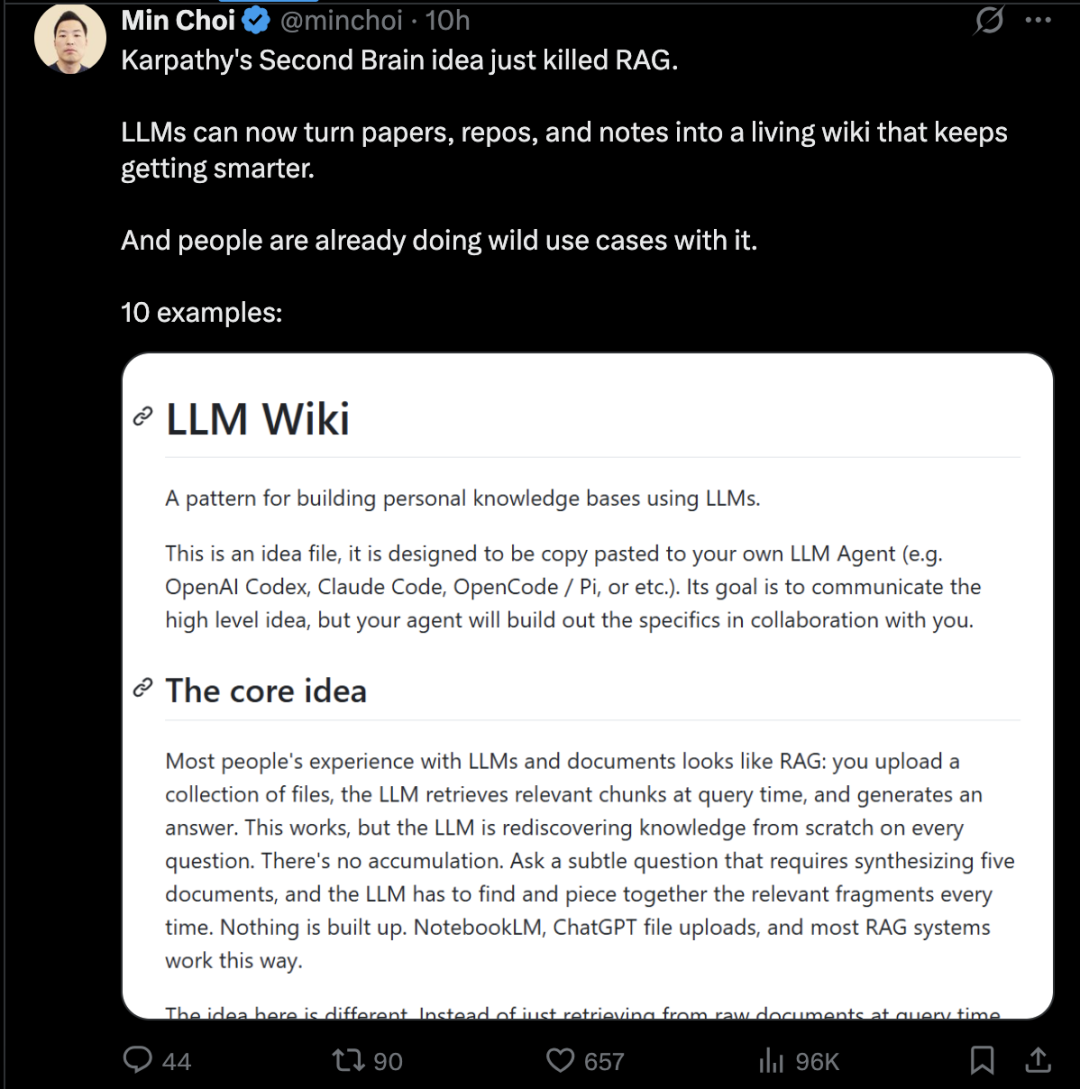
この発想の核心にある転換はこうです。中規模のデータセットであれば、LLM 自体がすでに十分な「自己検索」と「自己組織化」能力を備えており、複雑な RAG アーキテクチャはもはや必要ないかもしれない、と。
始める前の準備
- 必要なツール:Claude Code(コマンドラインツール)、Obsidian(任意、閲覧用フロントエンドとして)
- 技術要件:基本的なコマンドライン操作能力
- 所要時間の目安:初期構築は30分、継続的なメンテナンスは1日数分
- プロジェクトURL:https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
システムアーキテクチャ:3つのコンポーネント
Karpathy 氏のアーキテクチャは、次の3つのコアコンポーネントだけで構成されます:
1. Markdown ファイルのフォルダ
これがあなたのナレッジベースです。研究ノート、議事録、プロジェクトドキュメント、読書ノート、コード断片など、どんな内容でも含められます。
2. 各ファイルの内部構造を統一する
優れた LLM Wiki ドキュメントは一貫した内部フォーマット――タイトル、短い要約、タグトピック、そして本文――を採用しています。モデルはこの構造を利用して、関連情報をより速く特定します。
3. Claude Code をクエリインターフェースとして使う
ターミナルを開き、wiki フォルダに移動して Claude Code を起動し、質問します。Claude は必要なファイルを読み込み、総合的な回答を生成し、ノートの更新や追加まで行ってくれます。
具体的な手順
ステップ1:元データを収集する
raw/ ディレクトリを作成し、研究テーマに関連するすべての素材をどんどん放り込みます:
- 論文PDF
- 技術ブログ(Obsidian Web Clipper で Markdown に変換)
- GitHub リポジトリ
- データセット
- 画像などのマルチモーダルコンテンツ
この段階では構造設計は一切不要です。目標は元情報の完全性を最大化することです。
ヒント:Obsidian Web Clipper を使うと、ウェブページの内容を簡単に Markdown に変換でき、画像もローカルに保存されるため、LLM が視覚機能で参照しやすくなります。
ステップ2:LLM に素材を「コンパイル」させる
LLM を呼び出して raw/ ディレクトリの素材を増分的に「コンパイル」し、構造化された Wiki ページを生成します。コンパイルの過程には以下が含まれます:
- 要約とキーワードの生成
- 中核概念の識別
- 百科事典風のエントリの執筆
- 関連概念間のバックリンク作成
この Wiki は本質的に、AIが自動で執筆・保守するナレッジ百科システムであり、構造化された Markdown ファイルのコレクションとして保存されます。
ステップ3:Obsidian を閲覧フロントエンドとして使う
Karpathy 氏は Obsidian をこのシステムの「フロントエンド IDE」として使っています。ここでは以下のことができます:
- 元データの閲覧
- コンパイル済み Wiki の閲覧
- 派生した可視化コンテンツの確認
- Marp プラグインで Wiki 内容からプレゼンスライドを生成
核心原則:Wiki 内のすべてのデータは LLM が執筆・保守するものであり、自分が直接手を加えることはほとんどない。
ステップ4:LLM に直接質問する
ナレッジベースの規模が徐々に拡大したら(Karpathy 氏は約100記事・合計40万字のプロジェクトに言及しています)、複雑で体系的な質問を LLM エージェントに直接投げかけられます。
従来の RAG とは異なり、Karpathy 氏が依存するのは、LLM の Wiki に対する「内在的理解」能力です。モデルは自動保守されるインデックスと要約を通じて、効率的に情報を特定し総合的に分析します。
ステップ5:自動メンテナンスを設定する
定期的に LLM を呼び出して、Wiki 全体の「健康診断」を行います:
- データの不整合を検出
- 欠落情報の補完
- ウェブ検索による新しい資料の取り込み
- 潜在的な関連性を能動的に掘り下げ、新しい特集記事を生成
なぜ RAG が不要なのか
Karpathy 氏の手法と RAG の根本的な違いは発想にあります:
| 比較軸 | 従来の RAG | LLM Wiki |
|---|---|---|
| データ処理 | チャンク分割 + ベクトル埋め込み + ベクトルデータベース | Markdown ファイル + LLM が直接読解 |
| 検索方式 | 類似性検索 | LLM の内在的理解 + 構造化インデックス |
| 追跡可能性 | ベクトル埋め込みは「ブラックボックス」 | すべての記述を具体的な .md ファイルまで遡れる |
| メンテナンスコスト | ベクトルデータベースと埋め込みサービスが必要 | ファイルシステムだけでよい |
Karpathy 氏は Markdown ファイルを「唯一の信頼源」とみなしています。AI が行うすべての記述は特定のファイルまで遡れ、あなたはそれらのファイルを読み、編集し、削除できます。
拡張の方向性
Karpathy 氏が挙げる次の進化の方向は、合成データ生成とファインチューニングによって、構造化知識をモデルの重みへ「圧縮」することです。コンテキストウィンドウに依存する外部知識システムから、モデル内部の長期記憶へと進むわけです。
コミュニティでもすでにこの発想のプロダクト化が始まっています。Claudeopedia などのツールが登場し、Karpathy 方式をベースに対話的な可視化インターフェースと定時自動レビュー機能が追加されています。
参考
- Karpathy 氏のプロジェクト Gist:https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
- Obsidian Web Clipper:https://obsidian.md/clipper