
ByteDance Lance:3Bパラメータで画像・動画の「見る・描く・編集」全工程を1モデルに統一
ByteDanceがオープンソース化したLanceは、アクティブパラメータわずか3Bのネイティブ統合マルチモーダルモデル。画像・動画の理解・生成・編集を同時にカバーし、公開されるやHugging Face Trending第1位に輝きました。
ByteDance Lance:3Bパラメータで画像・動画の「見る・描く・編集」全工程を1モデルに統一
ByteDanceがオープンソース化したLanceは、アクティブパラメータわずか3Bのネイティブ統合マルチモーダルモデル。画像・動画の理解・生成・編集を同時にカバーし、公開されるやHugging Face Trending第1位に輝きました。
ByteDanceのIntelligent Creation Labが、アクティブパラメータわずか3Bのネイティブ統合マルチモーダルモデル「Lance」をオープンソース化しました。画像と動画の理解・生成・編集をすべて1つのモデルに詰め込んでおり、公開されるやHugging Face Trending第1位に躍り出ました。
数十B、数百Bパラメータが当たり前のマルチモーダルモデルの中にあって、3BのLanceは清々しいほど軽量な存在です。とはいえ特定の単一項目でスコアを稼いだわけではなく、「見る・描く・直す」という課題を同じ答案用紙に載せて一緒に挑んでいます。
コア能力
Lanceは6分類のタスクをカバーしています。
| タスク種別 | 能力 |
|---|---|
| 画像/動画理解 | OCR、知識QA、複数画像理解、動画QA |
| テキストから画像生成 | 複雑なテキスト指示に基づく画像生成 |
| テキストから動画生成 | 自然な動きと時系列の一貫性を持つ動画生成 |
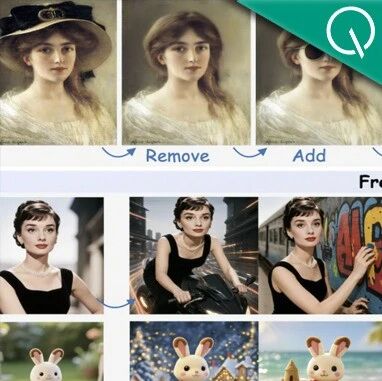
| 画像/動画編集 | 被写体の追加・削除、部分置き換え、スタイル変換 |
動画編集:3ラウンド連続で動画を書き換える
Lanceが書き換えるのはキーフレーム1枚だけではありません。たとえば連続した操作が可能です。まずショートのストレートヘアをフレンチカールに変え、次に赤と白の花のカチューシャを追加し、最後に背景を湖畔のおとぎ話の城に差し替えます。鍵は、人物がずっと同一人物のままで、動きが崩れず、前後フレームもチラつかないことです。
画像編集:自然言語を聞き分ける
背景変更、質感変更、動作変更、ポートレートレタッチ、被写体の除去・置き換え、色調トランスファーをカバーします。核心の要件は、自然言語の指示を聞き分けながら、被写体の同一性と画面の一貫性を保つことです。
技術アーキテクチャ
Lanceの核心となるアイデアは2つです。
1. 統一コンテキスト テキスト、画像、動画をすべて同じ交互マルチモーダルコンテキストに入れます。
2. デュアルストリーム分離 理解と生成の能力パスを切り離し、互いに足を引っ張り合わないようにします。
- 理解パス:テキストトークンとセマンティック視覚トークンを処理し、QAと推論を担当
- 生成パス:VAE latentトークンを処理し、画像/動画の生成と編集を担当
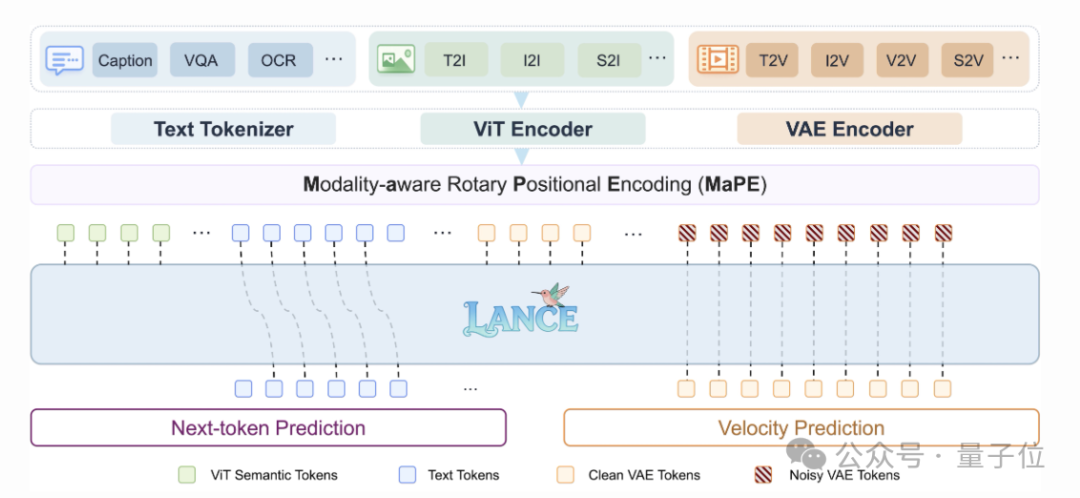
もうひとつの重要な設計がMaPE(Modality-Aware Rotary Positional Encoding)です。時間次元にモダリティ/機能グループの情報を組み込み、どのトークンが理解に使われ、どれが生成条件で、どれが生成対象なのかをモデルに区別させます。
評価結果
| ベンチマーク | スコア | 備考 |
|---|---|---|
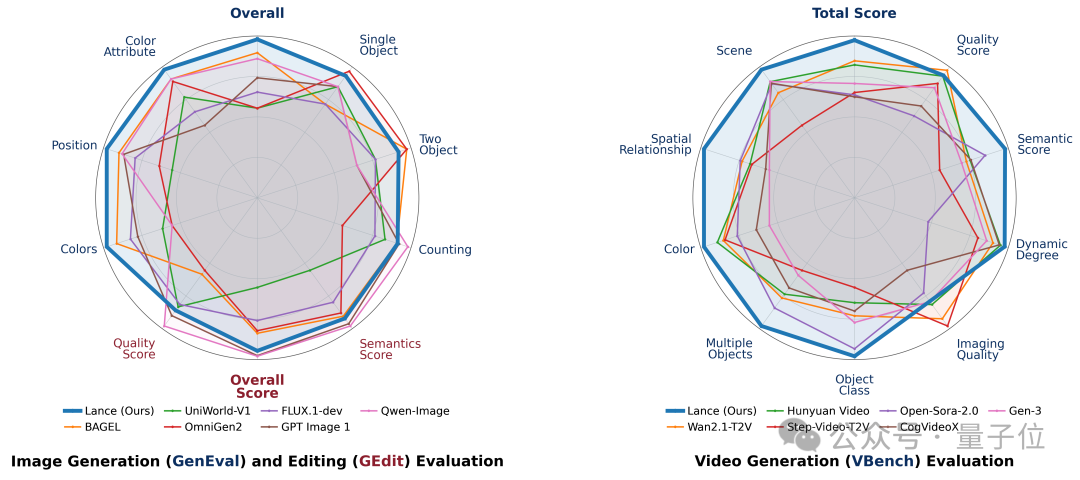
| VBench(動画生成) | 85.11 | 統合モデル中首位 |
| MVBench(動画理解) | 62.0 | 統合モデル中最高、2位に11.3%差をつける |
| GenEval(画像生成) | 0.90 | 全体最高スコアと並ぶ |
| GEdit-Bench(画像編集) | 7.30 | 統合モデル中で最良の平均パフォーマンス |
興味深い発見として、動画生成と編集の能力を加えても動画理解能力は低下せず、むしろマルチタスクデータがより強いクロスタスク転移の学習を助けている可能性があります。
オープンソースリソース
- 論文:https://arxiv.org/abs/2605.18678
- プロジェクトページ:https://lance-project.github.io
- GitHubコード:https://github.com/bytedance/Lance
- HuggingFaceモデル:https://huggingface.co/bytedance-research/Lance
向いている人
- 軽量なマルチモーダルモデルを必要とする研究者・開発者
- 画像/動画の理解・生成・編集を統一するソリューションを目指すプロジェクト
- デプロイコストに敏感で、3Bクラスのモデルが必要な場面
ヒント: 3Bというパラメータ量は、コンシューマー向けGPUで動作できることを意味します。A100やH100クラスのハードウェアは必要ありません。ただし動画生成・編集の品質はトップティアのクローズドモデルとはまだ差があり、ベースラインやプロトタイプ検証向きです。