LingBot-World 2.0:オープンソースで遊べる無限長時間の対話型世界モデル
Ant Group傘下のRobbyantがLingBot-World-Infinityをオープンソース化。720p/60fps・時間単位のリアルタイム生成で、内蔵Agentがイベントを自動提案し、「動画を見る」が「世界に入る」に変わる。
LingBot-World 2.0:オープンソースで遊べる無限長時間の対話型世界モデル
Ant Group傘下のRobbyantがLingBot-World-Infinityをオープンソース化。720p/60fps・時間単位のリアルタイム生成で、内蔵Agentがイベントを自動提案し、「動画を見る」が「世界に入る」に変わる。
前世代の世界モデルは『トゥルーマン・ショー』のようなものだった——再生はできるが、臨機応変には対応できない。ユーザーが脚本を外れると、モデルは崩れてしまう。Ant Group傘下のRobbyant(霊波科技)は2026年7月に LingBot-World 2.0(別名 LingBot-World-Infinity)をオープンソース化し、世界モデルを「動画を見る」から「世界に入る」へと進めた。これは現在のところ、汎用領域で時間単位・ほぼ無限の生成長を実現した唯一のオープンソースモデルで、長時間の連続生成、高いダイナミズム、意味的インタラクション、比較的高い視覚品質、リアルタイム性能、完全なオープンソースを同時に組み合わせている。ゲーム、身体性AI、自動運転シミュレーション、世界モデル研究に取り組んでいる人にとっては、そのまま触って体験し、再現できるオープンソース基盤だ。
LingBot-World 2.0とは
LingBot-World 2.0 はRobbyantがオープンソース化したリアルタイム対話型世界モデルだ。ユーザーから見れば、初期画面と背景設定を持つ世界が目前にあり、1つ1つの操作(移動、攻撃、魔法)が次の画面をリアルタイム生成し、世界を本当に前へ進める。システムから見れば、内蔵のAgentもまたこの世界を観察しており、現在の状態に基づいて新しいイベント——空に雨を降らせる、敵に増援を送る——を能動的に提案し、プレイヤーの介入がなくても環境が自律的に変化するようにする。
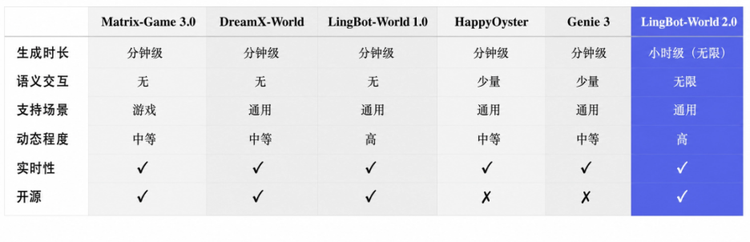
LingBot-World-Infinity は、その中で唯一、汎用領域において時間単位・ほぼ無限の生成長を実現したモデルだ。
3つの重点的な改良
半年前の1.0版と比べ、2.0は主に3つのことを行った:
- 時間単位のリアルタイム生成:長時間の動作でも720p / 60fpsの高精細画面を安定出力
- より豊富なActionとEvent:攻撃、弓射ち、魔法、射撃に加え、天気や環境の変化もインタラクションの一部になれる
- 内蔵Agentがリアルタイムに新しいイベントを提案:世界は静止せず、自己進化を続け、ユーザーに応じて変わる
実測の様子
珪星人Proの実測が、いくつかの典型的なシーンを見せてくれた:
中世ファンタジーの谷:広大な草地、木製の道標、村の小屋、旗、遠くの山並みと霧が揃い、空間のレイヤー構造が完全だ。キャラクターはWASDで谷を抜けられ、馬を召喚して乗れば土煙が舞い、マントの裾が翻りカメラが追従する、オープンワールド的な速度感がある。戦闘ではマスケット銃がマズルフラッシュと煙を伴い、魔法は発光粒子、エネルギー軌跡、衝撃波でスキル範囲と命中フィードバックを表現する。
ショッピングモールからゴッホへ:視点の移動に合わせて、画面には提灯、屋台、煙、通行人、濡れた石畳が広がる。イベント提案の「ゴッホ風の幻覚」をクリックすると、空に青い渦を巻いた、星空の筆致のような幻覚エフェクトが即座に現れた。続いて野菜店、果物店、高級モールへ入るが、カットのつなぎと流暢さは非常に高く、ライティング、マテリアル、棚の構造の整合性が強く保たれる——モデルが「店ごとの違い」という世界知識を理解していることの表れだ。
技術基盤:3つの優位性
1. 因果生成(長時間崩壊の解決)
従来の動画生成モデルは双方向アテンション機構を使い、各フレームが過去と未来を「見」られるため、短い動画の生成では驚くほどの結果を出す。しかしその代償として、モデルは因果を本当に学んでいない——統計的に「発砲」の後には「ガラスが割れる」が続くことしか知らず、前者が後者の原因であることは理解していない。長時間の自己回帰生成では、小さな誤差が繰り返し蓄積し、画面は徐々にぼやけて歪み、最終的に崩壊する。
LingBot-World 2.0 は MoBA(双方向と自己回帰の混合アテンション) を設計した:自己回帰部分がモデルの時間方向への前方生成を保証し、双方向部分が画面全体の関係と視覚品質の把握を保持する。現在の画面は過去のコンテキスト、現在の状態、ユーザー入力のみに依存し、未来の情報が先に漏れることはない。
2. リアルタイム性(少ステップ生成 + ストリーミング配備)
高品質な動画生成は通常、複数ステップのサンプリングを必要とし、画面が複雑なほど待ちが長くなる。だが対話型の世界では、ユーザーにキーを押すたびに立ち止まって待たせるわけにはいかない。チームのやり方は:
- まず高品質なベースモデルを訓練し、その後 consistency distillation と DMD で多ステップ拡散を少ステップ生成へ圧縮
- 配備側では並列推論、非同期VAEデコード、ストリーミング転送、動的KV cache管理を組み合わせ、ユーザー入力から画面フィードバックまでの遅延を削減
720p/60fps の意味は画面がより鮮明なことだけではない。キーを押した後のフィードバックが十分速く、シーンの継続が十分滑らかで、イベントの変化が唐突でないことだ。同時に 1.3B 軽量モデルが配備の敷居を下げ、システムが単一枚のコンシューマーGPU上で動く可能性を開いている。
1.3B 軽量モデルは、ローカルで試す敷居を下げた。
3. Agentic Harness(脳・小脳の協調)
LingBot-World 2.0 は動画生成モデルの外側に「脳・小脳」協調フレームワークを加えた:
- VLMが脳として:画面を観察し続け、ユーザーの動作を理解し、次に起こりうるイベントを提案する
- 下層の動画生成モデルが小脳として:イベントを連続的で信用できる画面へ変換する
何をすればいいか分からないのに未知を体験したいときは、右側パネルのイベント提案を押すか、U / O キーで、システムが現在の世界状態に基づいてランダムに生成する次の選択肢を取得できる。
既知の限界(公式が率直に列挙)
技術レポートには専用セクションで現在の境界が列挙されており、これもこの分野全体が共に越えるべき壁だ:
- 長期記憶が依然として最大の難題:モデルは長時間の視覚的安定は保てるが、ある領域がコンテキスト窓から外れて戻ってくると、似た領域を再生成しているのに近く、「さっきあのドアが開けられた」を本当に覚えているとは限らない。公式は「世界はappearance(見た目)において永続し、identity(同一性)においては永続しない」と要約している
- 整合性と物理理解:アイデンティティとスタイルは超長の探索の中でゆっくり漂う可能性がある。物理理解は本物のエンジンの決定論から程遠く、キャラクターと物体が時に貫通し、衝突関係が乱れる——モデルは物理の視覚的表現を学んだが、物理そのものはまだ学べていない
- 算力の敷居:14Bメインモデルは高品質体験と研究検証に向き、1.3B軽量モデルはローカル試行の敷居を下げたが、開発者が自分のデバイスで滑らかに「世界を開く」には、依然としてシステム級の作業が要る
使い始めるには
メインモデルは非商用のオープンソースライセンスで公開。複数の入口から体験できる:
- Website:technology.robbyant.com/lingbot-world-v2
- Code(GitHub):github.com/Robbyant/lingbot-world-v2
- Model(HuggingFace):huggingface.co/collections/robbyant/lingbot-world-v2
- Model(ModelScope):modelscope.cn/collections/Robbyant/LingBot-World-V2
- オンライン体験(Reactor):reactor.inc/lingbot-world-v2
- モバイル:霊光APPの「世界モデル」機能
- Tech Report:github.com/Robbyant/lingbot-world-v2/blob/main/paper.pdf
💡 ヒント:オープンソースライセンスは非商用なので注意。研究、体験、再現は問題ない。商用利用の前にライセンス条項を確認すること。
応用シーン
- ゲーム/インタラクティブコンテンツ:脚本駆動を世界駆動に変え、ストーリーがプレイヤーの行動とAgentのイベント提案から自然に育っていく
- クリエイター:フレームごとに画面を作る代わりに、ActionとEventで世界の変化の方向を制御する——「一枚一枚の葉を描く代わりに、自分で育つ木を植える」ようなもの
- 身体性AI/自動運転:変化し続け、突発イベントの絶えないシミュレーション環境を提供し、固定シーンのリプレイバッファよりも現実世界の複雑さに近い
- マルチプレイヤー対話:複数人が同じ世界に入ることに対応し、AIネイティブのマルチプレイヤー対話に、実際に動かせるプロトタイプを提供
- 世界モデル研究:イベント駆動で持続的に動作する公共の実験基盤を提供し、研究者は長時間因果整合性、開放領域の動的規則、エージェント協調と環境フィードバックなどの重要問題を検証できる