
OpenSquilla:Agentにトークン節約のミドルウェア層を追加
オープンソースのAgent Harnessフレームワーク。スマートルーティング、コンテキスト管理、自己進化メカニズムにより、Agentのトークンコストを50%以上削減します。
OpenSquilla:Agentにトークン節約のミドルウェア層を追加
オープンソースのAgent Harnessフレームワーク。スマートルーティング、コンテキスト管理、自己進化メカニズムにより、Agentのトークンコストを50%以上削減します。
AI Agent製品を開発しているなら、トークンの請求額はすでに頭痛の種になっているはずです。Agentはチャットボットよりはるかにトークンを消費します——1つのタスクの背後で10数ステップが実行されることもあり、その1歩ごとにお金が燃えています。しかも、すべてのステップに最強のモデルが必要なわけではありません。分類、要約、フォーマット整理といった単純なタスクにフラッグシップモデルを使うのは無駄です。
OpenSquillaはオープンソースのAgent Harnessフレームワークで、Agentアプリケーションと大規模モデルの間に「ランタイムハブ」の層を追加します。核心の目標はただ1つ:Agentに無駄なトークンを浪費させず、同時に使うほどユーザーを理解するようにすることです。
OpenSquillaとは
OpenSquillaは4層アーキテクチャのミドルウェアフレームワークで、Agentアプリケーションと基盤の大規模モデルの間にデプロイされます。モデル自体を置き換えるのではなく、「どのモデルを呼ぶか、どれだけのコンテキストを与えるか、タスクをどう編成するか、どう継続的に進化させるか」という重要な意思決定を管理します。
OpenSquillaがAgentアプリケーションとモデルの間に構える4層アーキテクチャ:スマートルーティング、コンテキスト管理、MetaSkillオーケストレーション、自己進化メカニズム。
4層の核心メカニズム
第1層:スマートルーティング——適切なモデルを呼び、適切にお金を節約
多くのAgentチームのやり方は、1つの主力モデルに固定することです。効果は安定し、開発も楽ですが、請求額はすぐに制御不能になります。
OpenSquillaはタスクが大規模モデルに入る前に、まずローカルのルーティングモデルでタスクの複雑さを判定します。セマンティクス、キーワード、言語、コンテキスト長、対話ラウンド数などの特徴に基づいてタスクを異なるレベルに分け、それぞれに異なるモデルをマッチングします。
重要な違いは、このルーティングが静的なルールテーブルではなく、タスクのフィードバックに基づいて継続的に最適化できるパラメータ化モデルだという点です。どのタスクが成功したか、どこでトークンを消費したか、どのモデルがコストパフォーマンスに優れるかといったシグナルがルーティングに還流し、絶えず訓練を続けます。
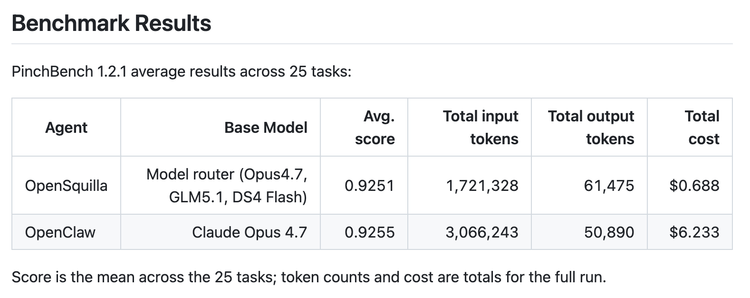
チームのデータによれば、OpenSquillaのスマートルーティングはOpenRouterよりルーティング精度が4.4ポイント高く、コストは75%低いそうです。
第2層:コンテキスト管理——モデルに無駄な内容を読ませない
多くのAgentシステムは、Skillの説明、ツールのドキュメント、履歴メモリ、Webページの内容をまとめてpromptに詰め込みます。モデルは呼び出されるたびに全部読み直し、使われないトークンもそのまま課金されます。
OpenSquillaのやり方:
- オンデマンドのSkillロード:1回のタスクには使われる可能性のあるSkillだけを注入し、数十個のSkillの説明を全部詰め込まない
- 精密なメモリ再呼び出し:ローカルデータベースから関連断片を検索し、丸ごと持ち込まない
- ツール結果の前処理:WebページHTML内のタグ、スタイル、ナビゲーションバー、広告などの無関係な内容を切り捨てる
チームのデータによれば、コンテキスト管理はさらに約20%から50%のコスト低減をもたらします。
第3層:MetaSkill——Agentに能力を自己組織させる
Skillが増えるほど、Agentは理論上強くなります。しかし実際の使用では、ユーザーはこれらのSkillをどう組み合わせればよいのか分からなくなります。1篇文章を書くにも、まず資料を調べ、事実を確認し、文体を学び、初稿を書き、校正する——それぞれのステップにSkillがあるのに、誰が順序を編成するのでしょうか?
OpenSquillaのMetaSkillメカニズムでは、ユーザーは目標を言うだけで、AIが自動的にステップに分解し、Skillの組み合わせを選び、依存関係を組みます。各ステップはコンテキストを独占し、相互干渉を避けます。
第4層:自己進化——ユーザーの好みをHarnessに学び込ませる
ユーザーが初めてAgentにタスクを任せるとき、たいていは何度か修正ラウンドが必要になります。問題は、直しても次回また同じ過ちを繰り返すことです。経験が蓄積されていません。
OpenSquillaはインタラクションの全過程を振り返ります:ユーザーがどの条件を補い、どのズレを修正し、最終的にどの結果を承認したかを確認し、それらの情報をSkillやワークフローに蓄積させます。次回同様のタスクに出会っても、Agentはゼロから始める必要がありません。
ユーザーの修正が1回減る = システムの実行が1ラウンド減る = トークンの消費が1ラウンド分減る。
適用シーン
- Agent製品チーム:トークン粗利が30%を下回るチームには、体系的な呼び出しコスト削減が必要です
- 複数モデルの混用:すでに複数のモデルを使っているが、統一されたルーティング手段のないチーム
- 複雑なワークフロー編成:Agentが多ステップ・複数Skillの組み合わせに関わるシーン
- ユーザー維持率の最適化:Agentにユーザーの好みを記憶させ、繰り返しの指導を減らしたい場合
ヒント: OpenSquillaのルーティングモデルはローカルで実行されるアンサンブル木モデルで、大規模モデルAPIの追加呼び出しが不要で、それ自体は追加のトークンコストを生みません。
関連記事
AI社員に海外インフルエンサー探しを任せる:AhaCreator実践ガイド
AhaCreatorでインフルエンサー選定、コンテンツ審査から海外送金まで、海外インフルエンサーマーケティングの全工程をこなす方法を丁寧に解説します。個人開発者と海外展開チームに向いています。
AI長尺動画生成:2つのオープンソースフレームワーク比較レビュー
同日に発表された2大オープンソースフレームワーク、VideoClawとJoyAI-Echo。マルチエージェント協調とクロスモーダル記憶ライブラリという異なるアプローチでAI長尺動画の一貫性問題に挑む両者の技術方案を比較します。
ChatGPTの記憶システムが全面刷新:Dreaming V3登場
OpenAIが全新のDreaming V3記憶アーキテクチャを発表。ChatGPTが裏で「夢を見て」あなたの情報を整理し、初めて10億人の無料ユーザーに開放。Plus/Proは記憶容量が2倍になります。
CloudflareがClaude Managed Agentsに対応:開発者向け実践ガイド
CloudflareがClaude Managed Agents対応を追加しました。開発者はCloudflareプラットフォーム上でClaudeエージェントを実行し、プライベートシステムに接続して、セキュアなAIエージェントデプロイを実現できます。
Claude Code vs Codex:全24機能の比較パノラマ
2つのAIコーディングエージェントの共通機能24項目をタイムラインで整理。Claude Codeが18項目を先行リリースしたものの、その差は日単位で縮まり続けています。
Higress:AI支援のK8sゲートウェイ移行ツール
CNCFが披露したAI支援移行方案は、60個のingress-nginxリソースを30分以内にHigress設定へ自動変換し、K8sゲートウェイ移行のコストを大きく下げます。