
PerfEvolve:AgentにベテランDBAのようにデータベースパラメータを調整させる
中国科学院ソフトウェア研究所がPerfEvolveフレームワークをオープンソース化。静的なパラメータ調整ドキュメントをAgentが実行可能な手続き的スキルへ変換し、PostgreSQL v16で最大58.9%の性能向上を実現。LLMの調整失敗に効く特効薬です。
PerfEvolve:AgentにベテランDBAのようにデータベースパラメータを調整させる
中国科学院ソフトウェア研究所がPerfEvolveフレームワークをオープンソース化。静的なパラメータ調整ドキュメントをAgentが実行可能な手続き的スキルへ変換し、PostgreSQL v16で最大58.9%の性能向上を実現。LLMの調整失敗に効く特効薬です。
データベースの自動パラメータ調整は、ずっと大モデルAgentの「一見完璧、実際は失敗」の名場面でした。公式ドキュメントとパラメータ攻略を十分に与えても、LLM Agentは問題だらけ。古いパラメータをそのまま新ハードウェアに当てはめて失敗するか、パラメータ同士が「けんか」して、調整するほど性能が落ちるかです。
中国科学院ソフトウェア研究所のインテリジェントソフトウェア研究センターと基礎ソフトウェア・システム重点実験室のチームが共同で発表したPerfEvolveフレームワークは、直感に反する結論を示しました。問題は大モデルがドキュメントを読めないことではなく、従来の調整ドキュメント自体に致命的欠陥があるのです——「最終答案」だけを与え、「解き方の過程」を決して教えない。結論には賞味期限があるが、過程こそ移植できる、と。
PerfEvolveはLLMにパラメータ値を丸暗記させるのではなく、静的な調整ドキュメントをAgentが直接実行し自律的に適用できる手続き的チューニングスキルへ変換します。PostgreSQL v16で最大58.9%の性能向上を実現し、すでにオープンソース化されています。
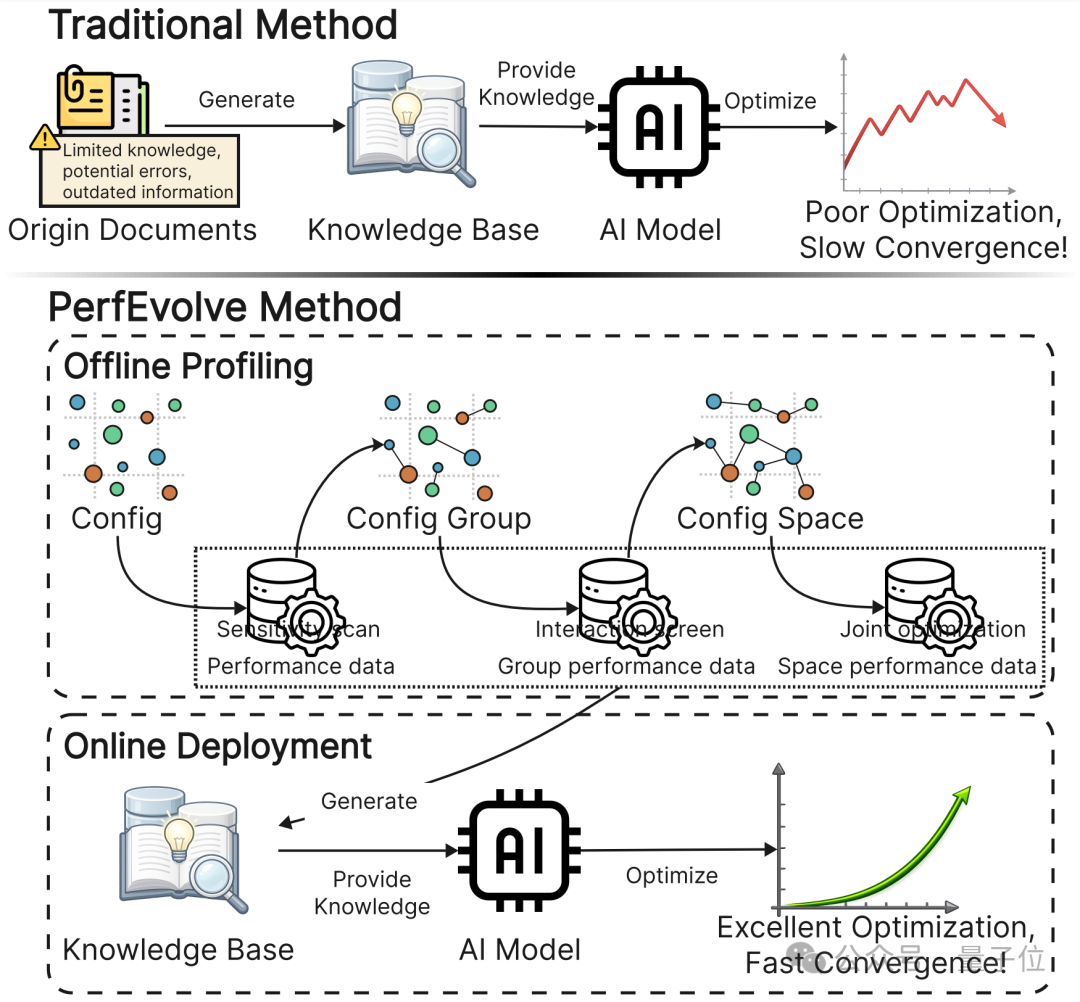
PerfEvolveの核心:「説明書を読む」を「プロファイルできる」へアップグレードする。
始める前の準備
- Python 3.10+
- アクセス可能なPostgreSQL v16インスタンス1つ(きれいなテストDBをDockerで立てるのが推奨。本番環境では調整しないこと)
- リソース:
- 論文:https://arxiv.org/abs/2605.19988
- GitHub:https://github.com/ISCAS-OSLab/PerfEvolve
- 蓄積済み:実行可能なチューニングスキル23項目 + パラメータ特性プロファイル160件
最小サンプルの想定実行時間:1時間。
第1歩:従来のパラメータ調整の3つの死穴を理解する
手を動かす前に問題を認識しておけば、PerfEvolveが何を解決しているかがわかります:
- 静的ドキュメントの深刻な遅れ:ほとんどのデータベースパラメータの推奨値は、何年も前の旧バージョン・旧ハードウェア時代にとどまっています。たとえばPostgreSQLの多くのコアパラメータの公式推奨値はいまだHDD時代のままで、全台SSDの新しい環境では役立たないどころか、むしろ性能を引きずり下げます。
- 「汎用推奨値」はシーンによって完全に逆転する:最も古典的なのが
shared_buffers = 25% RAM——すべてのDBAが目にしたことがありますが、このパラメータ1つの設定が不適切なだけで5%–16%の性能損失をもたらしうます。 - パラメータ同士のけんか:1つのパラメータを単独で調整すれば数値は完璧に正当でも、いったん組み合わせて使うと性能が急落し、さらにはクラッシュします。データベースのチューニングは決して1+1=2ではありません。
PerfEvolveの診断はこうです。固定されたパラメータ値だけを与えるドキュメントは、千変万化するハードウェア、負荷、システムバージョンに適応できない。真のボトルネックは「Agentがドキュメントを十分読んでいない」ではなく、「ドキュメントが終点の座標だけを与え、経路を与えていない」ことです。
第2歩:リポジトリをクローンし、PostgreSQL v16スキルパックを読み込む
git clone https://github.com/ISCAS-OSLab/PerfEvolve.git
cd PerfEvolve
pip install -r requirements.txt

# きれいな PG v16 テストインスタンスを起動
docker run -d --name pg16-test \
  -e POSTGRES_PASSWORD=test \
  -p 5432:5432 postgres:16

# 公式が蓄積した23項目のチューニングスキル + 160件のパラメータ特性プロファイルを読み込む
python -c "
from perfevolve import SkillPack
pack = SkillPack.load('skills/postgres_v16')
print(f'{len(pack.skills)} skills, {len(pack.profiles)} profiles loaded')
"
各スキルはパラメータ推奨値の断片ではなく、構造化された実行可能なSOPです:前提条件 → 実操作手順 → 判断基準 → 事後検証 → オフライン実測データ。
第3歩:PerfEvolveを自分のAgentに接続する
PerfEvolveはAgentのチューニングフローを1本の完全なワークフローに標準化します:
デフォルト設定の性能を測定 → 候補パラメータ値をスキャン → スループット変化カーブを観察
  → ピーク区間を見つける → 他のパラメータとの強い相互作用を確認
  → あれば共同最適化へ → 最後に負荷をまたいで安定性を検証
接続方法(擬似コード、自分のLLM Agentに接続):
from perfevolve import TuningWorkflow, AgentAdapter

class MyLLMAgent(AgentAdapter):
    def decide_next_step(self, observation, history):
        # observation: 現在の perf カーブ、パラメータの現在値、負荷特性
        # PerfEvolveは「次に何をすべきか」をすでに構造化済み
        # Agentは構造化された選択肢の中から選ぶだけでよく、直感でコマンドをでっち上げない
        return self.llm.choose_action(observation, history)

wf = TuningWorkflow(
    db_url="postgresql://postgres:test@localhost:5432",
    skill_pack="skills/postgres_v16",
    workload="tpcc",  # sysbench / カスタムも可
)

result = wf.run(agent=MyLLMAgent(), iterations=10)
print(f"improvement: {result.improvement_pct}%")
print(f"best_config: {result.best_config}")
第4歩:検索空間を圧縮する2つの仕掛けを理解する
PerfEvolveが検索コストを叩き下げられるのは、2つのメカニズムによります:
- 感度の次元削減:まず高速スキャンで「どのパラメータが調整に値するか、どれはほぼ無視してよいか、各パラメータの安全範囲はどこか、応答カーブはだいたいどんな形か」を判断します。160件のパラメータ特性プロファイルが「無効な検索空間」を事前に切り落とします。
- パラメータ相互作用トポロジー図:どのパラメータが強く相関し、一緒に調整しなければならないかを識別し、「単独最適、組み合わせで失敗」を回避します。これが「パラメータ同士の格闘」を解決する鍵です。
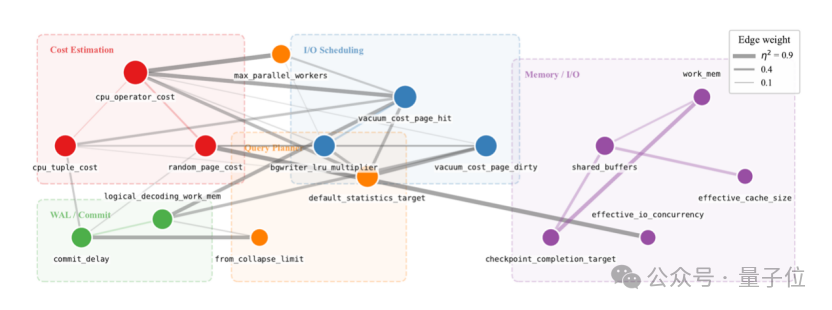
感度の次元削減 + パラメータ相互作用トポロジー図で、検索空間を指数オーダーから実行可能な規模へ圧縮。
検証結果
実行が終わると、こんなチューニングレポートが手に入ります:
Workload: tpcc (PG v16)
Default throughput:    1240 TPS
Optimized throughput:  1968 TPS
Improvement:           58.9%

Top changed params:
  shared_buffers:        25%RAM → 38%RAM  (メモリ型負荷)
  work_mem:              4MB    → 64MB
  effective_io_conc:     1      → 200     (NVMe を検出)
  max_worker_processes:  8      → 16

Cross-load validation: stable across tpcc/sysbench/read-heavyAgentのチューニング後に性能が上がるどころか下がる場合は、まずモデルを疑う前に、PerfEvolveのオフライン特性プロファイルがあなたの負荷タイプをカバーしているかを確認してください——それがこのフレームワークの正しさの土台です。
よくある質問
- Agentのチューニング後に性能がむしろ下降:十中八九は「パラメータ同士の格闘」の発火です。相互作用トポロジー図で赤くマークされた強相関パラメータ群を確認し、それらが個別調整ではなく共同チューニングになるようにしてください。
shared_buffersがいつも25%に調整し戻される:LLMがドキュメントの「標準答案」を丸暗記する典型的な症状です。PerfEvolve論文が特に検証しているとおり——LLMに完全に正しいパラメータ標準答案を与えても、やはり性能悪化を招きうる——数値がモデルに「認知的アンカリング」を形成するためです。宣言的知識を手続き的スキルに切り替えれば解決します。- クロス負荷検証を通らない:チューニング結果が単一負荷に過適合している兆候です。workflow内の
cross_load_validationの厳格度を上げ、Agentを共同最適化段階に再び入らせてください。
💡 ヒント:PerfEvolveの中心的な洞察は「データベースのチューニング」だけではありません——すべてのAgentに有効なパラダイムを示しています。Agentに100個の標準答案を与えるより、自主的に解く能力一式を与えるほうがまし、というものです。この考え方は、運用、ネットワーク設定、CI/CDパイプラインなど「結論より過程が重要」な他の領域にも同じように当てはまります。