
AlibabaがQwen-AgentWorldをオープンソース化:初の言語世界モデル、ひとつのモデルで7クラスの環境をシミュレート
AlibabaのQwenが初のネイティブ言語世界モデル(Language World Model, LWM)「Qwen-AgentWorld」をオープンソース化。単一モデルでMCP / Search / Terminal / SWE / Web / OS / Androidの7クラスのエージェント環境をカバーし、評価ベンチマークAgentWorldBenchも同時公開。
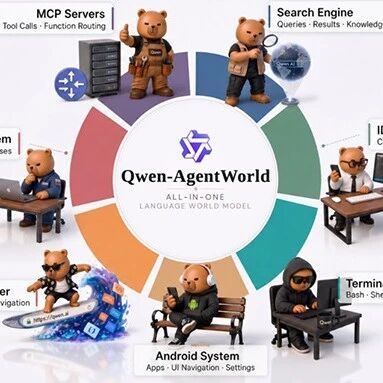
AlibabaがQwen-AgentWorldをオープンソース化:初の言語世界モデル、ひとつのモデルで7クラスの環境をシミュレート
AlibabaのQwenが初のネイティブ言語世界モデル(Language World Model, LWM)「Qwen-AgentWorld」をオープンソース化。単一モデルでMCP / Search / Terminal / SWE / Web / OS / Androidの7クラスのエージェント環境をカバーし、評価ベンチマークAgentWorldBenchも同時公開。
AlibabaのQwenが、初のネイティブ言語世界モデル(Language World Model, LWM)Qwen-AgentWorldをリリースした。AIエージェントの研究開発と訓練のために作られたものだ。その中核能力は:エージェントが行動を取る前に、まず内部で環境フィードバックをシミュレートしてから意思決定すること。ひとつのモデルで7クラスのエージェント対話環境を同時にカバーし、評価ベンチマークAgentWorldBenchも同時リリース、モデルウェイトとベンチマークはどちらもオープンソース化されている。
この記事では、Qwen-AgentWorldとは何か、どう動くか、効果はどうか、どう入手するかを分解する。
これは何か
Qwen-AgentWorldは言語世界モデルで、2つのパラメータ規模を提供する:
- Qwen-AgentWorld-35B-A3B(オープンウェイト)
- Qwen-AgentWorld-397B-A17B
これは実環境との対話の置き換えを狙うものではない——実環境は、エージェントの行動の信頼性を保証するゴールデンスタンダードであり続ける。LWMが提供するのは 相補的な経路 だ:実環境を超えるスケーラビリティと制御性、そして内化された世界予測能力を持つ。
上図はスマートフォンシステムのシミュレーション:左側がスマホ画面の初期状態、右側がエージェントがツールバーの削除アイコンをタップする操作の予測結果だ。
2つの大きなハイライト
ハイライト1:事前訓練の段階から環境モデリングを訓練目標に
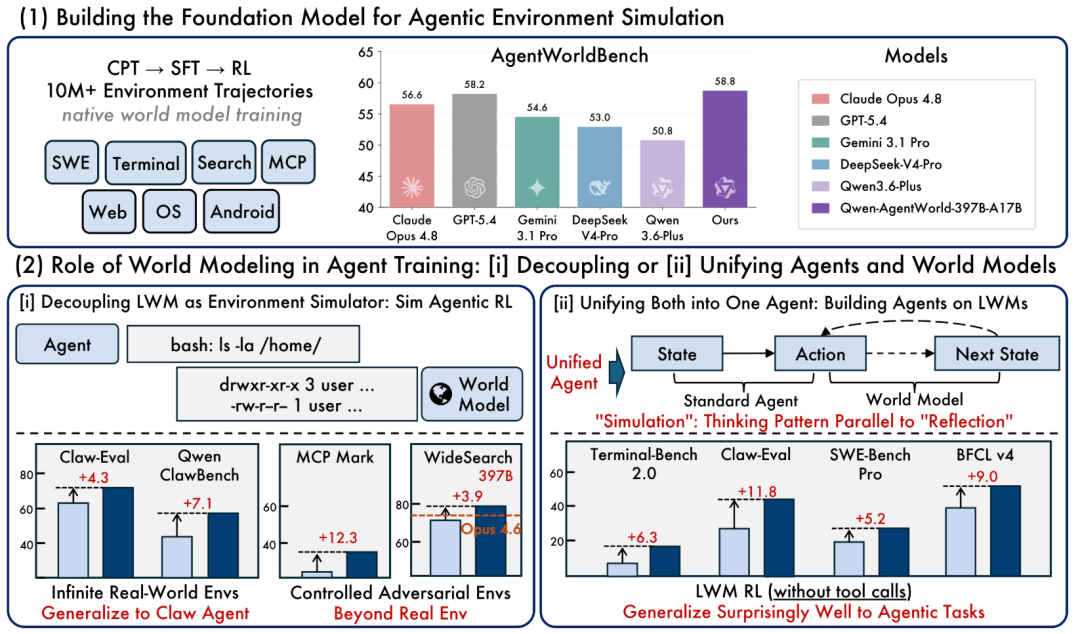
環境モデリングが CPT → SFT → RL の全過程を貫く。従来の汎用基盤大モデルの訓練では、訓練終了後に初めてAIに環境の理解や操作結果の予測を教えていた。Qwen-AgentWorldはこのステップを事前訓練段階へ前倒しし、1000万件を超える実環境対話軌跡に基づいて訓練されている。
ハイライト2:単一モデルで7クラスの環境をカバー
| クラス | カバーする環境 |
|---|---|
| テキスト系 | MCP、Search、Terminal、SWE |
| GUI系 | Web、OS、Android |
3つのGUI領域の環境観測は、ピクセルフレームではなく レンダリング可能なコード(アクセシビリティツリーXML、HTML、UI階層マークアップ)として表現される。これにより、純テキストの世界モデリングだけで視覚環境をカバーでき、領域をまたぐ知識転移が実現する。
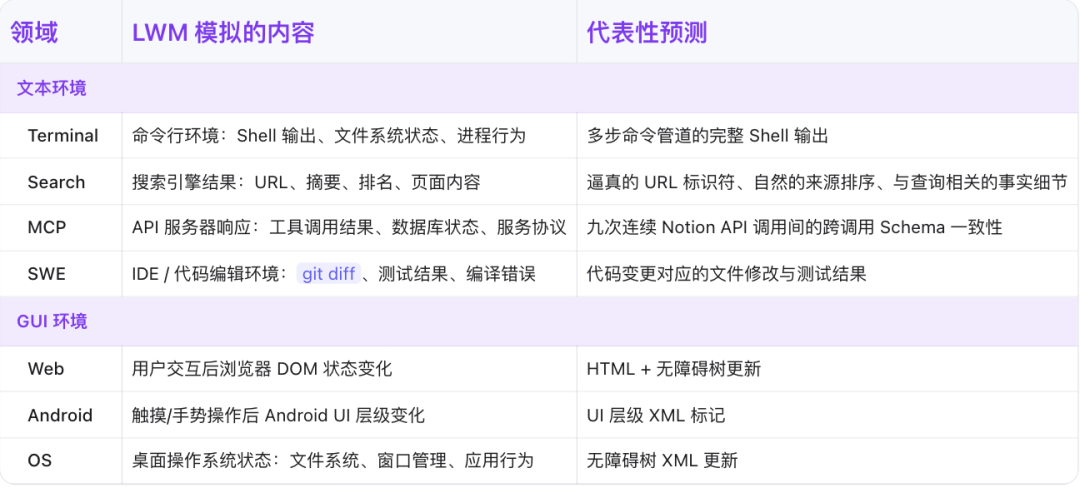
PCシステム(メニューバーで「ファイル」>「印刷」をクリックする操作の予測など)やウェブサイトの対話(「ユーザーを追加」ボタンをクリックする操作の予測など)をシミュレートできる。
効果:全体のシミュレーション品質はClaude Opus 4.8超え
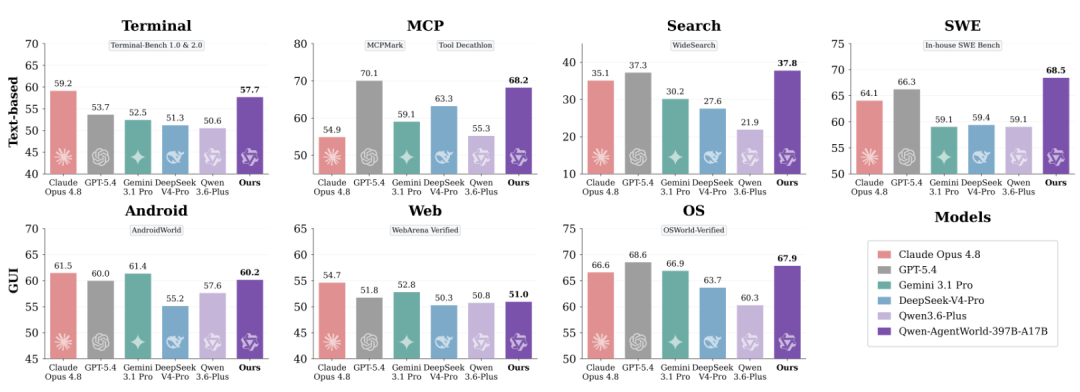
同時リリースされた AgentWorldBench は、5つのフロンティアモデルによる9つの成熟評価セット上の実環境対話観測に基づいて構築され、フォーマット、事実性、一貫性、真実性、品質の5次元で評価する。
- Qwen-AgentWorld-397B-A17B はAgentWorldBenchで最高の全体平均スコア 58.71 を達成し、GPT-5.4(58.25)、Claude Opus 4.8、Gemini 3.1 Proを上回った。優位性はTerminalとSWE領域で最も顕著だ。
- 35B-A3B 規模 では、3段階訓練パイプラインが全体平均スコアを8.66ポイント引き上げ、Claude Sonnet 4.6を上回る性能を示した。
創発した3つの推論パターン
研究チームはテキスト系4領域の129本の思考連鎖を分析し、3つの創発的な推論パターンを発見した:
- 自己修正:モデルが「Wait!」を自己訂正のトリガー信号として使い、中間予測を修正する(平均で1turnあたり10.4回)。事実誤り、知識の境界、視点転換をカバーする。
- 情報漏洩防止:検索領域では、モデルはエージェントが検索している参照答えをすでに知っており、要約が目標を偶然漏らさないよう確保することで漏洩を防ぐ。
- 多段因果推論:例えば
curl -s localhost:3000 | python3 -m json.toolの出力を予測する際、6段の推論チェーンを走らせる——Node.js が無い → サーバーが起動していない → ポート3000でリッスンしていない → curl が静かに失敗 → 空のパイプ → json.tool が JSONDecodeError を投げる。
💡 ヒント:Qwen-AgentWorldは、言語世界モデルが「分離した環境シミュレータ」としてエージェントRLに制御可能な訓練環境を提供できると同時に、「統一されたエージェント基盤モデル」にもなることを検証した——その事前訓練は7つのベンチマークを含む複数ターンのエージェントタスクへ転移でき、エージェントタスク向けのRLファインチューニングを一切必要としない。
入手方法
AlibabaはQwen-AgentWorld-35B-A3B(モデルウェイト)とAgentWorldBench(評価ベンチマーク)をオープンソース化した。
- GitHub:https://github.com/QwenLM/Qwen-AgentWorld
- ModelScope:https://modelscope.cn/collections/Qwen/qwen-agentworld
- Hugging Face:https://huggingface.co/collections/Qwen/qwen-agentworld
誰に向くか
- エージェント研究開発チーム:LWMを制御可能な環境シミュレータとして使い、実環境よりスケーラブルな訓練経路をエージェントRLに提供する。
- GUI / Computer-Useエージェント開発者:Qwen-AgentWorldでWeb / OS / Android上の操作結果を予測し、試行錯誤のコストを下げる。
- エージェント基盤モデル研究者:言語世界モデルの事前訓練から複数ターンのエージェントタスクへの転移能力を探究する。