
RhymeFlow:オープンソース動画生成を1.8倍高速化
清華大学が動画生成高速化フレームワーク「RhymeFlow」をオープンソースで公開。再学習なしでWan 2.1やCogVideoXなどのDiTモデルの推論を1.5x-1.8x高速化でき、品質はほぼ無損失。62.5%のユーザーが差を区別できませんでした。
RhymeFlow:オープンソース動画生成を1.8倍高速化
清華大学が動画生成高速化フレームワーク「RhymeFlow」をオープンソースで公開。再学習なしでWan 2.1やCogVideoXなどのDiTモデルの推論を1.5x-1.8x高速化でき、品質はほぼ無損失。62.5%のユーザーが差を区別できませんでした。
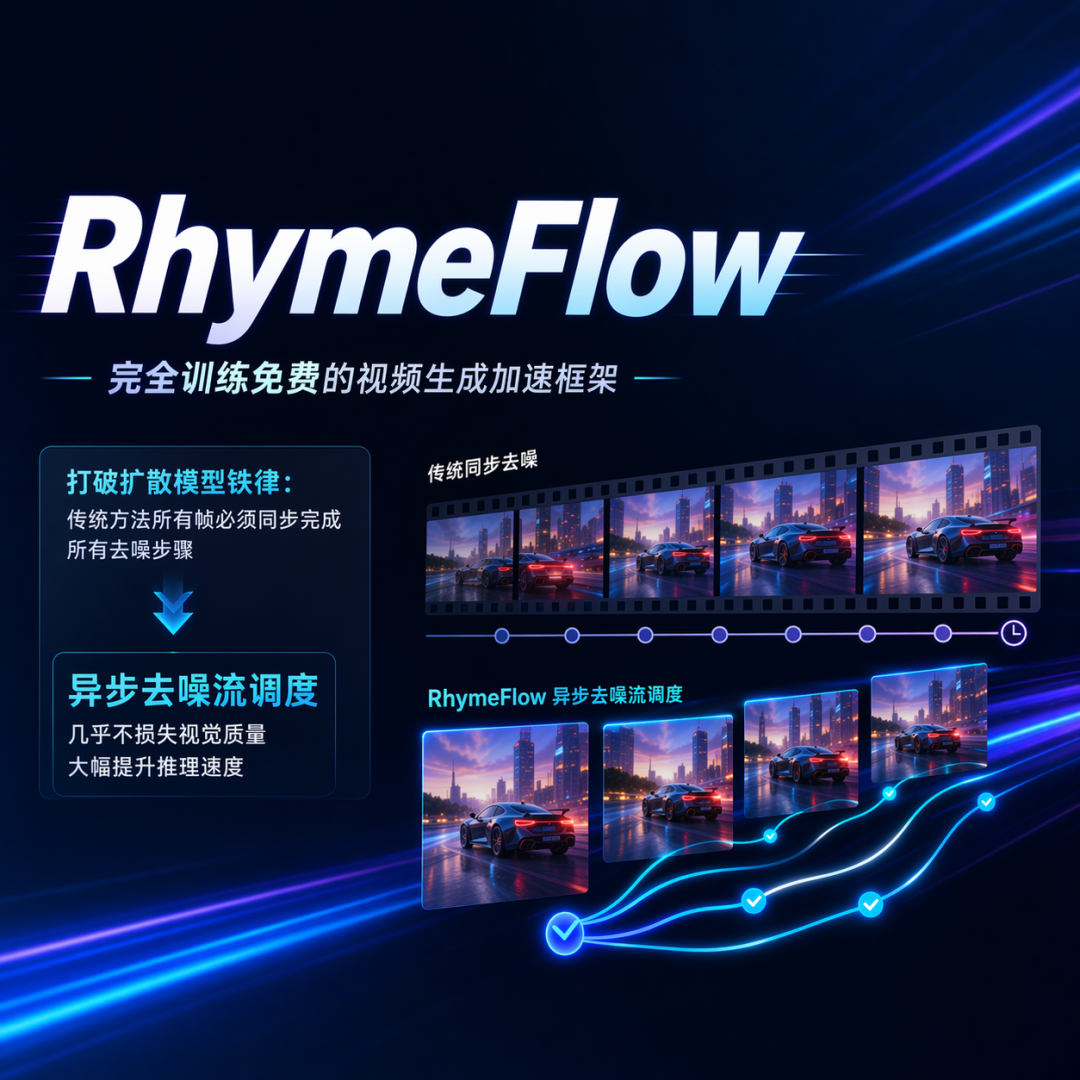
清華大学とGigaAIは共同でRhymeFlowをオープンソース化しました。完全に学習不要の動画生成高速化フレームワークです。モデルの再学習は必要なく、推論段階で「フレーム間非同期スケジューリング」を直接適用することで、Wan 2.1やCogVideoXなどのDiT動画モデルの推論速度を1.5倍から1.8倍へ向上させます。
82人の二重盲検ユーザースタディでは、62.5%のユーザーがRhymeFlowの出力を元のモデルと区別できませんでした。
どの問題を解決するのか
現在の主流DiT動画モデル(Wan 2.1、CogVideoX、Sora)には共通の痛点があります。81フレームの720p動画を1本生成するのに、A800 GPU 1枚で17分近くかかるのです。
既存の高速化手法(スパースアテンション、KVキャッシュ、量子化)が最適化するのは単一ステップ内の計算量です。しかし、より根源的な問題には誰も手をつけていませんでした——すべてのフレームが一律に扱われること。隣接フレームの内容がほぼ完全に同じでも、完全な50ステップのノイズ除去プロセスを最後まで歩む必要があります。
RhymeFlowの核心となる洞察は、動画のセマンティクスと運動は連続であり、キーフレームが全体構造を決め、非キーフレームの軌跡は高度に予測可能だというものです。それならば、なぜ異なるフレームにそれぞれ独自の道を歩かせないのでしょうか?
3つのコアモジュール
1. コンテンツ感知のキーフレーム選択
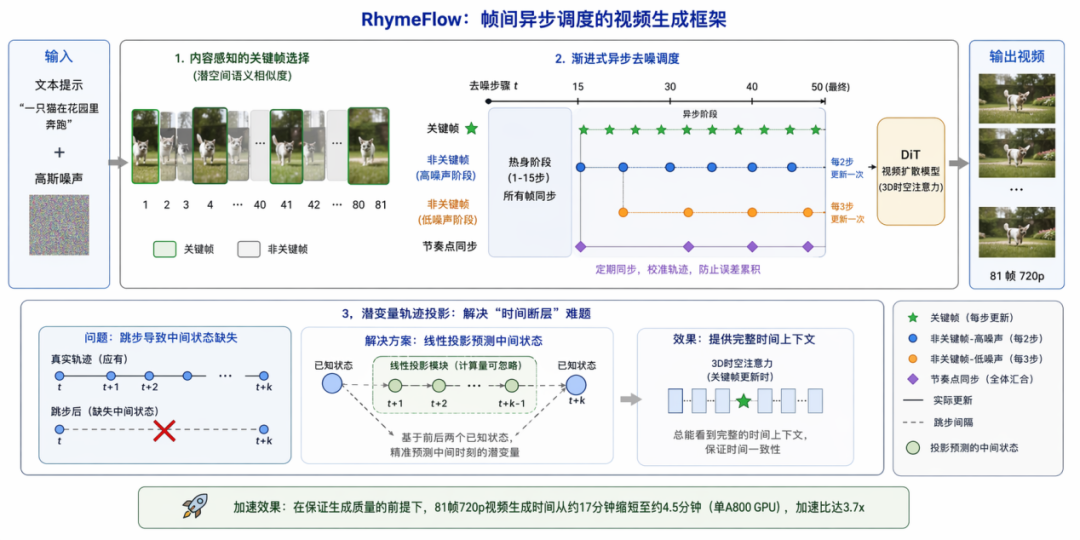
単純な均一サンプリングではなく、潜在空間のセマンティック類似度によって、シーン切り替えや物体の急激な運動変化を含むキーフレームを自動識別します。これらのフレームには完全な計算リソースが割り当てられ、動画の構造完全性とセマンティック正確性が確保されます。
2. 段階的非同期ノイズ除去スケジューリング
キーフレームは毎ステップ更新され、非キーフレームはノイズ段階に応じた差別化されたスキップで進行します。
- ウォームアップ段階(最初の15ステップ):すべてのフレームが同期してノイズ除去を行い、全体構図の基礎を固める
- 高ノイズ段階(構造に敏感):非キーフレームは2ステップに1回更新
- 低ノイズ段階(ディテール最適化):非キーフレームは3ステップに1回更新
- 同期ポイント:定期的にすべてのフレームを合流させ、非キーフレームの軌跡を較正して、誤差の蓄積を防止
3. 潜在変数軌跡投影
非キーフレームがステップをスキップすると、中間状態の欠如が3Dアテンションの時間的一貫性を損ないます。RhymeFlowは計算量が無視できる線形投影モジュールを使い、前後の2つの既知状態から中間時刻の潜在変数を高精度に予測します——非キーフレームに滑らかな運動軌跡を描くのに相当します。
実験結果
主流オープンソースモデルでのテスト結果:
SOTA手法との比較:
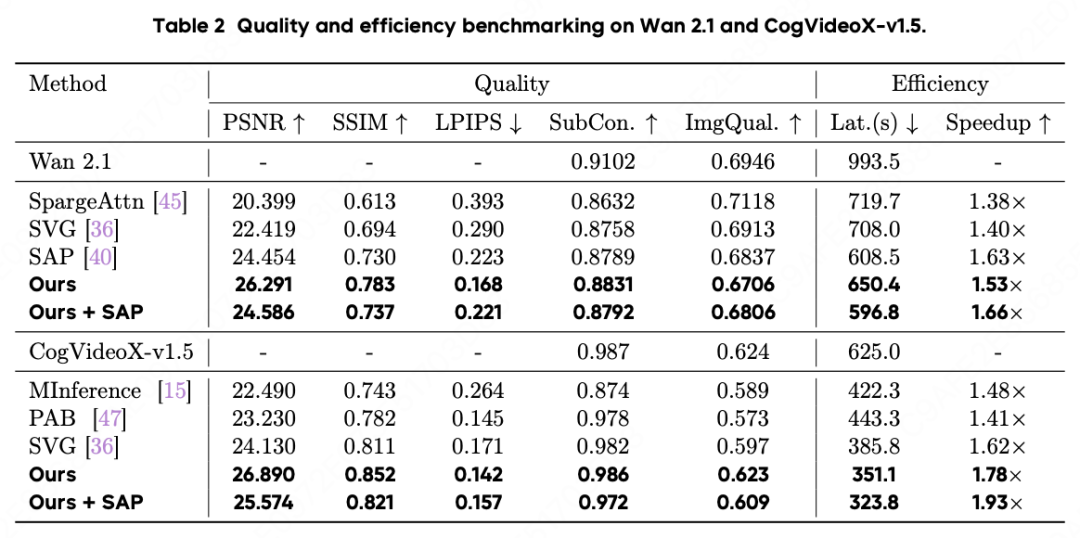
- Wan 2.1では:RhymeFlowのPSNRはSAPより1.84高く、SSIMは0.053高く、速度は同等
- CogVideoXでは:1.78倍の高速化率で、98.6%の主体一致性を維持
- SAPと重ねた場合:高速化率はさらに1.93倍まで向上し、品質もSAP単独使用を上回る
82人二重盲検ユーザースタディ:
- 53.7%のユーザーがRhymeFlowの時間的整合性はSVGより優れていると評価
- 74.4%のユーザーがSAPよりRhymeFlowを好む
- 元のモデルとの比較では、62.5%のユーザーが差を区別できず、統計的に有意な違いはなし
適したシーン
RhymeFlowは以下のようなシーンに適しています。
- Wan 2.1、CogVideoXなどのオープンソースDiT動画モデルによるバッチ動画生成
- 動画生成の推論コストを削減したい(GPU時間が約半分に短縮)
- 動画品質への要求はあるが、極めて微小な品質低下は許容できる
入手方法
- 論文: arxiv.org/abs/2604.08370
- GitHub: github.com/Simon-Dcs/RhymeFlow
- プロジェクトページ: simon-dcs.github.io/Website-of-RhymeFlow
フレームワークは完全なオープンソースで、モデルの再学習は不要。既存のDiT推論パイプラインに直接統合できます。