
エッジ側で大モデルを動かす実践:Pi + LM Studioでローカルにエージェントコーディング環境を構築
Piエージェントフレームワーク+LM Studio推論サーバー+Dockerサンドボックスで、ローカルのM2 Mac上でGemma 4シリーズを動かし、エージェントコーディング、コード検査、ユニットテストまでこなす。精度はフロンティアモデルの約75%に達する。
エッジ側で大モデルを動かす実践:Pi + LM Studioでローカルにエージェントコーディング環境を構築
Piエージェントフレームワーク+LM Studio推論サーバー+Dockerサンドボックスで、ローカルのM2 Mac上でGemma 4シリーズを動かし、エージェントコーディング、コード検査、ユニットテストまでこなす。精度はフロンティアモデルの約75%に達する。
ローカルで動くAIモデルは、この半年で本当の分水嶺を迎えた——知力、エージェント能力、ツールチェーンの成熟度のすべてが一線を越えた。本記事の著者Vicki Boykis(スタートアップの創業機械学習エンジニア。Mozilla.ai、Tumblr、Automatticに勤務歴あり)は、2022年モデルのM2 Mac(メモリ64GB)1台で、Piエージェントフレームワーク+LM StudioによってGemma 4シリーズを日常のコーディング相棒として走らせ、精度はフロンティアモデルの約75%に到達した。
このチュートリアルでは、彼女のワークフローを再現可能なステップに分解する:推論サーバーの導入、エージェントフレームワークの設定、Dockerサンドボックスでの実行。
始める前の準備
必要なハードウェア
- メモリに余裕のあるマシン1台(著者はM2 Mac+メモリ64GB+ストレージ1TBを使用)。ローカルエージェントはKVキャッシュを物理メモリ上限ぎりぎりまで消費する。
- ユニファイドメモリは最低16GBを推奨。12Bクラスのモデルを快適に動かすなら32GB以上が望ましい。
必要なソフトウェア
- LM Studio:ローカルモデル推論サーバー(OpenAI互換の
/v1エンドポイントを提供) - Pi:エージェントフレームワーク(https://github.com/patloeber/gemma-4-pi-agent に参考設定あり)
- Docker:エージェントセッションをサンドボックスに閉じ込め、物理ディスクの直接操作を避ける
推奨モデル
著者はMistral 7B、Gemma 3、OpenAI GPT-OSS-20B、Qwen 3 MOEなどを実際に試した。現時点のデフォルト推奨は:
- gemma-4-26b-a4b(LM Studio実装):著者のメインのデフォルトモデル
- gemma-4-12b-qat:より新しく、より小さく、より速く、精度低下は小さい。本チュートリアルのサンプルモデル
💡 ヒント:著者がローカルモデルを実用十分と判断する基準は「まだAPIモデルと突き合わせる必要があるかどうか」。GPT-OSSは彼女の比較回数を大きく減らした最初のモデルであり、Gemma 4シリーズは初めてローカルでエージェントコーディングループを安定して走らせられた。
具体的な手順
ステップ1:LM Studioでモデルをダウンロードして起動
- LM Studioを開き、
google/gemma-4-12b-qatを検索してダウンロードする。 - LM StudioのServerタブでローカル推論サーバーを起動する。デフォルトでは
http://localhost:1234/v1(OpenAI互換エンドポイント)をリッスンする。
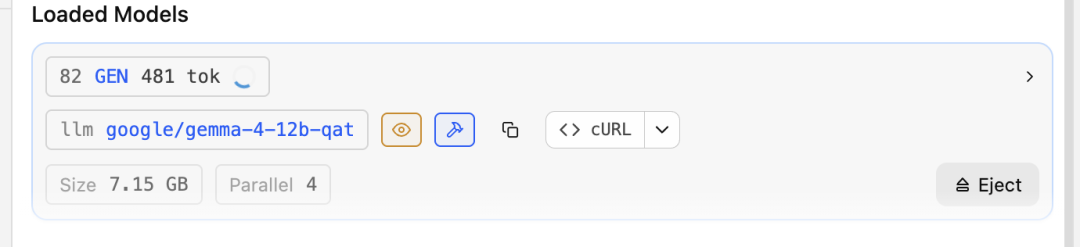
LM Studioの利点は、トークンの流入出をリアルタイムに観察できること、コンテキストウィンドウを調整できること、異なる量子化設定を比較できることだ。
ステップ2:Piのmodels.jsonをローカルエンドポイントへ向ける
すべてのPiセッションはDockerコンテナ内で走るため、Piの models.json を編集し、コンテナ内のPiが host.docker.internal 経由でホスト側のLM Studioへアクセスできるようにする:
"lmstudio": {
  "baseUrl": "http://host.docker.internal:1234/v1",
  "api": "openai-completions",
  "apiKey": "not-needed",
  "models": [
    {
      "id": "google/gemma-4-12b-qat",
      "input": [
        "text",
        "image"
      ]
    }
  ]
}
ステップ3:docker-compose.ymlを書く
services:
  pi:
    build:
      context: .
      dockerfile: Dockerfile
    image: pi-agent:0.74.0
    init: true
    stdin_open: true
    tty: true
    extra_hosts:
      - "host.docker.internal:host-gateway"
    environment:
      OPENAI_API_KEY: ${OPENAI_API_KEY:-not-needed}
      OPENAI_API_BASE: ${OPENAI_API_BASE:-http://host.docker.internal:1234/v1}
    volumes:
      - ${HOME}/.pi/agent/models.json:/config/models.json
      - ${WORKSPACE:-.}:/workspace
      - pi-config:/config
      - pi-sessions:/sessions
    working_dir: /workspace
volumes:
  pi-config:
  pi-sessions:
💡 ヒント:作業ディレクトリをコンテナの
/workspaceにマウントすると、Piはコンテナ内であなたが編集中のリポジトリファイルを変更でき、物理ディスクを直接は操作しない——誤削除を防ぐ重要な安全マットだ。
ステップ4:起動スクリプトでPiを実行
#!/usr/bin/env bash
# Pi — Start the containerized Pi agent.
SCRIPT_DIR="$(cd -- "$(dirname "${BASH_SOURCE[0]}")" && pwd)"
WORKSPACE_DIR="${WORKSPACE:-$(pwd)}"
export WORKSPACE="$WORKSPACE_DIR"

repo_slug="$(basename -- "$WORKSPACE_DIR" | tr -c 'a-zA-Z0-9_.-' '-' | sed 's/^-//')"
[[ -z "$repo_slug" ]] && repo_slug="workspace"
container_name="pi-${repo_slug}-$$"

cmd=(
  docker compose
  --project-directory "$SCRIPT_DIR"
  -f "$SCRIPT_DIR/docker-compose.yml"
  run --rm
  --name "$container_name"
  -e OPENAI_API_KEY
  -e ANTHROPIC_API_KEY
  -e GEMINI_API_KEY
  pi
)
exec "${cmd[@]}"
pi という名前で保存して実行権限を付けたら、作業ディレクトリで ./pi を実行するだけで、隔離サンドボックス付きのローカルエージェントセッションが起動する。
検証結果
著者はこの構成で次のタスクを完了した(いずれも6か月前のローカルモデルには不可能だった):
- あるPythonスクリプト(元はnotebook)を5〜6モジュールを含むリポジトリへリファクタリングし、型ヒントのチェックを行う
- ブログ記事の校正、ユニットテストの作成
- 空の環境に双塔モデルベースの推薦システムリポジトリを構築する
エージェントワークフローのループの精度/速度はフロンティアモデルの約75%に達した。
セキュリティの推奨
著者は3層の引き締めを行っており、そのまま真似する価値がある:
- モデル選択:チュートリアルのサンプルは
gemma-4-12b-qat。参考記事の推奨する26Bより小さく速く、精度低下は小さい。 - サンドボックス隔離:すべてのPiセッションはDockerコンテナ内で走らせ、bash権限のみを与え、Pythonの直接実行やウェブ閲覧は許可しない(ネットワーク調査が必要なら、curlを許可した別イメージを立ち上げる)。
- ディレクトリマウント:Piはコンテナ内で自身のリポジトリファイルを変更し、対象の作業リポジトリの中で起動することで、物理ディスクのファイルを直接消し飛ばすことを避ける。
よくある質問
- 推論速度が遅い:ローカルモデルはハードウェアの制約を受ける。LM Studioより
llama.cppを直接使う方が速く、次の最適化方向だ。 - コンテキストウィンドウが小さい:物理メモリの制約による。著者はエージェント実行時にKVキャッシュが64GB近くまで増えた。
- プロンプトテンプレートの不一致:初期バージョンでよくある問題だが、通常は修正が早い。
- 本番開発に使えるか:著者はまだ不明と明言している。現時点では個人のエージェントワークフロー、モデル挙動の学習、トークン推論過程の研究に向いている。
参考
- 原文(Vicki Boykisブログ):https://vickiboykis.com/2026/06/15/running-local-models-is-good-now/
- Piの参考設定:https://patloeber.com/gemma-4-pi-agent/