
Seedance 2.0 + LibTV キャンバスワークフロー:並ばずに脚本から完成映像まで一気通貫
LibTVプラットフォームはSeedance 2.0フルスペック版を統合し、キャンバス式ワークフローで脚本、絵コンテ、生成、編集の全工程をつなぎます。並ぶ必要はなし。操作チュートリアルと落とし穴回避ガイド付き
Seedance 2.0 + LibTV キャンバスワークフロー:並ばずに脚本から完成映像まで一気通貫
LibTVプラットフォームはSeedance 2.0フルスペック版を統合し、キャンバス式ワークフローで脚本、絵コンテ、生成、編集の全工程をつなぎます。並ぶ必要はなし。操作チュートリアルと落とし穴回避ガイド付き
Jimeng(即夢)の公式サイトでSeedance 2.0を使って動画を生成するには、人生を疑いたくなるほど待たされます。この記事では代替案を紹介します:LibTVプラットフォームです。フルスペック版のSeedance 2.0を統合し、完全に並ぶ必要はなく、さらにキャンバス式ワークフローを提供して、脚本から完成映像までを一気通貫で仕上げられます。
LibTVとは
LibTVは動画生成モデルではなく、プラットフォームです。市場の主要な動画生成モデル(Seedance、Klingなど)をすべて取り込んでおり、一つひとつ登録やチャージをする必要はなく、ひとまとめで済みます。
2025年3月18日に公開され、公開初日のアクセス数は10万を突破しました。
最大の違いはワークフロー設計にあります。 普段の動画制作は分断されています:脚本はあるツール、絵コンテは別のツール、生成はさらに別のツール、編集はCapCutに移動、という具合です。LibTVはこれらをすべてつなぎました:
脚本 -> 動画台本 -> 絵コンテ設計 -> 動画生成 -> 完成映像すべてLibTVの一枚のキャンバス上で完結します。

使い方ガイド
ステップ1:ログインしてプロジェクトを作成
liblib.tvにアクセスし、「作成を始める」をクリックします。インターフェースは従来の動画エディタとはまったく異なり、無限に広がるキャンバスになっています。
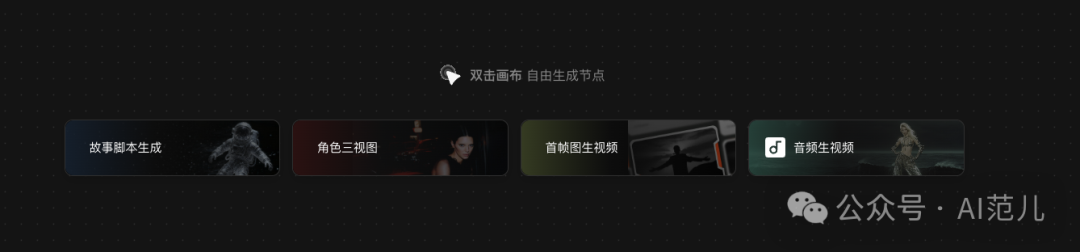
4つのモードから選べます:
- ストーリー台本生成:完全な脚本 -> テキストから動画生成
- キャラクター三面図:キャラクターの見た目の一貫性を維持
- 先頭フレーム画像から動画生成:画像アップロード + プロンプト
- 音楽から動画生成:音声で駆動する動画生成
ステップ2:モードを選んで制作開始
モードA:アニメキャラクターと実写シーンの融合
「先頭フレームから動画生成」を選択し、アニメキャラクター画像をアップロードし、プロンプトを書き、モデル(Seedance 2.0)、長さ、比率を選んで生成をクリックします。
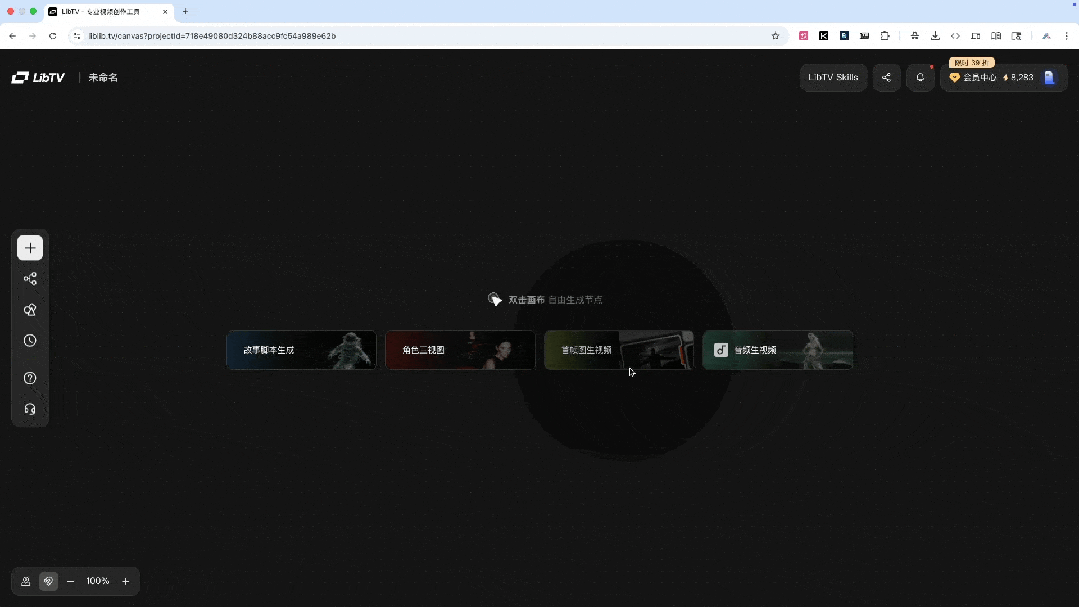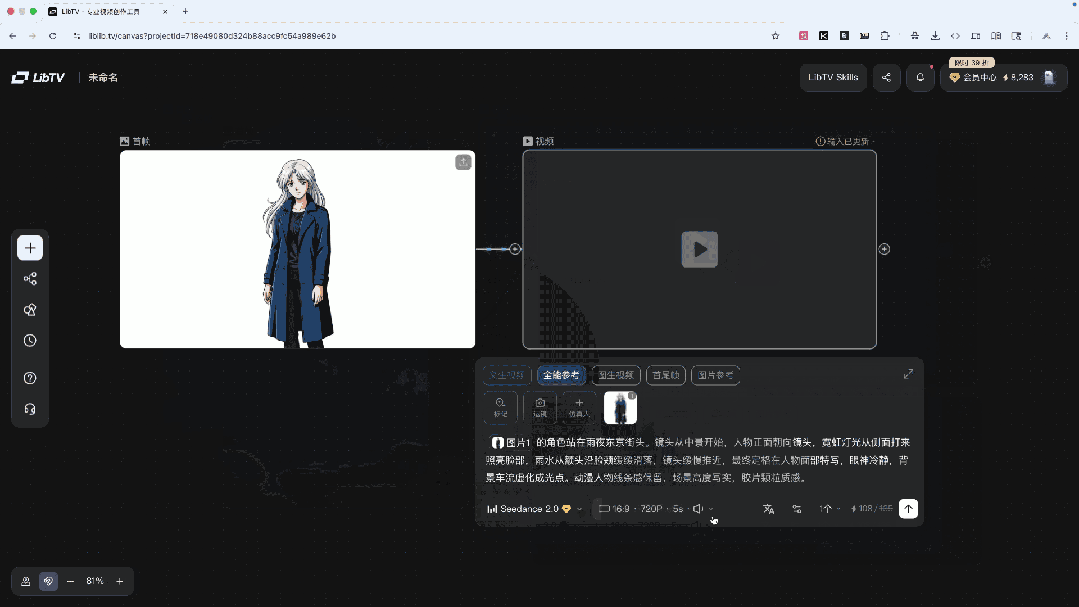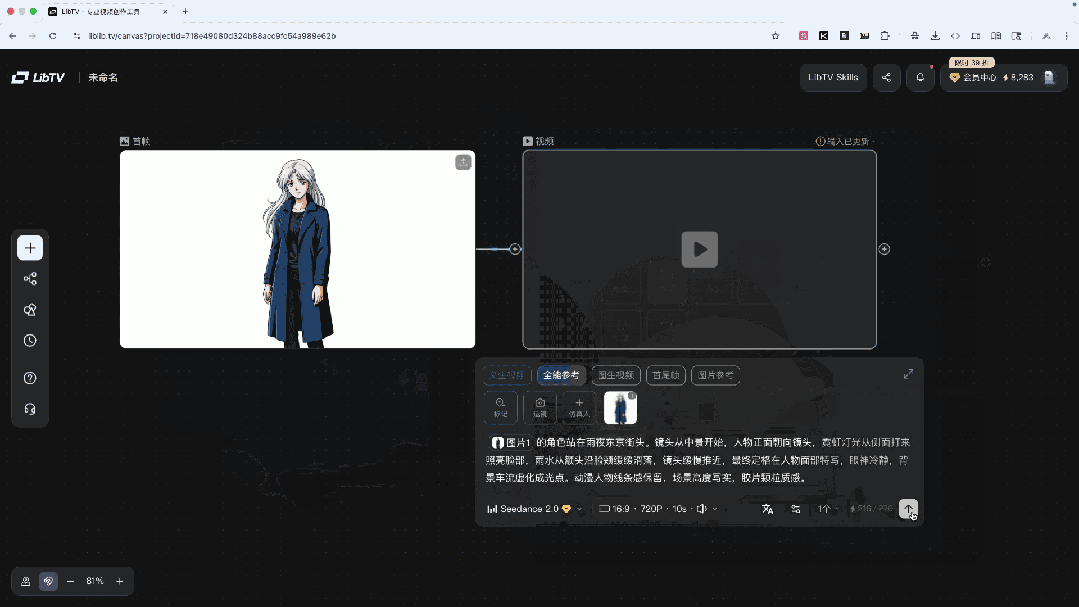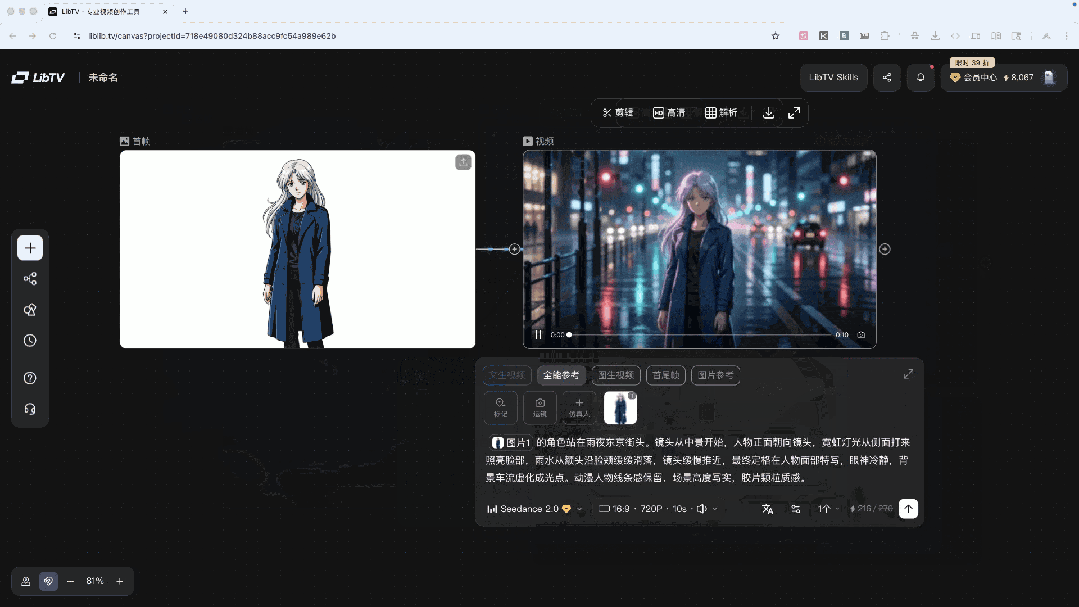
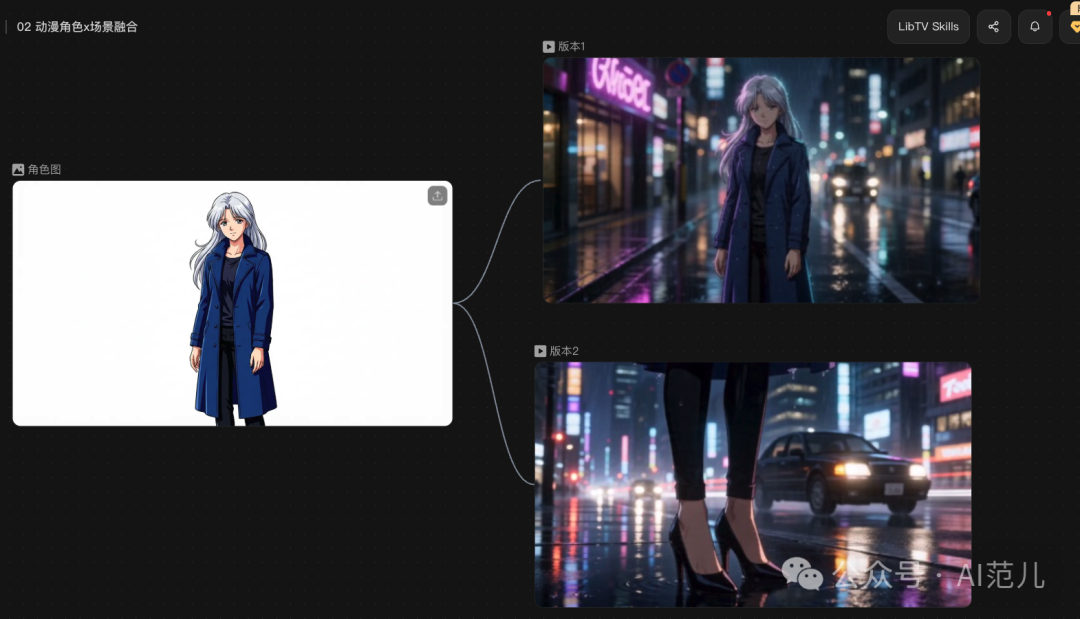
アニメの線の感触は保たれ、背景は写実的なネオンと雨。目立った違和感はなく、光と影の方向も正しいです。
モードB:キャラクターの一貫性 -- 同じ顔で二つの世界
AIで女性キャラクター画像を生成し、同じ1枚の画像から、まったく異なる2本の動画(雨の日のカフェ vs 吹雪の山頂)を生成します。
重要な発見: 2本の動画を通して、キャラクターの髪色、輪郭、顔立ちがかなり安定して保たれています。つまり、動画ごとに顔を変えるのではなく、バーチャルキャラクターと本物の「専属契約」を結び、継続的に出演させられるということです。
モードC:絵コンテ表 -> 動画の一括生成
キャンバス上で完結します:脚本から台本と絵コンテを生成し、動画を一括生成、最後に一括ダウンロードしてCapCutで編集します。
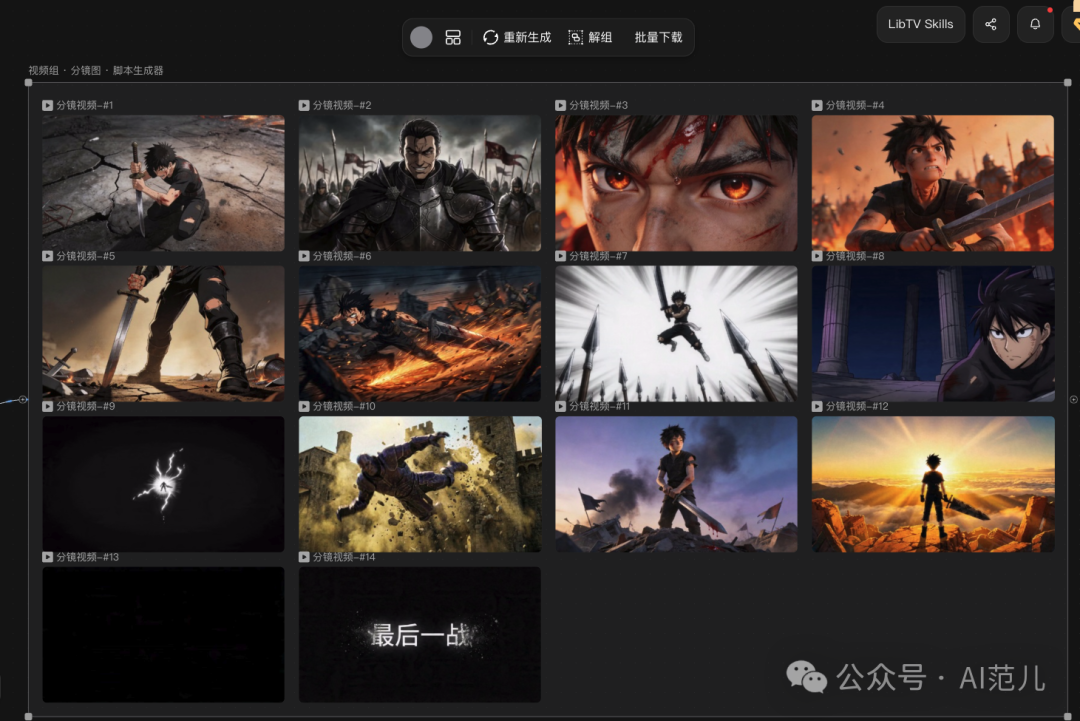
気に入らないシーンがあれば、キャンバス上で直接プロンプトを修正して再実行します。
モードD:音楽駆動の動画
Seedance 2.0は、音楽のビートや音に合わせて動画を生成できます。操作は極めてシンプル:画像と音声を並べて動画生成ノードにつなげ、プロンプトを書いて生成するだけです。
以前はビート同期動画を作るのに手動で一コマずつリズムを合わせていましたが、今は投げ込めば勝手にビートに乗せてくれます。
ステップ3:キャンバス管理のコツ
LibTVのキャンバス設計には、実用的な特徴がいくつかあります:
- 同じ素材を繰り返し使える
- 生成結果に不満があれば、プラスボタンを押してプロンプトを修正し、やり直せる
- すべての結果が無限に広がるキャンバスに並び、一目で全体を見渡せる
- 漫画をそのまま投げ込むと、各コマを絵コンテとして扱って動画を生成してくれる
応用編:AI Agentから直接呼び出す
OpenClaw / AutoClawをインストールしているユーザーは、チャットで直接Agentに動画生成を頼めます:
- Agentに「LibTV API Skillsをインストールして」と伝える
- LibTVのウェブページでAccess Keyを申請する
- 環境変数を設定する:
export LIBTV_ACCESS_KEY="你的访问密钥" - その後はチャットで自然言語でニーズを伝えるだけで、Agentが自動的にLibTVを呼び出して動画を生成し、リンクを返してくれます
落とし穴回避ガイド
実在人物の許諾問題: Seedance 2.0は現在、実在の人物写真をアップロードして動画を生成する機能を停止しており、4月15日以降に再開される見込みですが、許諾確認が必要です。テスト時はまず卡通/アニメキャラクターを使うことをおすすめします。
審査メカニズム: Jimengと同様に、一部のプロンプトはどの単語に問題があるか教えられないまま拒否されます。一語ずつ修正して何度も再提出するしかなく、根気が必要です。
絵コンテの長さバグ: 絵コンテ表で定義した各動画の長さが一括生成時に反映されず、統一した長さしか選べません。
一括生成: 数十本の動画を一括で回すと、たまにプロンプト違反で数本の個別修正が必要になり、ストーリーのつながりが崩れることがあります。
Toolin's Take
こんな人に向いている:
- ショート動画クリエイター(特に漫画動画、ビート同期動画の方向性)
- 一気通貫の動画制作フローが欲しい個人クリエイター
- キャラクターの一貫性を保ったシリーズコンテンツ制作
こんな人には向かない:
- 極限の画質コントロールが必要なプロの映像制作
- 審査メカニズムが気になるユーザー(コンテンツ審査はやや厳しめ)
コアな強み: 待ち時間なし + キャンバスワークフロー + マルチモデル切り替え。この3点の組み合わせは、現時点のAI動画生成分野で最も効率的な制作体験です。もはや「AIが素材を生成し、人が仕上げる」のではなく、「人がアイデアを言えば、AIが直接仕上げる」のです。
料金: LibTV自体は登録して利用し、動画生成では対応モデルのAPIクレジットを消費します。具体的な価格はプラットフォームの表示が基準です。
関連リンク:
- LibTV公式サイト:https://liblib.tv
- Seedance 2.0公式(要待ち時間):Jimeng公式サイト
関連記事
Xiaomi MiMo UltraSpeed:1兆パラメータモデルで1000 tokens/sをたたき出す
XiaomiのMiMo-V2.5-Pro UltraSpeedは、汎用8基GPU構成で1兆パラメータモデルの1000 tokens/s出力を実現。知能を絞ったFlash版ではなくProフルスペック版で、APIはすでに公開され体験申請が可能です。
Tabbit:永久無料のAIブラウザ、10以上のトップモデルが使い放題
美团(Meituan)がリリースしたAIブラウザTabbit V1.0は、コア機能が永久無料。国内トップクラスの大規模モデル10以上とAgent能力を内蔵し、300以上の妙招(スキル)をワンクリックで呼び出せます。
AI社員に海外インフルエンサー探しを任せる:AhaCreator実践ガイド
AhaCreatorでインフルエンサー選定、コンテンツ審査から海外送金まで、海外インフルエンサーマーケティングの全工程をこなす方法を丁寧に解説します。個人開発者と海外展開チームに向いています。
AI長尺動画生成:2つのオープンソースフレームワーク比較レビュー
同日に発表された2大オープンソースフレームワーク、VideoClawとJoyAI-Echo。マルチエージェント協調とクロスモーダル記憶ライブラリという異なるアプローチでAI長尺動画の一貫性問題に挑む両者の技術方案を比較します。
ChatGPTの記憶システムが全面刷新:Dreaming V3登場
OpenAIが全新のDreaming V3記憶アーキテクチャを発表。ChatGPTが裏で「夢を見て」あなたの情報を整理し、初めて10億人の無料ユーザーに開放。Plus/Proは記憶容量が2倍になります。
CloudflareがClaude Managed Agentsに対応:開発者向け実践ガイド
CloudflareがClaude Managed Agents対応を追加しました。開発者はCloudflareプラットフォーム上でClaudeエージェントを実行し、プライベートシステムに接続して、セキュアなAIエージェントデプロイを実現できます。