
Xiaomi MiMo UltraSpeed:1兆パラメータモデルで1000 tokens/sをたたき出す
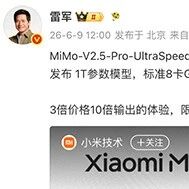
XiaomiのMiMo-V2.5-Pro UltraSpeedは、汎用8基GPU構成で1兆パラメータモデルの1000 tokens/s出力を実現。知能を絞ったFlash版ではなくProフルスペック版で、APIはすでに公開され体験申請が可能です。
Xiaomi MiMo UltraSpeed:1兆パラメータモデルで1000 tokens/sをたたき出す
XiaomiのMiMo-V2.5-Pro UltraSpeedは、汎用8基GPU構成で1兆パラメータモデルの1000 tokens/s出力を実現。知能を絞ったFlash版ではなくProフルスペック版で、APIはすでに公開され体験申請が可能です。
XiaomiのMiMoチームと推論システムチームTileRTが共同発表したところによると、MiMo-V2.5-ProのUltraSpeedモードは、1兆パラメータ(1T)フラッグシップモデルの出力速度として初めて1000 tokens/sを突破しました。さらに重要なのは、これが知能を絞ったFlash版ではなくProフルスペック版だという点です。
つまり、トップクラスの知能水準を保ったまま、速度が約10倍向上したことを意味します。
実際の速度
複雑な可視化ダッシュボードの生成タスクを例にすると:
- UltraSpeed版:13秒で完了
- 標準版:6分15秒
- 同等の結果で最大28倍高速化
実測ではピーク速度は1426 tokens/sに達し、32秒で25624トークンを出力して1000行のコードを生成しました。10秒でスネークゲームを1つ作り、1分でmacOSのシステム画面を再現できます。
技術的な実現方法
Cerebrasのウェハースケール集積やGroqの純粋なオンチップSRAMカスタムチップといった専用ハードウェア路線とは異なり、Xiaomiは汎用GPU上での実現を選び、標準的な8基構成の汎用GPUノードを1台使っただけです。
中心となる技術は3つのパートで構成されます。
1. FP4量子化:大幅なスリム化でも精度を落とさない
- MoE ExpertのみにFP4量子化を適用し、他のモジュールは従来精度を維持
- FP4量子化認識訓練(QAT)により、モデル全体の能力は元のモデルとほぼ同等
- モデルサイズを大幅に縮小し、メモリアクセスのオーバーヘッドを削減
2. DFlash投機的デコーディング:複数のテキスト断片を一括確定
- ブロック単位のマスク付き並列予測方式を採用し、Draft自己回帰の直列制約を解消
- コーディング場面では平均受理長が6.30に達し、各ラウンドで検証する8個のDraftトークンのうち6〜7個を受理可能
- Draftモデルはスライディングウィンドウアテンション(SWA)を採用し、1回の予測の計算量は定数級
3. TileRTカスタムコンパイルカーネル
- 常駐カーネルエンジン:計算パイプラインをGPU内部に常駐させ、継続的に流し続ける
- 非均質パイプライン協調:Tileレベルで通信・データ転送・テンソル計算を細かく分解
- マイクロ秒級のソフトウェア/ハードウェア収束:FP4混合量子化とDFlashに合わせて特別設計
価格とAPI
APIは同時に公開されており、期間限定の体験価格が採用されています。
- 価格はMiMo-V2.5-Proの3倍で、約10倍の出力速度向上を提供
- MiMo-V2.5-Proの価格から換算すると、UltraSpeedは100万トークンあたりの出力で約18人民元
- APIでの体験のみ対応し、現時点ではToken Planには未対応
- 6月9日から6月23日までの期間限定で申請を受け付け、審査を通過したユーザーは2週間の期間限定無料Chat体験を利用可能
実際のシーンでの価値
速度向上は単なる「速さ」ではなく、新しい使い方を解放するものです。
- Agentシーン:タスクの完了見込みが1分なら、終わるまで見守るはずです。5分かかるなら別のことをしに行き、戻ったときには時間を無駄にしているでしょう。10倍の速度は仕事のリズムを直接変えます
- Sub-Agent並行実行:100〜200個のSub-Agentを同時に起動すると、速度が10倍になることで、モデル能力が劣化していない前提では体験の差が非常に大きく出ます
- リアルタイム意思決定ループ:1兆モデルは、高頻度クオンツ取引のシグナル生成や瞬時の不正防止リスク遮断など、時間に極めて敏感なシーンに接続できます
申請窓口
- API申請:https://platform.xiaomimimo.com/ultraspeed
- Chat体験:https://ultraspeed.xiaomimimo.com
- オープンソースの重み(FP4-DFlash):https://huggingface.co/XiaomiMiMo/MiMo-V2.5-Pro-FP4-DFlash
ヒント: 現時点で高い受理率は依然としてコーディングなどの構造化タスクに集中しており、汎用対話シーンにはまだ最適化の余地があります。推論リソースはやや逼迫しており、大規模な商用利用にはまだ時間がかかります。
関連記事
Claude Codeの検証ループ:組込みSkill 4種でAIにコードを自己チェックさせてから納品する
Claude Code内蔵の /code-review、/simplify、/verify、/design という4つのSkillで検証レイヤーを構築し、AIが書き終えたコードを納品前にセルフチェックさせる方法を解説します。
Logi Options+で古いマウスをAIワークフローコントローラーに改造する(ゼロコストレシピ)
ロジクール公式無料ドライバー Logi Options+ の Smart Actions、Actions Ring、アプリ別設定を使えば、どんなロジクールマウスも Vibe Mouse に早変わり。230ドルの Codex Micro キーボードを DIY で代替する方法を紹介します。
Loom:Coding Agentにエンジニアリング状態のレイヤーを外付けし、長時間タスクの部分的な記憶喪失を治す
オープンソースツールの Loom は、Claude Code / Codex といったコーディングエージェントに独立した構造化エンジニアリング状態レイヤーを与え、長時間タスクの自動セーブポイントとマルチエージェントによるゼロコスト引き継ぎを実現します。
Jetson-PI:北京大学発オープンソースのVLAエッジリアルタイム制御、Jetson Orinで制御周波数が8.66倍に
北京大学 AIRS と PrimeBot が Jetson-PI(Apache-2.0)をオープンソース化。FAAC 非同期推論 + 確信度スケジューリング + llama.cpp エンジンの三段構えで、π0.5 を Jetson Orin 上で 0.70Hz から 6.06Hz へ引き上げ、精度は落としません。
JiuwenSwarm:Huawei系オープンソースのマルチエージェント統合ワークベンチ、人がそのままエージェントチームに入っていく
openJiuwen がオープンソースで出した JiuwenSwarm(Apache-2.0)は、オフィス / Code / 娯楽を統合ワークベンチへまとめ、人機協調の新パラダイム HITS を発表。pip 一行で入れてすぐ使い始められます。
OpenWorker:呉恩達(Andrew Ng)がオープンソース化したデスクトップAI同僚、成果物をそのまま納品できる
呉恩達(Andrew Ng)がオープンソース化した OpenWorker(MIT)は、ローカル優先・モデル非依存のデスクトップ Agent。25以上のツールに接続し、「顧客向けブリーフを準備して」を、開ける成果物のドキュメントに変えてくれます。