
Step 3.7 Flash 実測:400TPS の超高速推論、Agent タスクのコストは Claude のわずか1/9
StepFun が Step 3.7 Flash を発表。400トークン/秒の推論速度で、11B の活性化パラメータで Claude Opus 4.6 の97%の性能を実現。オープンソースでローカルデプロイも可能
Step 3.7 Flash 実測:400TPS の超高速推論、Agent タスクのコストは Claude のわずか1/9
StepFun が Step 3.7 Flash を発表。400トークン/秒の推論速度で、11B の活性化パラメータで Claude Opus 4.6 の97%の性能を実現。オープンソースでローカルデプロイも可能
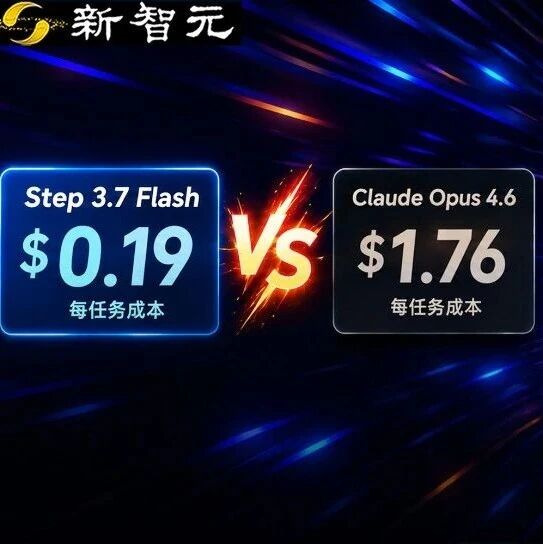
StepFun(階躍星辰)は Step 3.7 Flash を発表しました。本番グレードの Agent に向けた新世代の Flash モデルです。その核心的なセールスポイントは実に直球です。400 TPS の推論速度、タスクあたりのコストは Claude Opus 4.6 のわずか 1/9、そして 97% の性能を実現しています。
これはまた小さなモデルがベンチマークを賑わすだけの話ではありません。Step 3.7 Flash は 11B の活性化パラメータを持つ MoE モデルで、すでにオープンソース化されており、mlx-vlm による Apple Silicon 上でのローカル実行をサポートします。
Step 3.7 Flash は新世代の Agentic ベースモデルとして位置づけられる
Step 3.7 Flash とは
Step 3.7 Flash は、StepFun が Step 3.5 Flash(かつて OpenRouter Trending の頂点に立ち、OpenClaw の呼び出し量で世界一)に続いて発表した最新世代の Flash モデルです。
核心スペック:
- アーキテクチャ:MoE、11B の活性化パラメータ
- 視覚理解:196B + 1.8B ViT
- 推論速度:400 TPS
- オープンソース化済み:mlx-vlm をサポートし、128GB の Apple Silicon デバイスで 32K コンテキストを実行可能
その設計思想はなかなか興味深いものです。11B 活性化の Flash モデルにとって、膨大な視覚知識を無理に重みへ詰め込むのは割に合いません。StepFun は重みの中に最も核心的な推論エンジンだけを残し、知覚の境界と世界知識は推論段階へ外挿します。極めて高速な速度で「何度も見て、何度も調べる」ことで、パラメータ量の不足を補うのです。
5つの実測シーン
シーン1:領収書の経費精算を一括処理
適当に撮った12枚の領収書(角度が歪んだもの、ピンボケのもの、飲食、電子製品、出張が全部混ざっている)を Step 3.7 Flash に投げます。モデルは各領収書の金額、税額、加盟店名を認識するだけでなく、どのフィールドが経費精算で実際に記入すべきものかを判断し、統一された表に自動で整理し、ワンクリックで Excel にエクスポートできます。
走り切ったのは「認識 -> 理解 -> 整理 -> エクスポート」という完全なチェーンです。
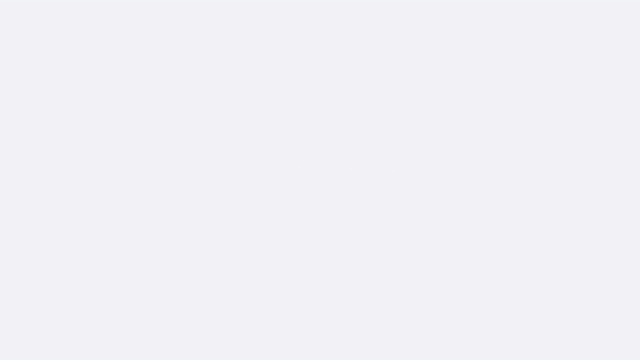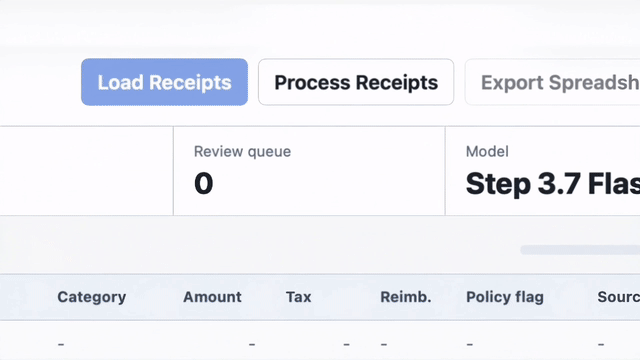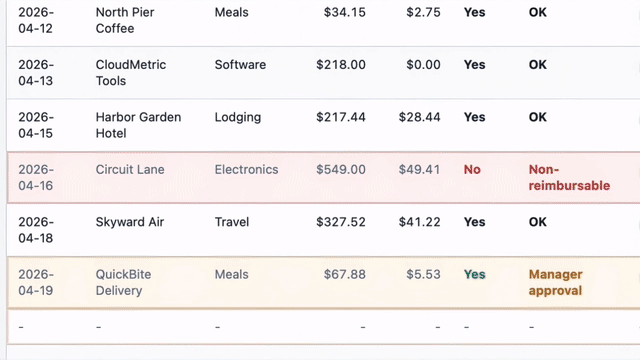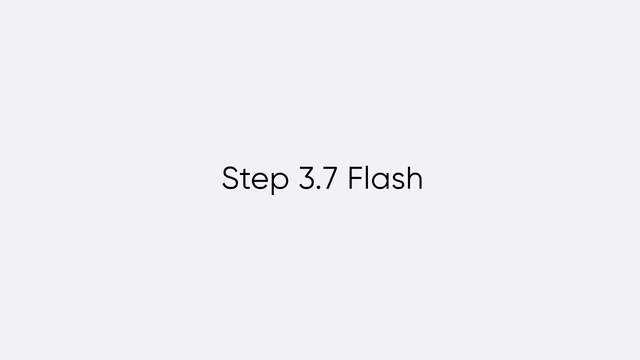
領収書の情報を自動認識して表に整理
シーン2:専門ソフトの UI を読み解く
Blender の UI スクリーンショットに対して「この立方体を削除するには」と尋ねると、モデルは自動で画面を枠選択し、アウトラインリスト、ツールバー、現在の編集モードを読み取り、1歩ごとに具体的な操作手順を提示します。Blender のような情報密度が爆発する 3D ソフトで実行可能な操作提案を出せるということは、専門ツールに進出する能力をすでに備えていることを意味します。
シーン3:航空機コックピットの操作ガイド
モデルに、計器がぎっしり並んだ航空機コックピットのスクリーンショットを与え、「どうやって離陸するのか」だけを入力します。すると自動でコックピット領域を枠選択し、各主要計器の意味を認識し、操作順序を整理して、いつスロットルを押し込み、いつ降着装置を格納するかを1歩ずつデモします。
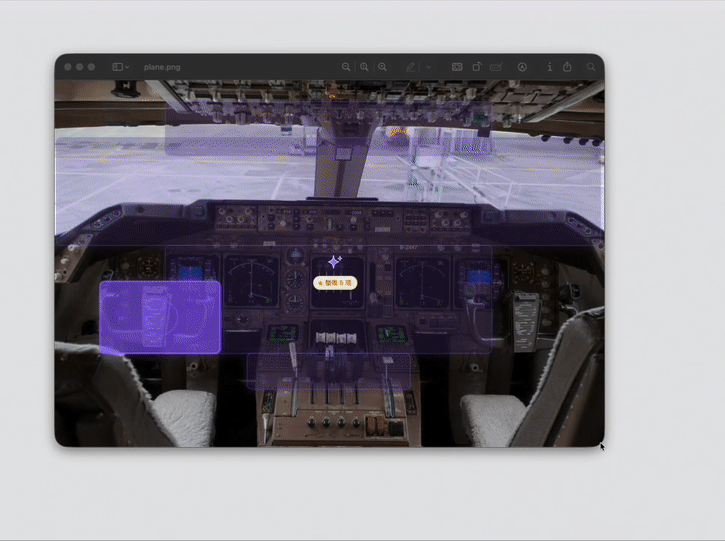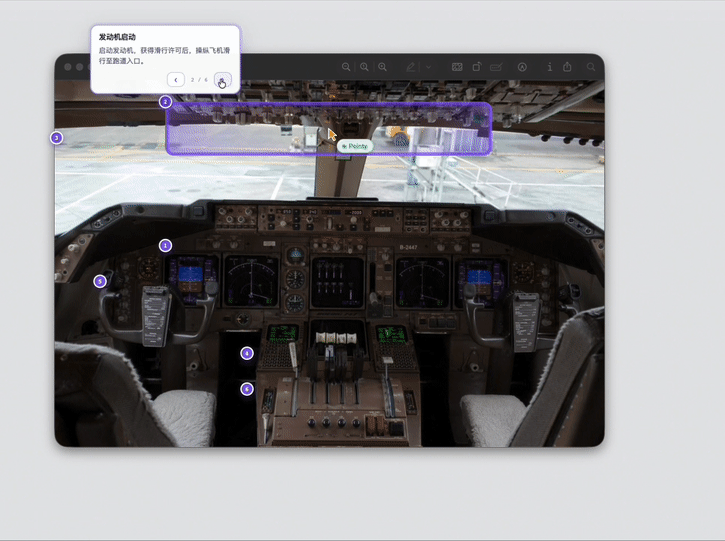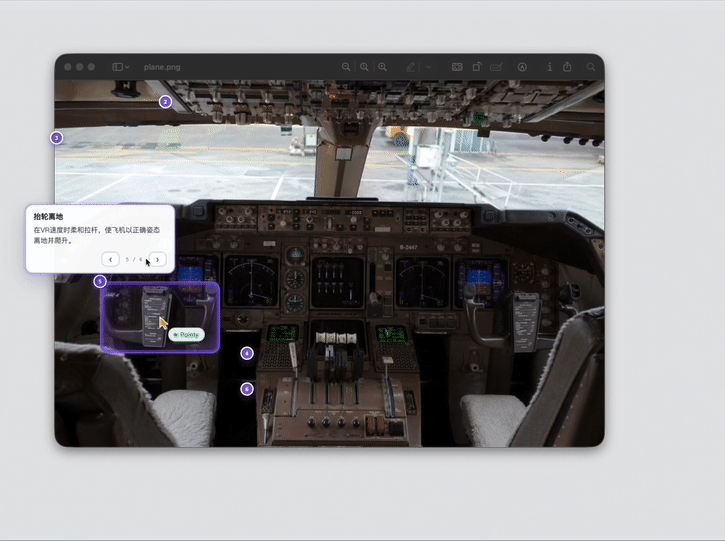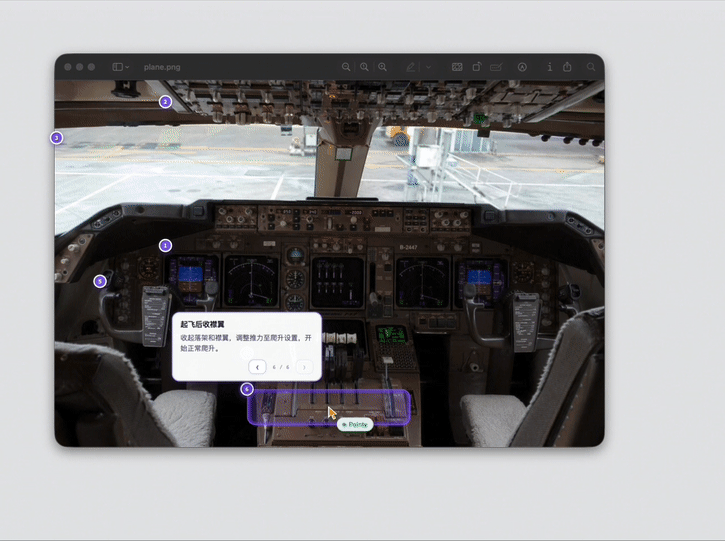
「画面が読める」から「操作を教えられる」へ、難度は1オーダー上がる
シーン4:高速 Deep Research
1つの文章を与えます。「2026年ヒューマノイドロボットの量産をテーマに、意思決定できる1ページのサマリーを」。すると返ってきたのはリンクの山ではなく、冒頭で判断を下し、中盤で表を使って6社(テスラ、Figure、Unitree、Agibot、1X、Agility)の量産進捗とリスクを比較し、結びで時期付きの実行可能な注目ポイント3つを示した完全なレポートでした。すべての数字の後ろに出典が付いています。
シーン5:GUI 理解と Computer Use
CapCut のスクリーンショットと「この素材を 1080P、30 フレームで書き出して」という1文を与えます。モデルは書き出しボタンの位置を特定しただけでなく、現在のカラーフォーマットが 1080P ではなく 1080i(インターレース)であることを自発的に発見し、手動での変更を促しました。さらに、タイムラインに素材が1本ではないことまで気づき、「書き出されるのはプロジェクト全体で、この断片だけではない」と指摘までしました。
UI を読み取るだけでなく、ユーザーが見落としがちな細部まで発見できる
興味深い創発的な振る舞い
フロントエンドのコードを書き終えると、Step 3.7 Flash は自分で GUI に切り替えて、生成したばかりのページをテストします。レンダリング結果を確認し、インタラクティブなボタンをクリックし、見た結果に基づいてコードに戻って修正します。
コードを書く -> 画面を見る -> コードを直す。この「連続技」は誰にも教わっておらず、自分で会得したものです。
性能データ
| 指標 | Step 3.7 Flash | 比較 |
|---|---|---|
| 推論速度 | 400 TPS | 業界トップクラス |
| タスクあたりコスト | Claude Opus 4.6 の 1/9 | 89% のコスト削減 |
| 性能比較 | Claude Opus 4.6 の 97% | 差はわずか 3% |
| Visual Benchmark (V) | 95.3 | Kimi K2.6 (96.9) に対抗 |
| 活性化パラメータ | 11B | MoE アーキテクチャ |
海外開発者の反応
- Gemini 3.5 Flash から Step 3.7 Flash に切り替えた開発者が、7個以上のバグを一気に発見した
- 「速さが異常」との声も
- mlx-vlm をサポートし、Apple Silicon 上で 4-bit 量子化により 32K コンテキストを実行可能
- 初めて他のモデルの代替として真剣に検討すると述べた開発者もいた
使い方
API 呼び出し:OpenRouter または StepFun 公式 API 経由で接続します。
ローカルデプロイ:オープンソース化済みで、mlx-vlm フレームワークをサポート。128GB メモリの Apple Silicon デバイスでは、4-bit 量子化版で 32K コンテキストを実行できます。
誰に向いているか
- Agent 開発者:本番グレードの Agent ワークフローを支える低コスト・高スループットのベースモデルが必要
- 企業ユーザー:領収書、ドキュメント、スクリーンショットなどの視覚集中型タスクを一括処理する必要がある
- 個人開発者:ローカルデプロイでプライバシーを守れる AI モデルが必要
- Deep Research シーン:意思決定サマリーと情報統合を素早く生成する必要がある
- GUI 自動化:デスクトップアプリの UI を Agent に理解・操作させる必要がある
よくある質
Q:Step 3.7 Flash とフラッグシップモデルの差は大きい? A:Agent タスクでは Claude Opus 4.6 の 97% の性能に達しつつ、コストはわずか 1/9 です。大多数の本番シーンでは、この差は許容範囲です。
Q:ローカルで動かせる? A:動かせます。オープンソース化済みで mlx-vlm 対応。128GB の Apple Silicon デバイスなら 4-bit 量子化で 32K コンテキストを実行できます。
Q:Step 3.5 Flash と比べて向上した点は? A:主に視覚理解、GUI 操作、Deep Research、コード生成で大幅に向上し、同時に Flash シリーズの速度とコスト面の優位性を維持しています。
Q:商用利用に制限はある? A:オープンソース化済みです。具体的なライセンス条項は公式 GitHub リポジトリを確認してください。
関連記事
Hyra-1.0:Tencent 混元の科学発見インテリジェントエージェント
再帰的自己改善ができるリサーチエージェント。AI 学習の最適化、数学の未解決問題、量子コンピューティング、創薬をカバーし、複数の記録を更新しました。
Meshy:20秒でテキストと画像を実用的な3Dモデルに変える
AI の text/image-to-3D ツール。2ステップワークフローに対応し、FBX/OBJ/GLB/STL を書き出せ、公式 API とプラットフォームプラグインを提供しています。
Qwen-Image-3.0:Alibaba Qwen の第3世代画像生成モデル
4.5k token の超長入力、10px 級の小文字までクリアにレンダリング、12言語に対応。ポスター、試験問題、コマ割り漫画などの複雑なレイアウトを一発で出力できます。
Qwen 3.8 で Reddit 自動の海外顧客獲得ワークフローを組む
8ステップ完全自動フロー: Apify で投稿取得、Qwen 3.8 が採点/執稿/自己審査/振り返り。260 件の投稿から 22 件のチャンスをふるい出し、コストは 10 分の 1 に削減。
Qwen-Audio-3.0-TTS:感情を表現できる音声合成モデル
アリババ Qwen の新世代 TTS モデル。タグで笑い・呼吸・怒りを制御でき、48kHz の映像級サウンド。Speech Arena で世界首位に立った実力を解説します。
Qwen3.8-Max プレビュー版をいち早く試す方法
2.4T パラメータの Qwen フラッグシップのプレビュー版が Token Plan、Qoder、Qwen 公式サイトに登場。公式は総合性能を Fable 5 次点としています。