
ToolCUA:AgentがGUIとツールの間で正しく経路を選べるようになる
復旦大学×通義がオープンソース化したCUA訓練パラダイム。8BモデルがOSWorld-MCPで46.85%の精度を達成し、Claude-4-Sonnetを上回りました。コードとモデル重みは公開済みです。
ToolCUA:AgentがGUIとツールの間で正しく経路を選べるようになる
復旦大学×通義がオープンソース化したCUA訓練パラダイム。8BモデルがOSWorld-MCPで46.85%の精度を達成し、Claude-4-Sonnetを上回りました。コードとモデル重みは公開済みです。
AgentにGUI操作とツール呼び出しを同時に接続すると、精度は逆に下がってしまいます——ボタンをクリックすべき場面でAPIを呼び、APIを呼ぶべき場面でメニューに固執する、という具合に両方へ迷走します。復旦大学と通義実験室のMobileAgentチームが共同でオープンソース化した ToolCUA は、まさにこの問題を解決するものです。モデルに、いつGUIで進み、いつツールへ切り替え、いつツールを呼ぶべきでないかを学ばせます。
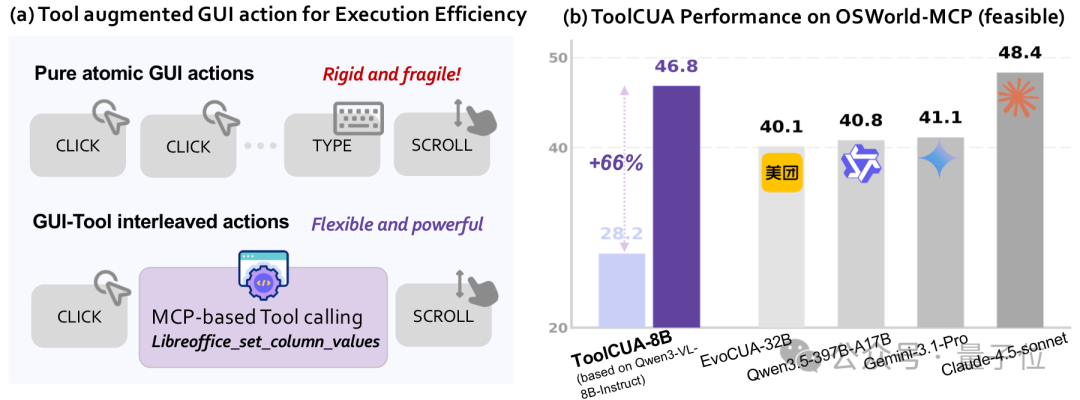
ToolCUA-8BはOSWorld-MCPで46.85%の精度を達成し、Claude-4-Sonnetの43.54%を上回り、Claude-4.5-Sonnetの48.35%に迫りました。コードとモデル重みは全面的にオープンソース化されています。
問題:混合アクション空間における経路の混乱
従来のCUA(Computer Use Agent)は主にGUI操作——クリック、入力、ドラッグ、スクロール——に依存しています。汎化性は高いものの、ステップが長く、誤差が蓄積しやすい。一方、ツール呼び出し(Tool Calls)は往々にしてより効率的で正確です。たとえばLibreOfficeでスプレッドシートをバッチ処理する場合、1回のAPI呼び出しが長々とした一連のメニュークリックを代替できます。
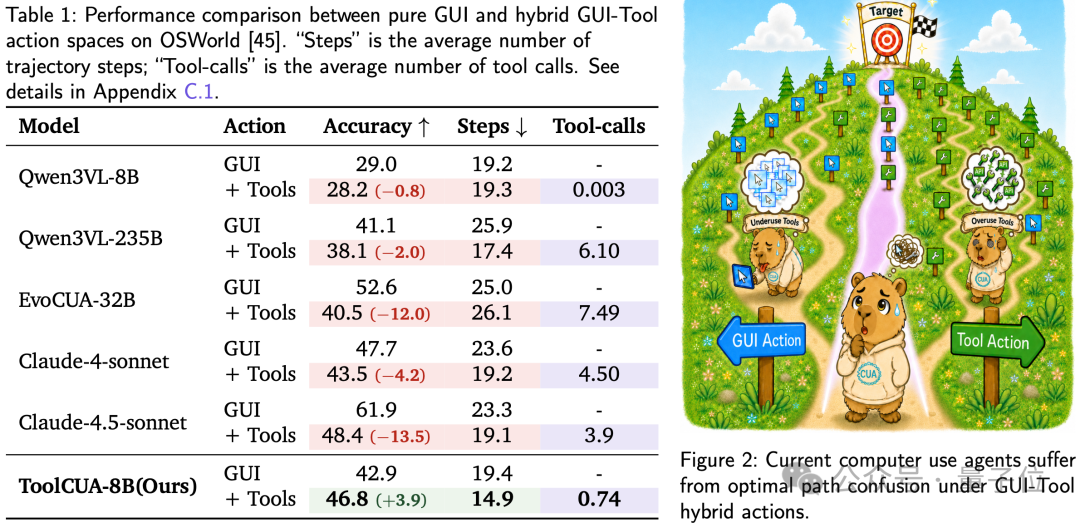
最も自然なアプローチは、AgentにGUIとToolの両方を持たせることに見えます。しかし実験からは、直感に反する事実が見つかりました:
| モデル | ツールなし精度 | ツールあり精度 | 変化 |
|---|---|---|---|
| Qwen3VL-8B | 29.0% | 28.2% | -0.8% |
| Qwen3VL-235B | 41.1% | 38.1% | -3.0% |
| Claude-4-Sonnet | 47.7% | 43.5% | -4.2% |
| Claude-4.5-Sonnet | 61.9% | 48.4% | -13.5% |
モデルが強いほど、ツール追加後の精度低下が深刻になります。Claude-4.5-Sonnetに至っては13.5ポイントも落ちました。問題はツールの有無ではなく、モデルがGUIとToolの間で経路を選べないことなのです。
2段階の訓練アプローチ
フェーズ1:データ合成とTool-Bootstrapped RFT
高品質なinterleaved GUI-Tool軌跡データは非常に希少です。ToolCUAのアプローチは、既存のGUI-onlyデータを活かして混合軌跡を自動合成することです。
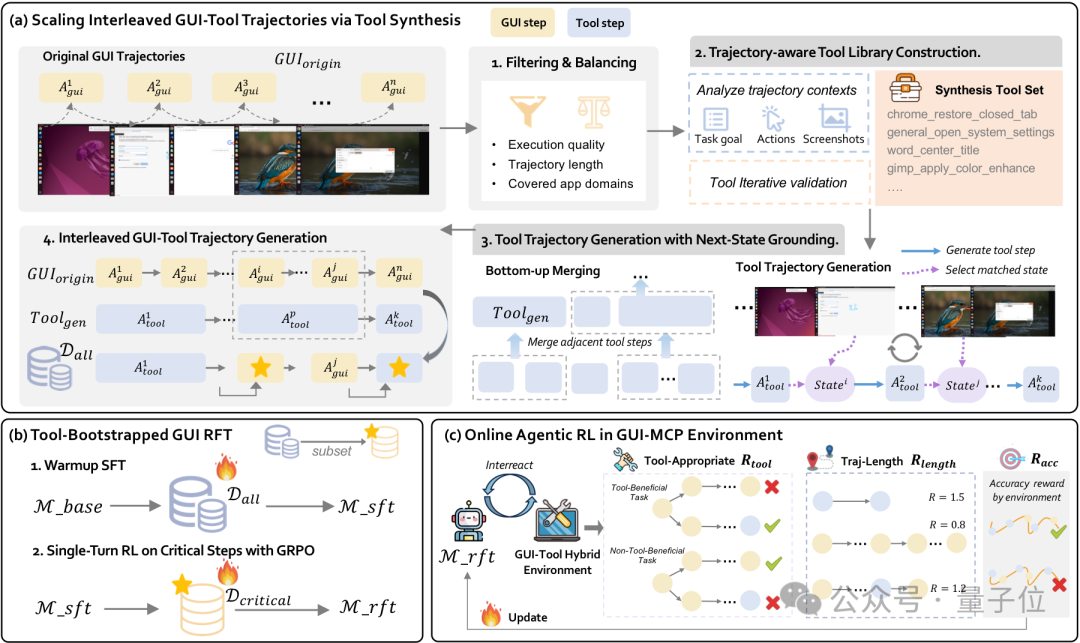
パイプライン全体は3つのステップに分かれます:
- GUI軌跡からツールライブラリを抽象化:各GUI軌跡のタスク目標、アクション系列、スクリーンショット記述を分析し、実際の操作フローから呼び出し可能なツールを抽象化します。たとえばChromeの設定フローから
chrome_open_language_settingsを抽象化します。 - 等価なツール軌跡を生成:合成ツールライブラリと元のGUI軌跡から、機能的に等価なtool-only軌跡を生成し、next-state groundingでツールステップと状態変化の一致を検証します。
- 交互混合軌跡を生成:すべてのGUI操作を単純にツールへ置き換えるのではなく、一部のツール呼び出しをランダムにサンプリングして対応するGUIサブシーケンスへ置き換え戻し、GUIとToolが交互に入り混じる複数の軌跡を形成します。これによりモデルは、異なる意思決定境界における切り替え点を観察できます。
最終的に、約4k個のunique toolsと180k stepsのwarmup SFTデータ、および5k件のcritical stepsのsingle-turn RLデータが産出されます。
フェーズ2:Online Agentic RL
フェーズ1が解決するのは「ツールを使えるようになる」ことで、フェーズ2が解決するのは「実際の環境でtrajectory-levelの経路選択を学ぶ」ことです。
中核は Tool-Efficient Path Reward で、2つの専用報酬を含みます:
- R_tool(ツール適切性報酬):報酬が与えられるのはツール呼び出しが多いことではなく、正確な振る舞いです——ツールに向いたタスクで実際にツールを使い、ツールに向かないタスクでむやみにツールを使わないこと。
- R_length(経路効率報酬):group-relative comparisonを行い、ある成功軌跡がグループ内平均より短ければ、線形のbonusを与えます。モデルがより効率的な実行経路を発見するよう促します。
鍵となる設計は、この2つの報酬が成功した軌跡でのみ有効になる点です。これにより、モデルが失敗した実行から誤った選好を学ぶのを防いでいます。
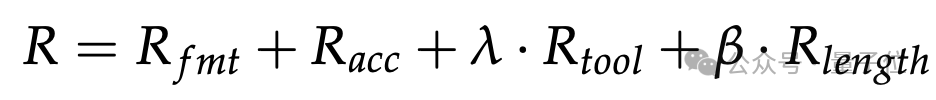
評価結果
OSWorld-MCP メイン評価
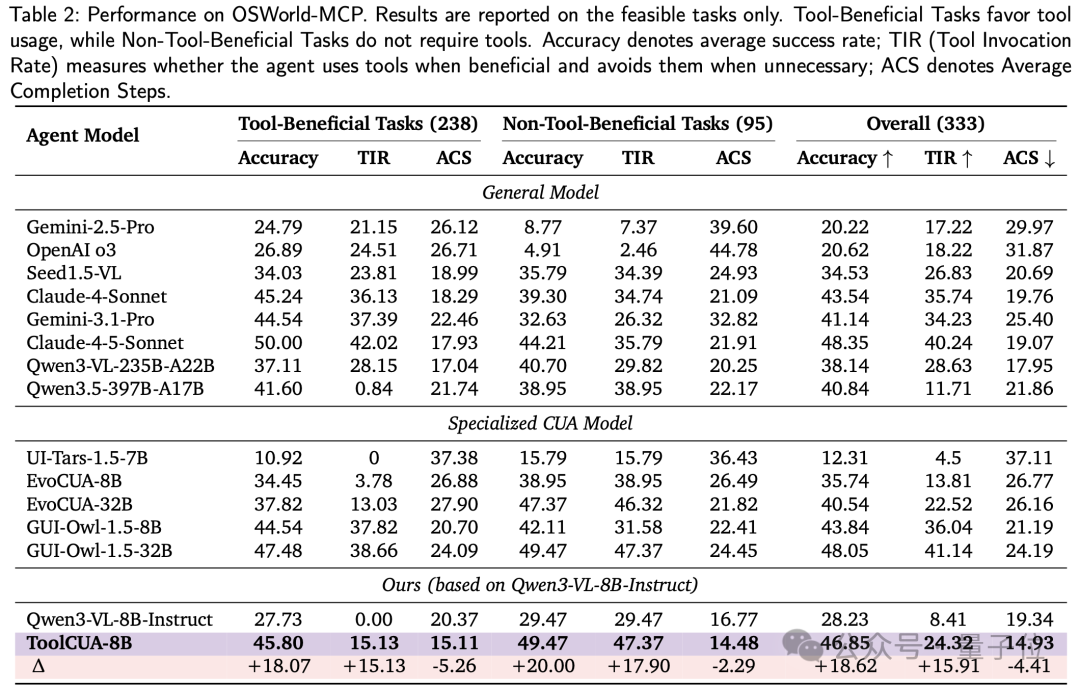
| モデル | Accuracy | ACS(平均ステップ数) |
|---|---|---|
| Qwen3-VL-8B(ベースライン) | 28.23% | 19.34 |
| GUI-Owl-1.5-8B | 43.84% | - |
| Claude-4-Sonnet | 43.54% | - |
| ToolCUA-8B | 46.85% | 14.93 |
| Claude-4.5-Sonnet | 48.35% | - |
ToolCUA-8BのACSはわずか14.93 stepsで、全モデル中最低です。より多くのタスクを完了しただけでなく、より短い経路でタスクを完了することも学んでいます。ベースライン比で相対的に約66%の向上です。
クロスプラットフォーム転移
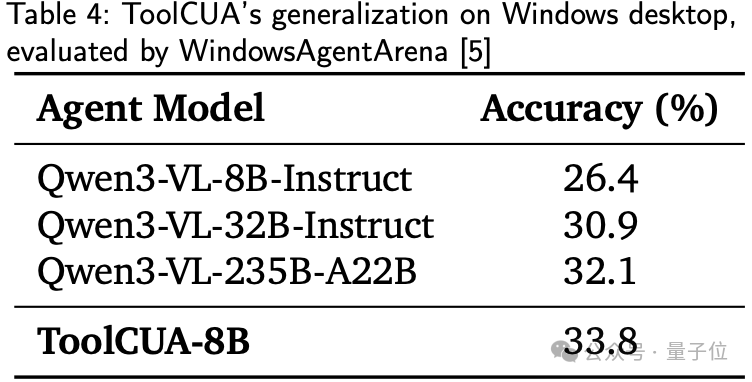
WindowsAgentArenaでは、訓練データがすべてLinuxデスクトップ環境由来にもかかわらず、ToolCUAはunseenなWindowsデスクトップアプリで33.8%の精度に達し、Qwen3-VL-8B(26.4%)、Qwen3-VL-32B(30.9%)、Qwen3-VL-235B(32.1%)を上回りました。学んだのは特定タスクのテンプレートではなく、転移可能な混合アクション編成能力です。
アブレーション実験:ToolCUAが本当に経路選択を学んだ理由
3つの重要な結論:
1. interleavedデータがないと、online RLは安定したツール呼び出しを学べない
baselineから直接online agentic RLを行うと、TIR(ツール呼び出し率)は長期にわたって低く、訓練後期でも約15%にとどまり、tool callsは訓練の大部分でほぼ0でした。モデルはまずinterleaved supervisionを通じて、ツールの知識と切り替えの事前知識を得る必要があります。
2. Tool-Efficient Path Rewardがないと、経路が不安定になる
R_toolとR_lengthを外すと、accuracy曲線は明らかに不安定になり、訓練step 8-11あたりで低下が見られ、最終的に完全なToolCUAとの間に約7ポイントの差がつきました。
3. Hybrid訓練はpure GUI訓練より効果的
GUI-onlyパイプラインはbaselineの29.03%からagentic RL後に42.05%へ向上。一方、GUI+ToolパイプラインではRFTの時点で38.13%に達し、完全なToolCUAはさらに46.85%に到達しています。
実際の事例:GUIとツールの協調
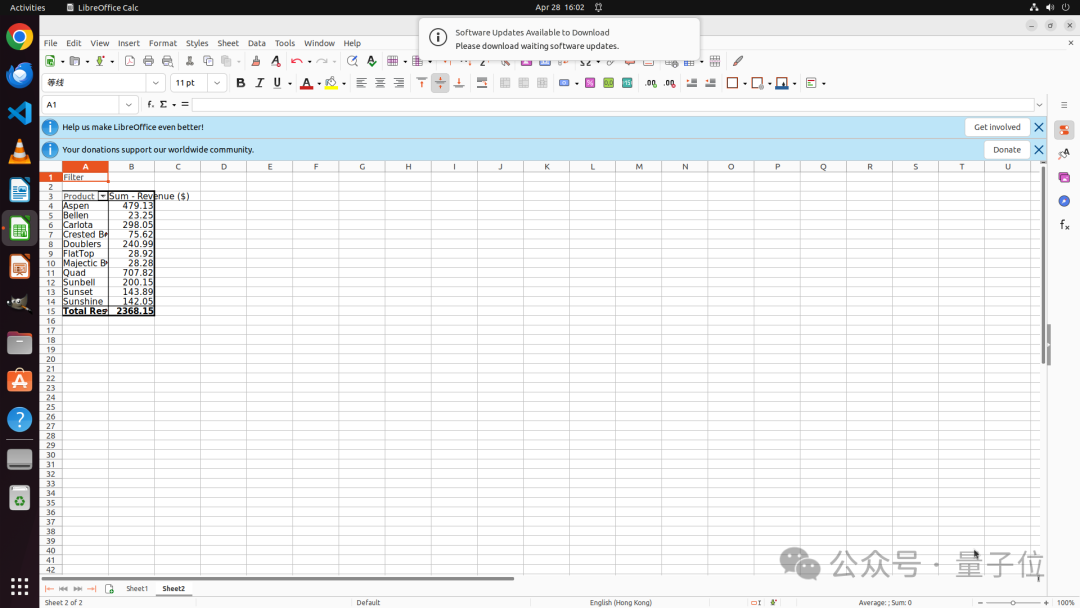
事例1:LibreOffice Calcでピボットテーブルを作成
GUI-onlyの方法では、データ範囲の選択、メニューを開く、フィールドの設定、パラメータの確認が必要で、ステップが長くミスも起きやすくなります。ToolCUAはまずツールを呼んでworkbookの情報とsheetの内容を読み、データ構造を識別し、その後 create_pivot_table を直接呼び出してピボットテーブルを生成します——脆いステップバイステップのGUIナビゲーションを、構造化ツールで置き換えるのです。
事例2:VS Codeにフォルダをworkspaceへ追加
ToolCUAはまず add_folder ツールで2つのディレクトリをworkspaceに追加します。しかし完了後にVS Codeが「Do you trust the authors?」ダイアログを表示しました——この状態はツール呼び出しでは完結できません。ToolCUAは自動的にGUI actionへ切り替えて確認ボタンをクリックし、最後の一歩を完了します。
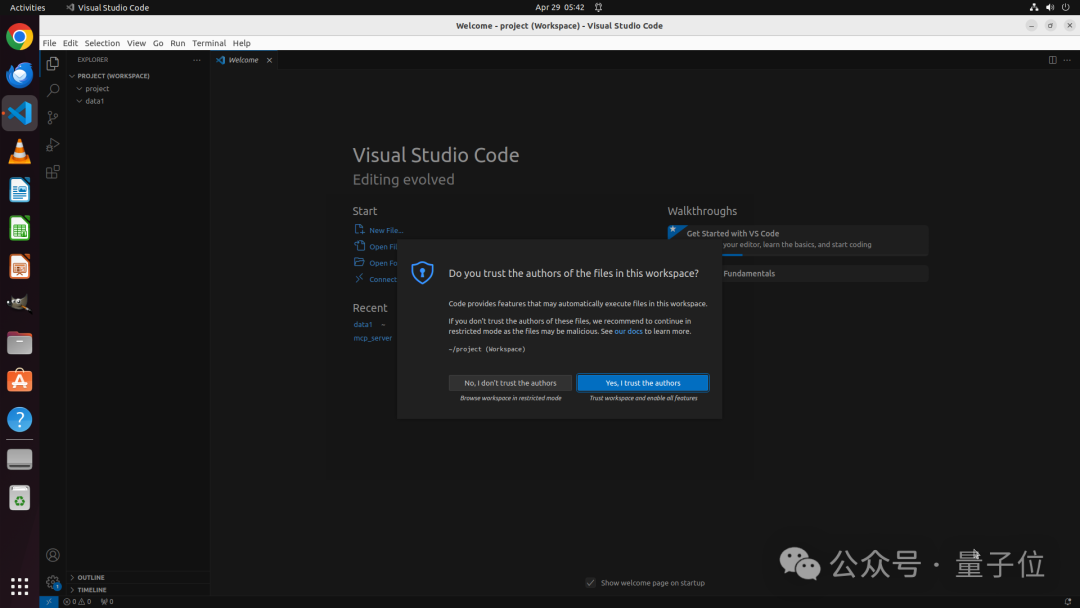
これこそToolCUAの中核能力です。ToolですべてのGUIを置き換えるのでも、純粋なGUI操作に退くのでもなく、実際の環境の中で2つのアクション空間の協調と切り替えを学ぶことです。
入手方法
- プロジェクトサイト:https://x-plug.github.io/ToolCUA/
- コードリポジトリ:https://github.com/X-PLUG/ToolCUA
- モデル重み:https://huggingface.co/mPLUG/ToolCUA-8B
- Mobile-Agentシリーズ:https://github.com/X-PLUG/MobileAgent
向いている人
- CUA/Agent研究者:Computer Use AgentやGUI自動化を研究する学術・エンジニアリングチーム
- デスクトップ自動化開発者:実際のデスクトップ環境でGUI+ツールの混合操作を実現したいエンジニア
- オープンソースモデルユーザー:8Bパラメータの小規模モデルで、Claude-4.5-Sonnet級のデスクトップ操作効果に近づけたい開発者
ToolCUAは重要な現象を明らかにしました。混合アクション空間では、既存のCUAや強力な基盤モデルに明確な経路の混乱が生じます。この問題を解く鍵は、より多くのツールを与えることではなく、モデルに経路選択を学ばせることです。