
Vidu S1:デジタルヒューマンとリアルタイム対話するオープンソース級の対話型動画モデル
生数科技のVidu S1がリアルタイム音声駆動の動画生成を実現。540P/25FPSでコンシューマーGPUでも動き、画像1枚が瞬時に会話できるデジタルヒューマンに変わる。
Vidu S1:デジタルヒューマンとリアルタイム対話するオープンソース級の対話型動画モデル
生数科技のVidu S1がリアルタイム音声駆動の動画生成を実現。540P/25FPSでコンシューマーGPUでも動き、画像1枚が瞬時に会話できるデジタルヒューマンに変わる。
動画生成モデルの競争は、「誰がより美しく生成できるか」から「誰がリアルタイムにインタラクトできるか」へと移りつつある。従来はプロンプトを入力し、数十秒待って固定長の完成映像を受け取るだけだった。いま生数科技がリリースした Vidu S1 は、動画生成を「ビデオ通話」モードへ推し進めた——あなたが一言話すと、それは聴きながら対応する画面を生成し、いつでも割り込めるし、指示を変えられるし、何時間続けても切断されない。デジタルヒューマン、バーチャルコンパニオン、インタラクティブ配信、AI Characterに取り組んでいるなら、Vidu S1は触って遊ぶ価値がある。
Vidu S1とは
Vidu S1 は、生数科技(清華大学の朱軍教授チームによる創業)が2026グローバルデジタル経済大会で発表したリアルタイム対話型動画生成モデルだ。「AI版ビデオ通話」と考えてよい——ただし向かいに座っているのは真人ではなく、モデルがフレームごとに生成するキャラクターだ。
従来のデジタルヒューマン手法(先にモデリング、次に訓練、最後にリップを駆動する口型合成)とは異なり、Vidu S1 は完全生成式の路線を取る:最初の1フレームの画像をアップロードすると、モデルは即座にキャラクターのアイデンティティ、外見、スタイルを理解し、対話の中で表情、リップシンク、ジェスチャー、身体の動きをリアルタイム生成する。オフラインのモデリングもキャラクターの訓練工程も必要ない。
中核能力
音声が駆動するのは口の動きだけではない
多くのデジタルヒューマン製品は、いまだに「音声がリップシンクを駆動する」段階にとどまり、動作の種類が限られ、組み合わせの痕跡も丸見えだ。Vidu S1 はリアルタイム動画生成アーキテクチャを採用し、音声の内容を聞き取るだけでなく、意味と感情も理解したうえで、マッチする表情、ジェスチャー、全身の動きをリアルタイムに生成する。
「サムズアップ」「鼻に触って」「ウインクして」と頼めば、いずれも画面の中でリアルタイムに対応する動作をする。音声はここで、キャラクターの行動を制御する信号へと拡張されている。
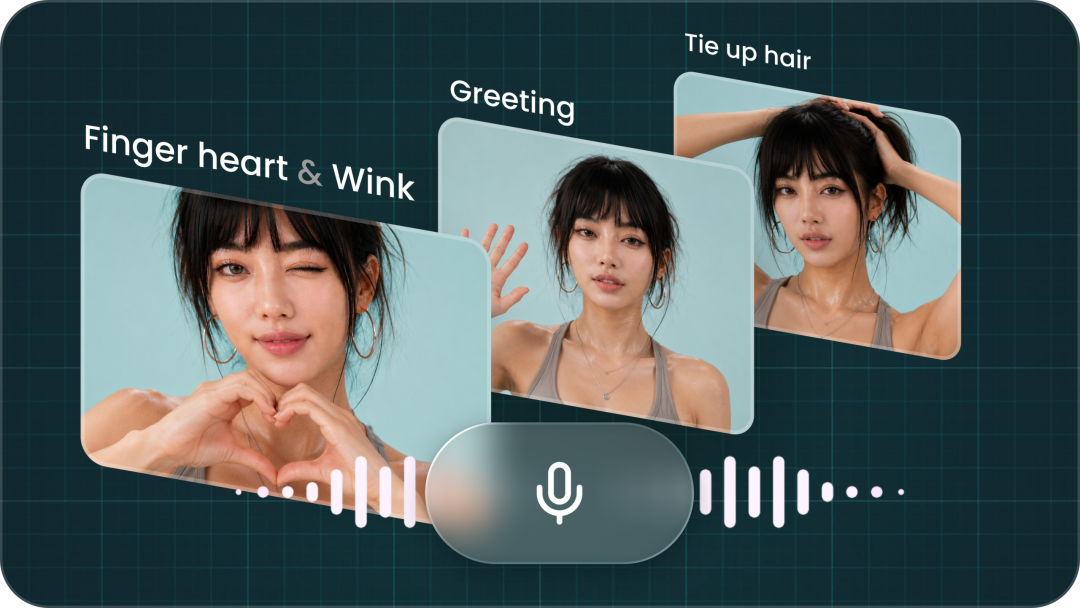
「音声がリップシンクを駆動」から「音声が行動を駆動」へと進み、キャラクターは言葉を理解し、正確に動き、より自然なフィードバックを返せるようになった。
無限長のリアルタイム生成
Vidu S1 は、無限長のリアルタイム動画生成を初めて実現した——数時間連続生成しても画面は安定を保ち、急速にドリフトしたり崩壊したりしない。モデルは長時間の動作の中で、キャラクターのアイデンティティの安定と自然で滑らかな動作を同時に保ち、ユーザーの指示を受け続け、リアルタイムに応答できる。
540P + 25FPS、コンシューマーGPUで動く
リアルタイム対話シーンでは、解像度とフレームレートが体験の滑らかさを直接左右する。Vidu S1 が示すパラメータは次のとおり:
- 解像度:540P(960×540)
- フレームレート:25FPS(最大42FPS対応)
この一連の能力は、コンシューマー向けグラフィックカードでもそのまま動かせる。背後では、生数科技自社開発のTurboDiffusion推論高速化フレームワーク(少ステップ生成、SageAttention低ビットアテンション、SLA/SpargeAttention疎アテンション)と、TurboServe推論配備エンジン(動的リソーススケジューリング)に支えられている。
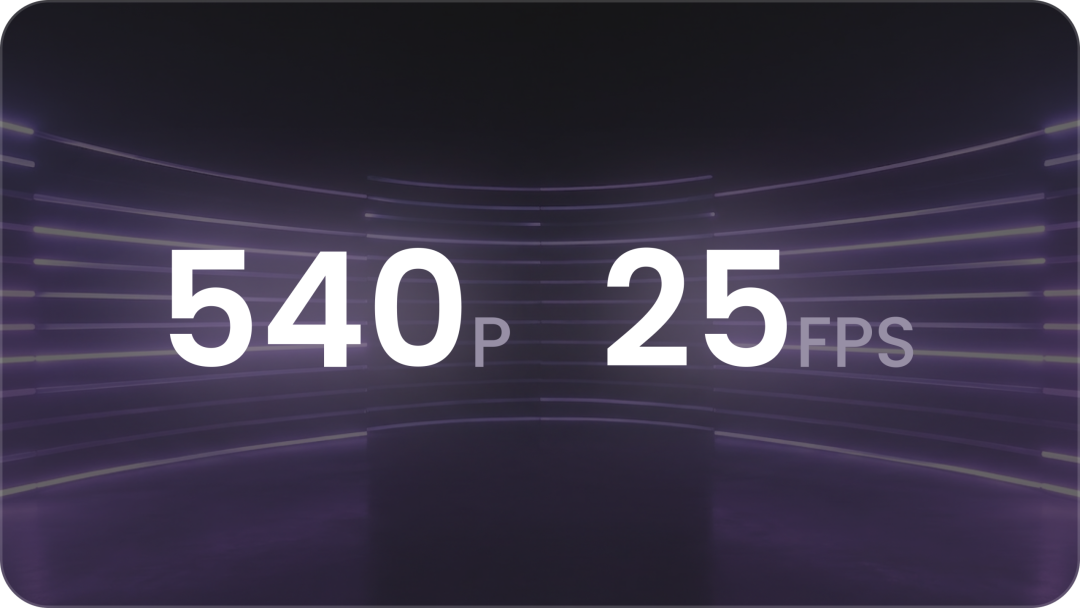
540P + 25FPS(最大42FPS)により、リアルタイム動画生成は、ビデオ通話、配信、リアルタイムコンパニオン、インタラクティブゲーム、さらにはXRシーンに足を踏み入れるための基礎的な敷居を備えた。
カスタムキャラクター:任意の画像 + 任意の音色
ユーザーは画像をアップロードするだけでキャラクターを作れる——実写、アニメ、ペット、ゲームキャラ、ブランドIPのいずれも初期キャラクターにできる。声の面では、システムの音色を選ぶことも、自分の声を録音してカスタムすることもできる。
公式の実測では、『モナ・リザ』の画像を1枚アップロードすると、通話に入ったモナ・リザが音声入力に応じて口を開き、リップシンク、表情、動作のフィードバックを生成した。手を挙げる動作や、怒ったときの表情と口調も比較的自然だ。
使い始めるには
Vidu S1 は完全公開のトライアルで、3つの体験方法がある:
- Web体験(中国国内):vidu.cn/vidu-stream
- APIプラットフォーム:platform.vidu.cn/live/landing
- クライアントアプリ:携帯のアプリストアで「Vidu AI Pro」を検索してダウンロードし、APPに入って「Vidu S1」をタップ
体験ページに入ったら、プリセットキャラクターを選んで通話を始めるか、画像をアップロードして自分のキャラクターを作れる。キャラクターを選んだらマイクから音声指示を出すと、キャラクターは画面の中でリアルタイムに応える。
💡 ヒント:画像をアップロードして基本設定を済ませると、新しいキャラクターはほぼ即座に対話状態に入れる。訓練を待つ必要はない。
技術基盤
Vidu S1 は**自己回帰拡散モデル(AR + Diffusion)**の路線に基づく。モデルは完全なクリップを一度に産出するのではなく、生成済みの過去の画面に基づき、ユーザーの現在の音声や指示などのコンテキストを組み合わせて、次フレームの内容をリアルタイムに予測・生成する。このフレームごとの生成方式は、本質的にリアルタイムに割り込み・書き換えできる性質を備えている。
技術レポートのアドレス:jt-zhang.github.io/files/Vidu_S1.pdf
応用シーン
- コンテンツクリエイター:歴史人物の肖像、1枚のイラスト、ブランドIPが、会話できて演じられるデジタルキャラクターへ素早く変わる
- 企業:APIを通じて、ブランドIP、バーチャルカスタマーサポート、デジタルキャスター、ゲームNPC、教育トレーナーを業務に接続
- 開発者:AI Character、インタラクティブコンテンツ、リアルタイム動画基盤の構築
限界
公式は体験の中で、物理世界に対するモデルの理解はまだ最適化の段階にあると率直に認めている。長時間の生成ではキャラクターのアイデンティティとスタイルがゆっくりドリフトする可能性があり、複雑な動作の物理的整合性(手と物体の接触のリアリティなど)にもまだ改善の余地がある。これらはいずれも、リアルタイム対話動画という分野全体が共に越えるべき壁だ。