
VLA-JEPA:ロボットに「動作が世界をどう変えるか」を学ばせる
中関村学院 × 中科大 × 上交 × 東方理工がVLA-JEPAを提案。VLAモデルと世界モデルを潜在空間で融合し、わずか13軌跡で組立タスクを完了、LIBEROで97.2%を達成、LeCunと謝賽寧氏が転載しました。
VLA-JEPA:ロボットに「動作が世界をどう変えるか」を学ばせる
中関村学院 × 中科大 × 上交 × 東方理工がVLA-JEPAを提案。VLAモデルと世界モデルを潜在空間で融合し、わずか13軌跡で組立タスクを完了、LIBEROで97.2%を達成、LeCunと謝賽寧氏が転載しました。
ロボットデータの収集は高コストで、規模が限られ、タスクのカバー範囲も狭い。一方、インターネット上の人間の動画やラベルなし操作動画は極めて豊富です。膨大な人間動画を使ってVLAモデルに「動作が世界をどう変えるか」を学ばせるにはどうすればよいか。中国科学技術大学、北京中関村学院、上海交通大学、寧波東方理工学院のチームが提案したVLA-JEPAが1つの方向性を示しました。モデルにピクセル空間で「未来フレーム」を追いかけさせるのはやめ、Yann LeCunのJEPA路線を参考に、潜在表現空間で世界状態の変化を学習・予測するのです。
lerobotフレームワークへの初の移植となるVLAと世界モデルの結合ワークとして、VLA-JEPAは公式検証でわずか13軌跡だけで簡単な組立タスクを完了し、LeCunと謝賽寧(Xie Saining)氏がSNSで転載して注目を集めました。
人間の動画とロボットデモを「潜在世界モデル」の学習目標に統一する。
一言で理解する
VLA-JEPAはVLAモデル向けのJEPA式事前学習フレームワークです。現在の観測はVLAバックボーンを通じて潜在アクションtokenになり、未来フレームは目標エンコーダ経由で監督信号のみを提供します。モデルはLatent Spaceで未来状態を予測する必要があります。
この設計が解決するのは、従来のlatent action事前学習の中心的バイアスです。モデルは「アクションが引き起こす状態遷移」ではなく「ピクセルの変化」を学びがちです。とくにインターネット動画では、カメラの移動、背景の変化、無関係な物体の動きが本来の操作信号より目立ちやすく、latent actionが目標画像の圧縮表現に退化してしまいます。
人間動画の段階ではlatent world modelingの整合損失、ロボットデータの段階ではさらにアクション予測損失を追加。
なぜこのアプローチが必要か
理想的には、latent actionが捉えるべきは「動作に関連する状態遷移の意味」——物体が押され、掴まれ、移動された後に環境状態がどう変化したか——であって、画面のどのピクセルが変わったかを単に記録することではありません。VLA-JEPA論文は、既存のlatent-action事前学習に普遍的に存在する4類の問題を指摘しています:
- ピクセルレベルの目標が表現を外見に偏らせる:テクスチャ、照明、背景、視点の変化は大きく予測しやすいのに、本当に制御すべき自由度との関係は弱い
- 実動画は無関係な運動ノイズを増幅する:カメラぶれや背景移動が操作信号より顕著で、latent actionがノイズ運動に支配される
- 情報リークがlatent actionを退化させる:未来観測がaction variableの学習に参加すると、モデルは未来そのものをエンコードするだけでよく、意味的には空になる
- 多段階トレーニングフローが複雑すぎる:表現の事前学習 → latent actionアラインメント → 方策モデル、という流れでは目的関数・データ分布・表現空間を一致させにくい
手法:未来を入力ではなく監督にする
VLA-JEPAはQwen3-VLをVLMバックボーンとして採用し、隣接状態間の遷移を表す学習可能なlatent action tokenを導入します。動画フレームはV-JEPA2エンコーダによって世界状態表現へ写像され、予測器は現在状態とlatent actionから未来のlatent stateを予測し、目標エンコーダが得た未来状態と整合させます。
ロボットの動作アノテーション付きデータでは、さらにflow matchingベースのアクションヘッドを接続し、連続なエンドエフェクタ軌跡を生成します。
役割分担は明快です:
- 人間の動画はダイナミクス知識(「動作が世界をどう変えるか」)の提供を担う
- ロボット軌跡はそのダイナミクス知識を実行可能な動作へ落とし込む役割
トレーニングフローも多段階のlatent-actionパイプラインより直接的です。まずJEPAで事前学習し、その後アクションヘッドをファインチューニングします。
実験結果
論文はLIBERO、LIBERO-Plus、SimplerEnv、実機Frankaのテーブルトップ操作タスクで評価しています。事前学習にはSomething-Something-v2の約22万本の人間動画 + DROIDの約7.6万軌跡のロボットデモを使用。LIBEROのファインチューニングには約2000軌跡のシミュレーション専門家デモだけを使い、実世界実験では3類のタスクに合計100軌跡のデモを使用しました。
LIBERO / LIBERO-Plus
- LIBERO:平均成功率97.2%で、ObjectとLIBERO-10の2つのsuiteで最高スコアを取得。注目すべきは、OpenVLA-OFTやpi0.5などの強力なベースラインが大量のロボットデータに依存するのに対し、VLA-JEPAはより少ない学習データで同等以上の平均性能を達成している点です
- LIBERO-Plus(多種攪乱OOD):7つの攪乱次元のうち5つで最良の結果を取得し、平均成功率**78.1%**はOpenVLA-OFT(69.6%)とpi0-Fast(61.6)を明確に上回ります
latent actionが学んだのは単一の視覚テンプレートではなく、世界状態の変化により近い表現であること——これがロバスト性の源泉です。
SimplerEnv:人間動画は万能薬ではない
SimplerEnvの結果は現実への注意を促します。いくつかの視覚マッチングタスクでは、人間動画を除去したほうがむしろスコアが高いケースがありました。これはVLA-JEPAの主な価値が、新しい動作スキルを無から生成することではなく、高品質なロボットデータを土台にロバスト性と安定性を増強することであることを示しています。
実機ロボット:失敗後の二次掴み
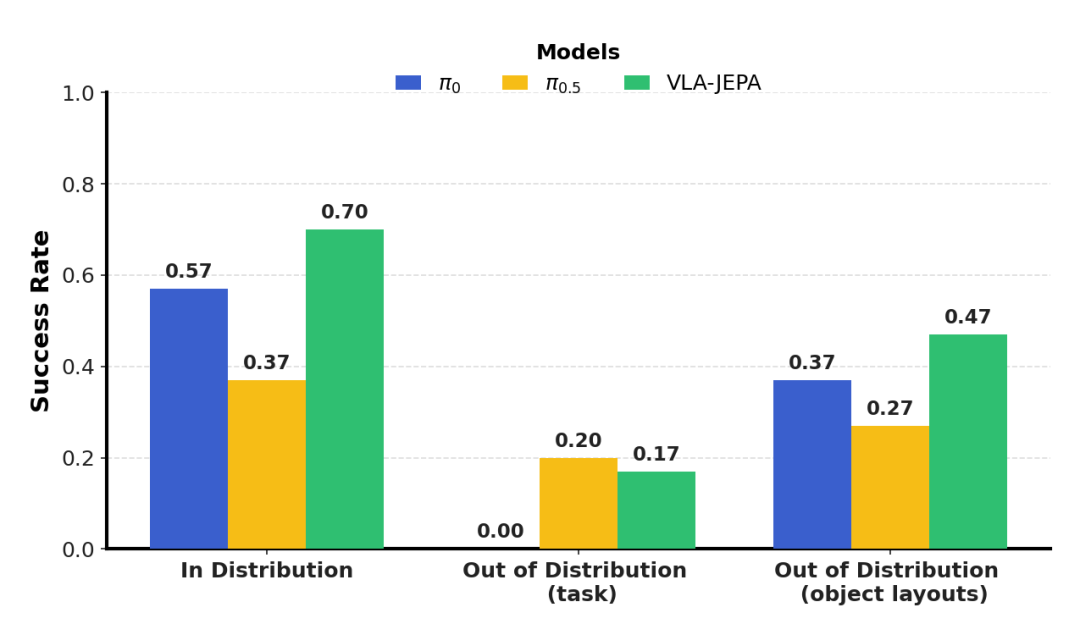
実世界実験ではFR3アーム + Robotiq 2F-85グリッパー + D435カメラ3台を使用しました。pi0やpi0.5と比較して、VLA-JEPAには興味深い現象が現れます。最初の掴みに失敗した後、モデルはグリッパーを開き直して二次掴みを試みるのです。比較モデルではこの挙動は安定して観察されませんでした。
著者らはこれを人間動画に含まれる「再掴みの知識」に帰しています。人間の操作では、失敗後に調整して掴み直す場面がより多く含まれるのに対し、ロボットデモデータは通常こうしたリカバリー挙動を意図的にカバーしません。ここがVLA-JEPA路線で最も報道価値のある点です。人間動画がロボット制御を直接教えるとは限らないが、「どうリカバリーするか」という常識を補えるかもしれないのです。
使い方
オープンソースリソースは揃っています:
- arXiv:arxiv.org/abs/2602.10098
- コード:github.com/ginwind/VLA-JEPA
- プロジェクトページ:ginwind.github.io/VLA-JEPA/
- Hugging Face:huggingface.co/ginwind/VLA-JEPA
応用シーン
- ロボット方策研究チーム:より少ないロボットデータで強力なベースラインに迫り、または超える性能を得られる。データ収集コストが高いロングテールタスクに特に適する
- VLA + 世界モデルの方向:lerobotフレームワークへの初の移植ワークであり、VLA-JEPA路線の再現出発点にできる
- 産業用アーム / テーブルトップ操作:失敗後の二次掴み挙動が実生産環境で失敗率を直接下げる
- 人間動画活用研究:消融実験が人間動画の「安定性は補うが新スキルは補わない」という位置づけを明確に示しており、後続研究のベースラインになる
💡 ヒント:VLA-JEPAは人間動画が高品質なロボットデータを代替できることを証明したわけではありません。むしろ明確にしたのは両者の分担です——ロボットデータは実行可能なアクションのグラウンディングを提供し、人間動画はより広範な世界ダイナミクスの経験を提供する。人間動画を「動作ラベルの代替品」と考えて失望するか、「世界ダイナミクスの事前知識」と考えて本当に活用できるかの分かれ目です。
プロジェクトURL:github.com/ginwind/VLA-JEPA