UniPat AI开源的SWE-Vision是极简视觉智能体框架,仅500行代码让模型自主编写Python代码验证视觉判断,在多个视觉基准测试达到SOTA水平
UniPat AI开源的SWE-Vision是极简视觉智能体框架,仅500行代码让模型自主编写Python代码验证视觉判断,在多个视觉基准测试达到SOTA水平
蚂蚁集团ACL 2026新作FuseSearch-4B,通过自适应并行搜索策略,在代码定位任务上匹配Claude Haiku 4.5,速度快93.6%,Token省68.9%
SWE-Vision是UniPat AI团队开源的视觉智能体框架,核心创新在于:让AI模型自己写代码来验证视觉判断。
传统视觉模型(如GPT-4V、Gemini)直接输出答案,而SWE-Vision让模型:
这种"自我验证"机制大幅提升了准确率,在BabyVision等五大视觉基准测试中达到SOTA。
# 伪代码示例
def swe_vision_process(image, question):
    # Step 1: 模型观察图片并生成假设
    hypothesis = model.analyze(image, question)

    # Step 2: 模型编写验证代码
    verification_code = model.generate_code(hypothesis)

    # Step 3: 执行代码获取结果
    result = execute(verification_code, image)

    # Step 4: 根据结果调整答案
    final_answer = model.refine(hypothesis, result)

    return final_answer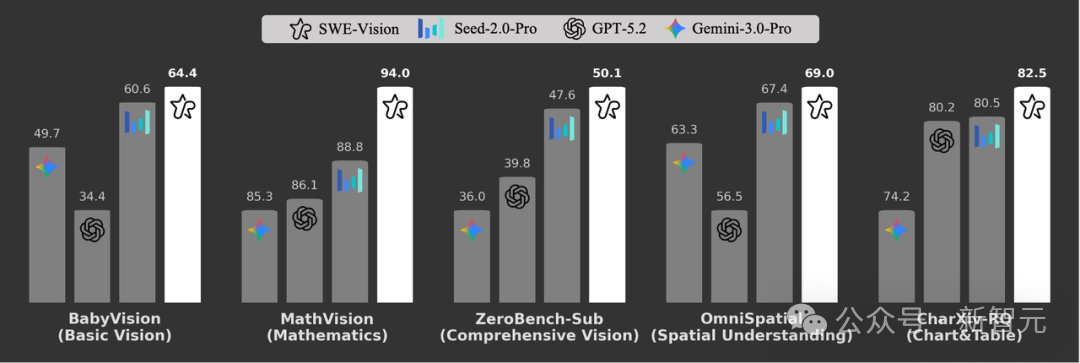
SWE-Vision的设计哲学是"极简主义":
问题: 图片中有多少个红色圆圈?
传统模型: 直接输出"5个"(可能数错)
SWE-Vision:
# 模型生成的验证代码
import cv2
import numpy as np

img = cv2.imread('image.jpg')
hsv = cv2.cvtColor(img, cv2.COLOR_BGR2HSV)

# 定义红色范围
lower_red
执行结果:检测到 7 个红色圆圈,模型据此修正答案。
问题: 猫在沙发的左边还是右边?
SWE-Vision生成的代码:
from PIL import Image
import torch

# 使用目标检测模型定位物体
cat_bbox = detect_object(img, "cat")
sofa_bbox = detect_object(img, "sofa")

# 比较中心点x坐标
cat_center_x
在五大视觉基准测试中的表现:
| 基准测试 | GPT-4V | Gemini Pro | SWE-Vision |
|---|---|---|---|
| BabyVision | 72.3% | 75.1% | 82.4% |
| MMMU | 56.8% | 59.4% | 63.2% |
| MathVista | 49.9% | 52.3% | 58.7% |
# 克隆仓库
git clone https://github.com/unipat-ai/swe-vision

# 安装依赖
pip install -r requirements.txt

# 配置模型API
export OPENAI_API_KEY="your-key"

# 运行示例
python examples/count_objects.py --image test.jpgfrom swe_vision import VisionAgent
agent = VisionAgent(model="gpt-4")
result = agent.solve(
image_path="image.jpg",
question=
适合谁?
不适合谁?
核心优势: SWE-Vision证明了"让AI写代码验证自己"是提升准确率的有效路径。500行的极简设计也让它易于理解和定制。
明显限制: