
DeNovoSWE:初の長期Doc2Repo訓練セット、Code Agentにリポジトリ構築を学ばせる
中国人民大学高瓴学院がDeNovoSWEデータセットを公開。4818件の実タスクインスタンスでCode Agentにドキュメントからの完全なリポジトリ生成を学ばせ、Qwen3-30BはBeyondSWE-Doc2Repoで5.8%から47.2%へ向上。
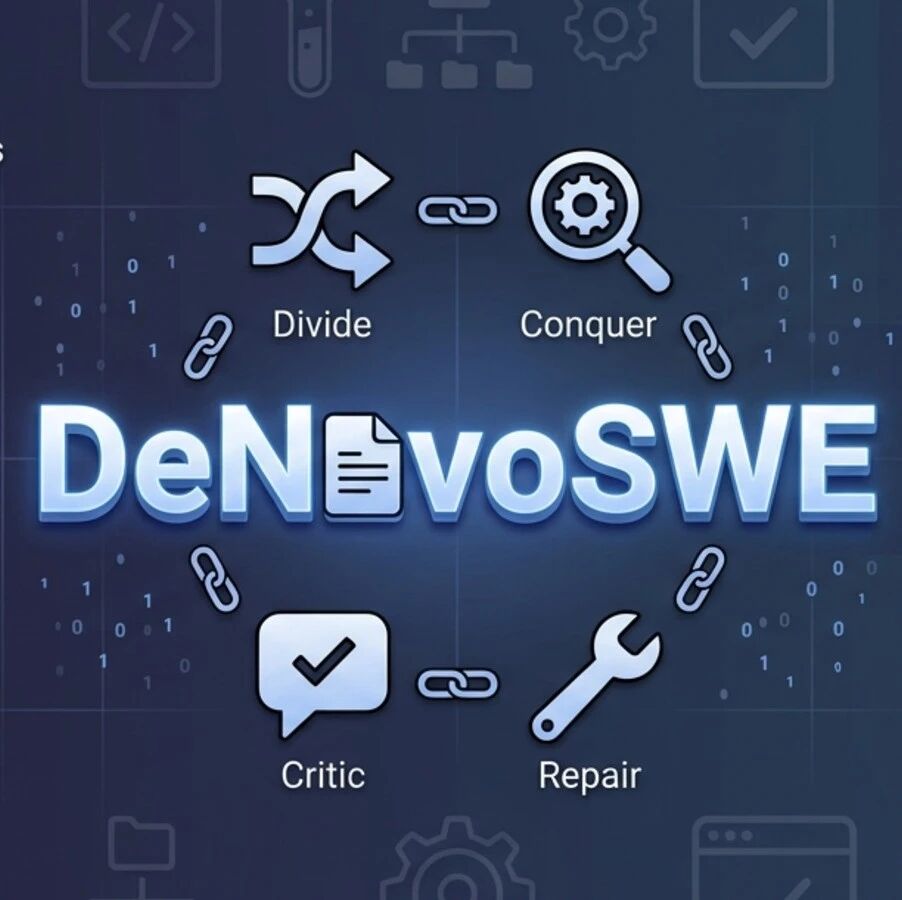
DeNovoSWE:初の長期Doc2Repo訓練セット、Code Agentにリポジトリ構築を学ばせる
中国人民大学高瓴学院がDeNovoSWEデータセットを公開。4818件の実タスクインスタンスでCode Agentにドキュメントからの完全なリポジトリ生成を学ばせ、Qwen3-30BはBeyondSWE-Doc2Repoで5.8%から47.2%へ向上。
DeNovoSWEは中国人民大学高瓴人工知能学院がリリースした長距離ソフトウェアエンジニアリングデータセットで、Code Agentに1篇のドキュメントから出発して、完全で実行可能、検証可能なソフトウェアリポジトリを生成させるための専用訓練データだ。4818件の実タスクインスタンスを含み、オープンソースで訓練も評価もできる。
これは2026年のオープンソース資源の中で、Code Agent開発者が注目すべき高品質データのひとつだ。もしあなたがコードエージェントを訓練またはファインチューニングしていて、その能力を「バグ修正」から「リポジトリ構築」へ飛躍させたいなら、DeNovoSWEは再利用可能な経路を提供する。
何を解決するのか
この1年、Code AgentはSWE-benchのような実ソフトウェアエンジニアリングタスクで急速に進歩した。しかしモデルが「1件のissueを直す、数行のバグを補う」ことに長けてくるにつれ、重要な問題が浮かび上がった:エージェントは本当に長距離のソフトウェアエンジニアリング能力を備えているのか?
現実世界のソフトウェア開発は、1つの関数を直したり条件分岐を補ったりすることではないことが多い。要件を理解する→アーキテクチャを設計する→ファイルを作成する→APIを設計する→依存を処理する→モジュールを貫通する→リポジトリ全体をテストで通す、という流れだ。言い換えれば、難しいのはlong-horizon repository-level generationである。フロンティアモデルのBeyondSWE-Doc2RepoとNL2RepoBenchでの成績を見ると、効果は芳しくない。
中核メカニズム:Divide & Conquer + Critic & Repair
DeNovoSWEは人手でドキュメントを書くのではなく、sandboxed multi-agent workflowによって高品質インスタンスを自動構築する。全体は2ステップに要約できる。
Divide 段階:システムが対象リポジトリを分析し、複数のrepository capabilities(認証と接続、データ読み書き、バッチ処理、エクスポートフローなど)へ分解する。同時に元のユニットテストを実行して実行traceを収集し、テストから直接呼ばれるインターフェース(詳細に記録必須)、観察可能な動作に影響する中核の間接コンポーネント(カバー必要)、非中核の内部実装(エージェントの自由裁量に委ねる)を区別する。
Conquer 段階:Draft-Critic-Repairメカニズムで能力ごとにドキュメントを生成する——Draft agentが初稿を書き、Critic agentが重要なAPIや動作契約の見落しを検査し、Repair agentがフィードバックに基づいて修復する。各能力の章が十分に明確で完全、evaluationと整合するまで反復する。
💡 ヒント:DeNovoSWEの中核思想は、ドキュメントを読めて実装でき、さらに検証もできるようにすることだ——evaluationが依存する重要な動作(import path、公開API、入出力、デフォルト引数、例外動作、設定項目、パターン文字列、戻りフィールドなど)を記述しつつ、実装コードのコピーにはしない。
漏洩防止と難度フィルタリング
エージェントがドキュメントに本当に依存し、「記憶」でコードを再現しないように、DeNovoSWEはタスク環境で厳格なクリーンアップを行った:元のソースコードとテストは除去され、git履歴はリセットされ、キャッシュ、site-packagesの残留、pip wheel、一時コンパイル産物などの潜在的な漏洩経路はすべて取り除かれた。
さらにdifficulty-aware trajectory filteringも提案している:易しいタスクにはより高い合格率を要求し、難しいタスクは満点に達しないという理由で全部捨てることはしない。長距離タスクではとくに重要だ——複雑なリポジトリほどすべてのテストを一発で完全に通すのは難しいが、その中の困難なリポジトリ、低得点、部分的に成功した軌跡には、貴重な長距離計画と実装能力が依然として含まれている。
実験結果
DeNovoSWEは最終的に4818件の高品質なdocument-to-repositoryタスクインスタンスを構築した。実験では、モデルの長距離リポジトリ生成能力に顕著な向上をもたらした:
| モデル / データ | BeyondSWE-Doc2Repo | NL2RepoBench |
|---|---|---|
| Qwen3-30B-A3B-Instruct(オリジナル) | 5.8% | 4.3% |
| + Scale-SWE-Agent(issue-levelデータ) | 29.2% | 18.3% |
| + DeNovoSWE | 47.2% | 23.0% |
より強いQwen3.5-35B-A3Bのbackboneでも、DeNovoSWEは同様に安定した利益をもたらした:BeyondSWE-Doc2Repoは43.8%から50.0%へ、NL2RepoBenchは23.5%から27.1%へ向上した。これは利益が特定のモデルへの偶然の適合ではなく、高品質な長距離データそのものに由来することを示す。
💡 ヒント:「バグ修正」向けのデータは、「完全なリポジトリ生成」向けの長距離データを完全には置き換えられない。エージェントに本当の意味でrepository-level engineeringを学ばせたいなら、長距離タスクに特化して訓練環境を構築する必要がある。
資源リンク
- 論文:https://arxiv.org/pdf/2606.10728
- コードリポジトリ:https://github.com/AweAI-Team/DeNovoSWE
- データセット:https://huggingface.co/collections/AweAI-Team/denovoswe
適用対象
- Code Agentの訓練またはファインチューニングを行っている研究者とエンジニア
- 長距離タスク(long-horizon)benchmarkに関心のあるチーム
- コードエージェントを「リポジトリ保守者」から「アーキテクト」へ格上げしたい実務者
関連記事
StepFun Step Edge 端末向けフルラインナップ:0.1秒のローカル Agent 呼び出し
StepFun が Step Edge 端末向けモデルファミリーを発表。ベース/Audio/GUI/Gen の4種を含み、スマホや車載シーンを主眼に、ローカル toolcall は最速 0.1秒、機密データは端末外に出ません。
Google Gemma 4 オープンソース化:4段階のモデル、256K コンテキスト、ローカルで動く
Google が Gemma 4 オープンソースモデルファミリー(E2B/E4B/26B MoE/31B Dense)を発表。Apache 2.0 ライセンス、256K コンテキスト、ネイティブマルチモーダルで、ローカル導入の経路も紹介します。
Grok 4.5:xAI と Cursor が共同訓練したコーディングモデル、$2 起点
xAI が Grok 4.5 を発表。Cursor との共同訓練により実際のエンジニアリングタスクに照準を定め、API 価格は 100万 token あたり $2/$6。Cursor の全プランで利用可能です。
Meta Muse Spark 1.1:100万トークン・コンテキストのAgentモデル、APIパブリックベータ
MetaがMuse Spark 1.1を発表。agentタスクに主眼を置いたマルチモーダル推論モデルで100万トークンのコンテキストを搭載し、あわせてMeta Model APIの公開プレビューも始まった。
GPT-5.6リリース:3段階の新モデル + ChatGPT Work、Codexはデスクトップ版へ統合
OpenAIがGPT-5.6シリーズ(Sol/Terra/Luna)とChatGPT Work agentをリリース。CodexはChatGPTデスクトップアプリに統合され、完全な料金体系と利用チャネルも併せて紹介。
ChatGPT音声の大規模アップグレード:全二重のGPT-Liveモード登場
OpenAIが全二重音声モデルGPT-Liveをリリース。ChatGPTがついに聞きながら話し、自然に相槌を打ち、沈黙のタイミングを知るようになった。従来のAdvanced Voice Modeを置き換える。