
DeNovoSWE:初のロングホライズン Doc2Repo 訓練セット、Code Agent にリポジトリ構築を学ばせる
中国人民大学が4818件の実タスクインスタンスを含むオープンソース訓練セットを発表。Agentのリポジトリレベルコード生成専用で、Qwen3-30Bの通過率を5.8%から47.2%へ引き上げ
DeNovoSWE:初のロングホライズン Doc2Repo 訓練セット、Code Agent にリポジトリ構築を学ばせる
中国人民大学が4818件の実タスクインスタンスを含むオープンソース訓練セットを発表。Agentのリポジトリレベルコード生成専用で、Qwen3-30Bの通過率を5.8%から47.2%へ引き上げ
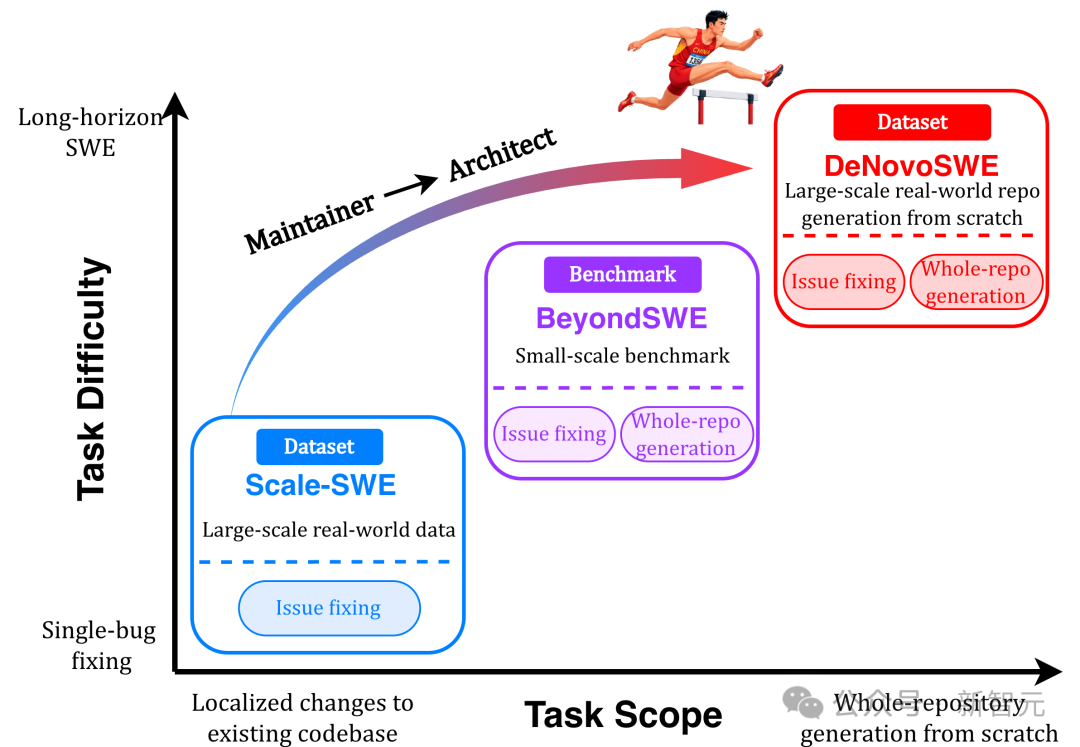
この1年で、SWE-benchのようなベンチマークはCode Agentに「バグ直し」や「条件分岐の追加」を学習させてきました。しかし現実のソフトウェア開発は、要件の理解、アーキテクチャの設計、ファイルの作成、APIの設計、依存関係の処理、モジュール間の連携を経て、最終的にリポジトリ全体をテストで通すところまでが仕事です。こうしたlong-horizonなリポジトリレベル生成タスクでは、最先端モデルもBeyondSWE-Doc2RepoやNL2RepoBenchで思うような成績を出せていません。中国人民大学高瓴人工智能学院がこのほど発表したDeNovoSWEデータセットは、まさにこのギャップを狙ったものです——長期Doc2Repoタスク向けとして初のオープンソース高品質訓練セットであり、4818件の実タスクインスタンスを含み、Qwen3-30B-A3B-InstructのBeyondSWE-Doc2Repo通過率を5.8%から47.2%へ引き上げました。本記事では設計思想・手法・使い方を分解し、自社のCode Agentを訓練するチームのリソース参考を提供します。
DeNovoSWE とは何か
一言で定義すると:Code Agentにドキュメントから完全に動くリポジトリを生成させる、オープンソースの訓練セットです。
- 発表元:中国人民大学高瓴人工智能学院
- タスク種別:document-to-repository generation(長期SWEタスク)
- 規模:4818件の高品質な実タスクインスタンス
- 特徴:実行可能、評価可能、訓練可能
論文は arxiv.org/abs/2606.10728、リポジトリは github.com/AweAI-Team/DeNovoSWE。
中核の問題:「バグ修正」から「リポジトリ構築」へ
DeNovoSWEはタスクの難易度を根本的に変える方向へ押し上げます。issue-level fixingではなく、whole-repository generationです。
従来のSWEタスクでは、Agentは既存のリポジトリを前にし、バグを特定し、コードの一部を修正し、テストを通すだけでよかった。DeNovoSWEでは、Agentが直面するのはクリーンアップ後の環境です。
- 元のソースコードとテストが除去されている
- git履歴がリセットされている
- キャッシュ、site-packagesの残骸、pip wheel、一時的なビルド成果物などの潜在的なリーク経路がすべて除去されている
つまりAgentは、ドキュメントだけを頼りにリポジトリ全体を再構築しなければなりません。プロジェクト構造の設計、モジュールファイルの作成、公開インターフェースの定義、ファイル間連携の実装、依存関係と設定の処理を行い、複数回の編集とテストフィードバックの中でエラーを修正し続けます。APIシグネチャ、返却フィールド、例外型、デフォルト動作のわずかなズレがテスト失敗につながり、さらにエラーは長期の過程で蓄積します——序盤で設計を誤ったモジュールが、その後の複数のファイルと呼び出し連鎖に悪影響を与えるのです。
高品質なタスクドキュメントの2つの基準
DeNovoSWEの核心となる考え方は、ドキュメントを読みやすく・実装可能にしつつ、検証可能でもあるようにすることです。document-to-repository generationにおいて、ドキュメントは単なるREADMEではなく、Agentがリポジトリ全体を再構築する唯一のタスク入口です。
基準1:well-organized
リポジトリレベルのタスクは本質的に複雑で、複数のモジュール、インターフェース、設定、データ構造、相互作用フローを含みます。ドキュメントが関数の説明をただ積み上げただけだと、Agentは断片的な情報の中で迷子になりがちです。高品質なドキュメントは次であるべきです。
- まずリポジトリ全体の明確な概観を示す
- 能力またはワークフローごとに章を分ける
- 各部分が明確な機能境界に対応する
基準2:信頼できるevaluationから出発する
ドキュメントは少なすぎても(タスクがunder-definedな問題になり、モデルが当てずっぽうでしかevaluationを通せない)、多すぎても(実装の詳細を直接リークし、タスクの挑戦性を失う)いけません。本当に高品質なドキュメントは、evaluationが依存する重要な振る舞いを記述すべきです。
- import path
- 公開API
- 入出力
- デフォルト引数
- 例外の振る舞い
- 設定項目
- パターン文字列
- 返却フィールド
つまり、ドキュメントはAgentがテスト可能な振る舞いを再現できる程度に十分でありながら、実装コードのコピーにはならないようにする必要があります。
DeNovoSWEはDivide & ConquerとCritic & Repairの機構で高品質データセットを構築します。
DeNovoSWEの手法:Divide & Conquer
DeNovoSWEは人手でドキュメントを書くのではなく、sandboxed multi-agent workflowで高品質インスタンスを自動構築します。手法全体は2ステップです。
Divide フェーズ
システムが対象リポジトリを分析し、複数のrepository capabilitiesへ分解します。各capabilityはリポジトリ内の1つの中核能力またはワークフロー(認証と接続、データ読み書き、バッチ処理、エクスポートフローなど)に対応します。同時に次を行います。
- 元のユニットテストを実行して実行トレースを収集
- どの関数・クラス・インターフェースが実際にevaluationに影響するかを識別
- 3種類のコンポーネントに区別する:
- direct components:テストから直接呼ばれるインターフェース。詳細に記録必須
- core indirect components:観察可能な振る舞いに影響する中核の間接コンポーネント。カバーが必要
- non-core indirect components:中核でない内部実装。Agentの自由裁量に委ねる
Conquer フェーズ
Draft-Critic-Repair機構で能力ごとにドキュメントを生成します。
- Draft agent:初稿を書く
- Critic agent:ドキュメントが重要なAPI、振る舞いの契約、構造情報を漏らしていないか検査する
- Repair agent:フィードバックに基づいてドキュメントを修復する
- 反復:各能力の章が十分に明確・完全でevaluationと整合するまで続ける
最終的に、異なる能力のドキュメントは1つの完全なタスクドキュメントへマージされ、Agentがゼロからリポジトリを生成する唯一の依拠情報となります。
Draft-Critic-Repairのループがドキュメントとevaluationの厳密な整合を保証し、リークと欠落を防ぎます。
難度を考慮したフィルタリング
リポジトリごとの難易度差に対処するため、DeNovoSWEはdifficulty-aware trajectory filteringを提案しています。
- 易しいタスク:より高い通過率を要求
- 難しいタスク:満点に達しないという理由で全部捨ててはならない
構造複雑度とLLMによる難易度判定に基づき、難易度帯ごとに異なるフィルタ閾値を設定します。これは長期タスクで特に重要です——複雑なリポジトリほどすべてのテストを一発で通すのは難しくなりますが、その中の難しいリポジトリ、低得点、部分成功の軌道には、貴重な長期計画と実装能力が依然として含まれています。
実験結果:長期データがもたらす質的変化
DeNovoSWEは最終的に4818件の高品質なdocument-to-repositoryタスクインスタンスを構築し、実験結果は「長期データ」の代替不可能性を裏付けました。
Qwen3-30B-A3B-Instruct での向上
| データセット | BeyondSWE-Doc2Repo | NL2RepoBench |
|---|---|---|
| 元のモデル | 5.8% | 4.3% |
| Scale-SWE-Agent(通常のSWEデータで訓練) | 29.2% | 18.3% |
| DeNovoSWEで訓練 | 47.2% | 23.0% |
通常のissueレベルSWEデータにも確かに転移効果はありますが、DeNovoSWEはその効果をさらに大きく引き上げます。つまり、「バグ修正」向けのデータは「完全なリポジトリ生成」向けの長期データを完全には代替できないということです。
実験は、DeNovoSWEが長期リポジトリ生成能力に顕著な向上をもたらすことを証明しています。
より強いbackboneでも安定した利益
Qwen3.5-35B-A3Bでも、DeNovoSWEは同様に安定した利益をもたらします。
- BeyondSWE-Doc2Repo:43.8% → 50.0%
- NL2RepoBench:23.5% → 27.1%
この利益が特定のモデルへの偶然の適合ではなく、高品質な長期データそのものに由来することをさらに裏付けています。
使い方
リソースリンク
- 論文:
https://arxiv.org/pdf/2606.10728 - コードリポジトリ:
https://github.com/AweAI-Team/DeNovoSWE - データセット(HuggingFace):
https://huggingface.co/collections/AweAI-Team/denovoswe
推奨される使い方
- Code Agentの訓練:長期SWEデータとして既存の訓練パイプラインに補充し、Scale-SWEなどのissueレベルデータと補完させる
- モデルの評価:BeyondSWE-Doc2RepoとNL2RepoBenchで自社モデルのリポジトリレベル生成能力を評価
- 長期タスクの研究:difficulty-aware trajectory filteringの考え方は他の長期Agentタスクへ転移可能
応用シーン
- 大規模モデルチーム:長期ソフトウェアエンジニアリング能力を持つ次世代Code Agentの訓練
- Agentフレームワーク開発者:DeNovoSWEでフレームワークのリポジトリレベルタスクでの性能を評価
- 学術研究:長期タスク、検証可能タスク、anti-leakageなデータ構築の手法参考
💡 ヒント:もしあなたのCode AgentがSWE-benchでは良い成績を出すのに「ゼロからリポジトリを構築」になると手詰まりになるなら、DeNovoSWEは現時点で最も直接使える訓練データです。まずdifficulty-awareフィルタ済みサブセットで小規模なSFT検証を行い、規模拡大するかを判断するのをおすすめします。
関連記事
Codexの3つのコンピュータ操作モード使いこなしガイド
CodexのComputer Use、Chrome拡張、アプリ内ブラウザという3つの操作モードにはそれぞれ適したシーンがある。本記事では権限体系を分解し、ベストプラクティスを示す。
Codexオープンソースモード:設定1行でローカルモデルに接続
OpenAI CodexにOSSモードが追加され、model_providers設定でOllamaやLM Studioなどのローカルモデルサービスに接続可能になった。モデルを切り替えてコストを削減できる。
Alibaba HappyHorse 1.1:動画生成が5つの次元でアップグレード
Alibabaが動画生成モデルHappyHorse 1.1をリリース。動きの表現力や主体の一貫性など5つの次元が向上し、1080Pの価格は25%引き下げ。Bailianプラットフォームで利用可能になった。
MaineCoon:史上最速のストリーミング音声・動画ソーシャルモデル
Catnip チームが 22B パラメータのストリーミング音声・動画モデル MaineCoon を発表。単一枚の H100 で 47.5 FPS を達成し、コストは Veo 3 のわずか 1/2000、30 分超の音声・映像同時出力に対応します。
Seko の無限キャンバス:ひとつのアイデアから武侠大作を生成
Seko は Seedance 2.0 全能モードを搭載し、Agent ワークフローで脚本・キャラクター・絵コンテを自動生成。720P のコストは 50% ダウンで、10 分で作品が完成します。
Claude Science:研究界の Claude Code、無料のオープンソース代替もあわせて紹介
Anthropic が研究向け AI ワークベンチ Claude Science を発表。60 以上のスキルを内蔵し、再現可能です。あわせて DeepSeek/GLM 対応のオープンソース代替 OpenScience も紹介します。