
GPT Image 2:OpenAI初の「考える」画像モデル
GPT Image 2は登場早々Arenaのテキストから画像生成ランキングで首位を獲得し、2位に241点差をつけました。ネイティブな思考能力を備え、文字レンダリングの正確率は99%、APIでの画像生成は1枚わずか$0.21です。
GPT Image 2:OpenAI初の「考える」画像モデル
GPT Image 2は登場早々Arenaのテキストから画像生成ランキングで首位を獲得し、2位に241点差をつけました。ネイティブな思考能力を備え、文字レンダリングの正確率は99%、APIでの画像生成は1枚わずか$0.21です。
GPT Image 2は登場から12時間で1512点を獲得し、Arenaのテキストから画像生成ランキングで首位に立ちました。2位のNano Banana 2に241点差——これはImage Arena史上最大の点差です。これはOpenAIによる、Googleの半年に及ぶ抑え込みへの反撃であるだけでなく、もっと重要なのは、画像生成を「レンダリング時代」から「推論時代」へと前進させたことです。
GPT Image 2とは
GPT Image 2はOpenAIがゼロから再構築した画像生成モデルで、公式には「画像版GPT」と呼ばれています。これまでのすべての画像モデルとの最大の違いは、ネイティブな思考能力を持つことです。描く前に計画を立て、描き終えたら自分でチェックし、必要なときにはネットで参考資料を検索することまでできます。
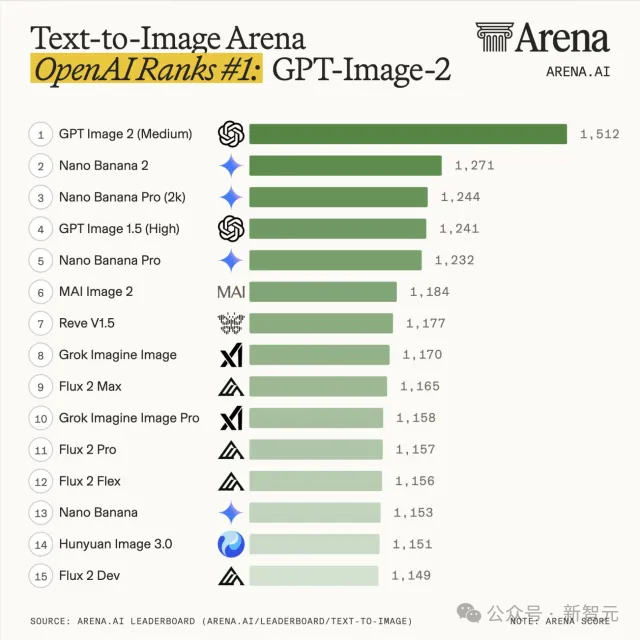
GPT Image 2はArenaの3つの部門別ランキングすべてで首位を獲得。公式は「a clean sweep」と表現しています
主要能力
文字レンダリングの正確率99%
文字レンダリングはこれまでAI画像生成の難題でした。GPT Image 2は文字レンダリングの正確率を99%まで押し上げました(前世代のNano Banana Proは94%)。文字レンダリング単項目では前世代から316点上昇しています。
1つのPromptから複数のスタイルを生成
これまでのAI画像生成の痛点は、出力が単一なことでした。GPT Image 2は1つのプロンプトから、構図、配色、情報密度の異なる複数の画像を生成できます。バリエーションの制御性が大幅に向上しました。
同じプロンプトで生成した線形代数の解説図。まったく異なる4つの構図とスタイル
複数画像編集能力
生成だけでなく、GPT Image 2は単一画像編集と複数画像編集の部門別ランキングでも同じく首位です。元画像をベースに正確な修正を直接行え、元画像のディテールを保ったまま編集を完了できます。
Thinkingモード
Thinkingモードを有効にすると、モデルはまず推論プランを生成してから描き始めます。このモードは複雑なシーンに特に適しています。たとえば漫画ページの生成では、キャラクターの一貫性とコマごとのストーリーの連続性を保てます。
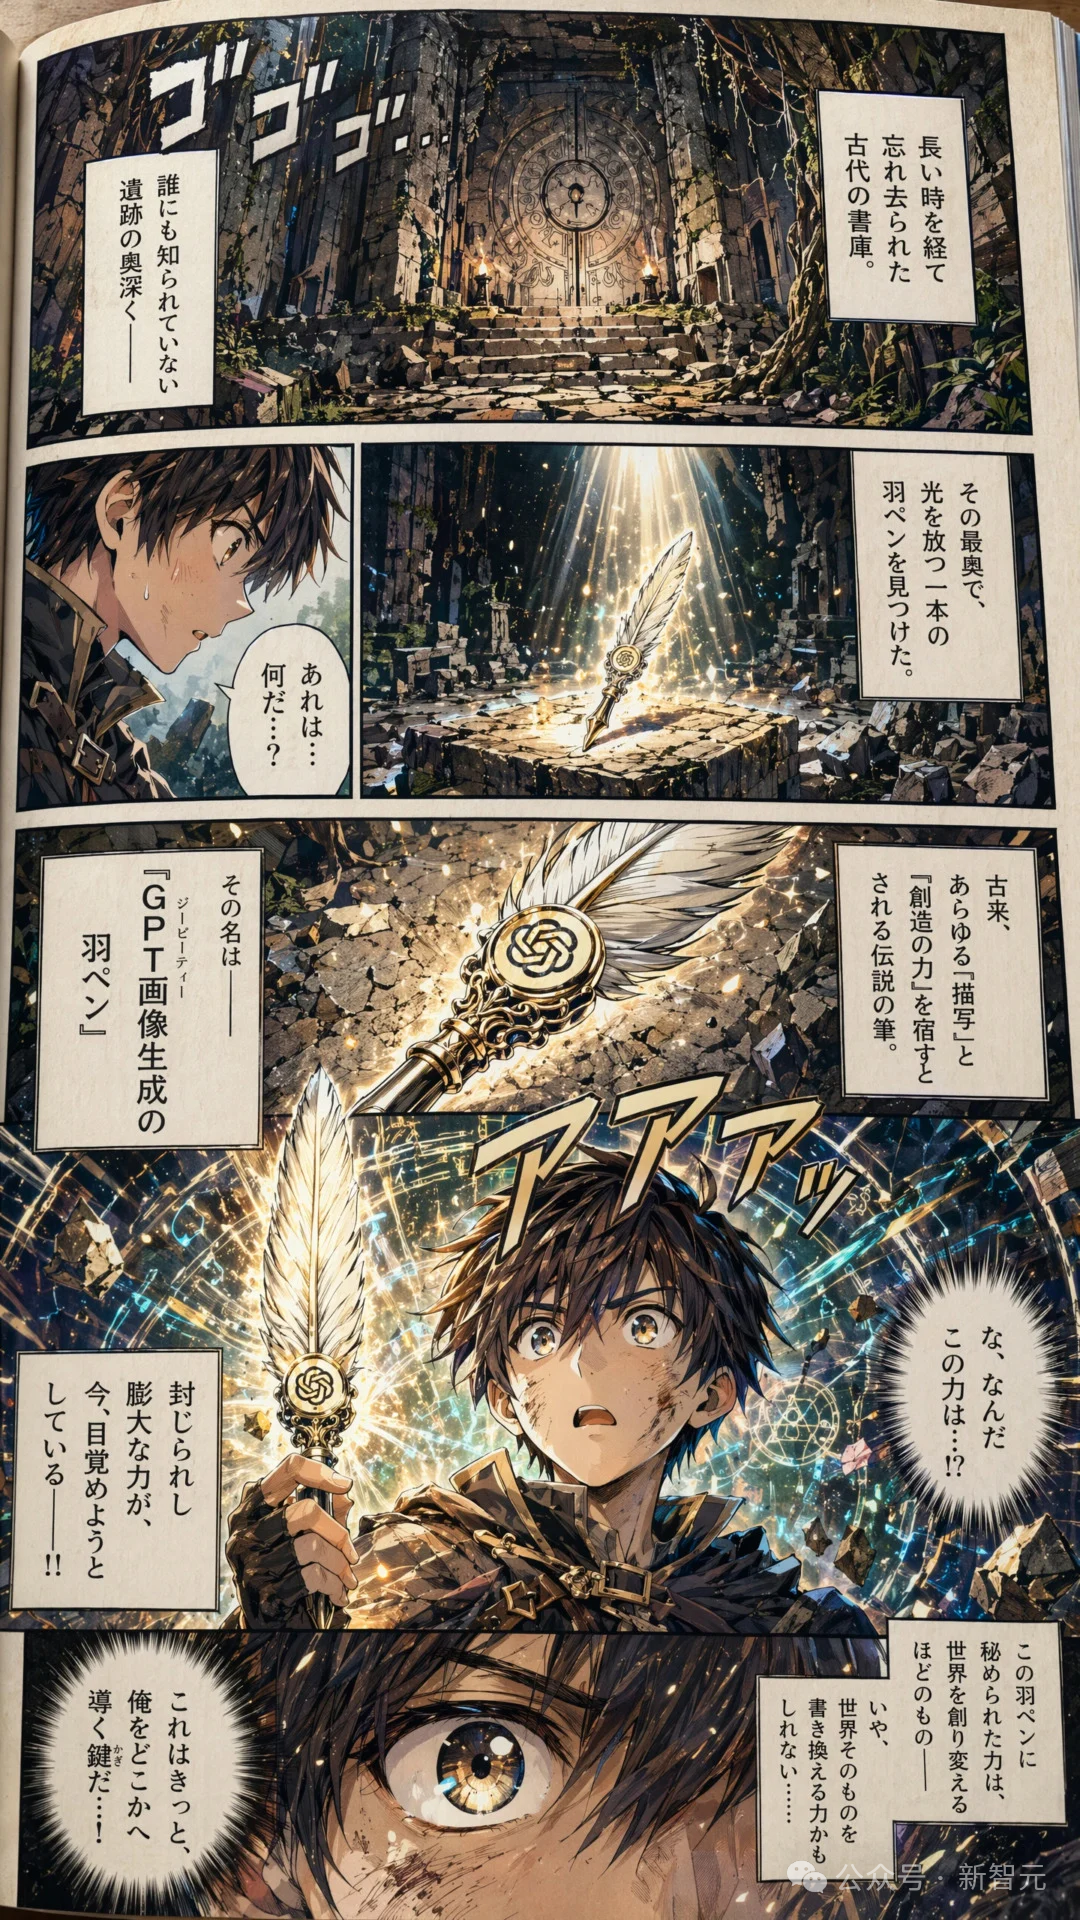
Thinkingモードで生成した漫画ページ。キャラクターの一貫性とコマごとのストーリーの連続性
使い方
ChatGPTで使う
ChatGPT Plusユーザー($20/月)はそのまま利用でき、画像生成はすでにプランに含まれています。
API呼び出し
from openai import OpenAI

client = OpenAI()

response = client.images.generate(
    model="gpt-image-2",
    prompt="一张写实风格的抓拍照片,海岸线,阴天,复古汽车停靠在路边,胶片质感",
    n=1,
    size="1024x1024"
)API料金:高品質の画像生成は1枚$0.21です。
サードパーティー統合
リリース当日に、Figma、Canva、Adobe Firefly、fal、Hermes Agentがすでに統合を完了しており、これらのツールから直接GPT Image 2を呼び出せます。
注意:DALL-E 2とDALL-E 3は5月12日に正式に引退します。
実際の効果比較
Arenaのブラインドテストデータでは、GPT Image 2の勝率は**93%**です。100枚の画像をペアでブラインド選択したところ、93枚で人々はGPT Image 2の結果を選びました。
| 能力の次元 | 前世代からの向上 |
|---|---|
| 文字レンダリング | +316 点 |
| カートゥーン・アニメ | +296 点 |
| 人物画像 | +296 点 |
| プロダクト/3D/リアル | +247 から +277 点 |
制約
- ブランドロゴを正確に再現できない(ZDNetの実測では自社ロゴまで歪んで描かれた)
- Nano Banana 2は人物のリアルさと複数参照画像の一貫性で依然として優位
- 複雑なシーンではまれにディテールのズレが生じる
関連記事
同僚.Skill 徹底解説:一人の能力をAIにカプセル化するには、どう活かすべきか
GitHubで爆発的に人気になった「同僚.Skill」プロジェクト。チャット履歴や業務ドキュメントをAIに投入することで、再利用可能な仕事のSkillを生成します。本記事ではその技術アーキテクチャを分解し、自分を能動的に蒸留するか、他人に蒸留されるかという核心戦略を考察します。
GLM-5V-Turbo ビジュアル Coding 実測:スクリーンショットを投げるだけでコードが出てくる
Zhipu の GLM-5V-Turbo はネイティブビジュアル Coding モデル。スクリーンショットの再現、PDF からのグラフ抽出、表紙のスタイル転送に対応します。AutoClaw / OpenClaw / Claude Code の3つの連携方法も紹介します。
Gemma 4 オープンソース実測:31B が世界トップ3入り、2B はスマホでオフライン Agent 実行
Google が Gemma 4 シリーズをリリース。Apache 2.0 による真のオープンソースで、2B から 31B までを網羅し、スマホでオフライン実行できるマルチモーダル Agent です。ローカルデプロイガイド付き。
Seedance 2.0 + LibTV キャンバスワークフロー:並ばずに脚本から完成映像まで一気通貫
LibTVプラットフォームはSeedance 2.0フルスペック版を統合し、キャンバス式ワークフローで脚本、絵コンテ、生成、編集の全工程をつなぎます。並ぶ必要はなし。操作チュートリアルと落とし穴回避ガイド付き
Jimeng CLI 登場:エージェントから直接 Seedance 2.0 を呼び出して動画を生成
Jimeng が CLI ツールをリリース。OpenClaw や Claude Code などのエージェントの中で、自然言語から直接 Seedance 2.0 を呼び出して動画や画像を生成できます。API 設定は不要です。