Claude Code + Obsidianで自動進化するナレッジベースを構築する
KarpathyのLLM Wikiメソッドを改良した3ステップコンパイル法で、Obsidianのノートを情報のゴミ捨て場から進化し続けるナレッジ資産へ。ディレクトリ構造とプロンプトの完全版つき。
Claude Code + Obsidianで自動進化するナレッジベースを構築する
KarpathyのLLM Wikiメソッドを改良した3ステップコンパイル法で、Obsidianのノートを情報のゴミ捨て場から進化し続けるナレッジ資産へ。ディレクトリ構造とプロンプトの完全版つき。
ノートライブラリには何百本もの記事が詰め込まれているのに、同じ質問をAIに2回投げると答えが違う。概念の定義は互いに矛盾し、一度も引用されないままの記事が大量に眠っている。ナレッジベースが情報のゴミ捨て場と化してしまうのです。本記事では、KarpathyのLLM Wikiメソッドを改良した「3ステップコンパイル法」を紹介します。Claude Code + Obsidianを使って、ナレッジベースを進化し続ける資産に変える方法です。
2.0から3.0へ:何がアップグレードされたのか
Karpathy氏(OpenAI共同創業者)は2026年4月、自身のナレッジ管理手法「LLM Wiki」を公開しました。核心の考え方は一言でいえます。質問されたときに原始ドキュメントを探しに行くのではなく、LLMにすべての資料を事前に永続的なWikiへコンパイルさせておく、というものです。
典型的な2.0システムは「質問されてから探す」方式です。200本の資料を放置しておき、記事を書くときにAIへその場で検索・読解・組み立てさせる。毎回ゼロから始まるため、同じ質問でも別の会話ウィンドウで聞けば違う答えが返ってくることがあります。
3.0はその逆です。原始ドキュメントを先にLLMで「コンパイル」し、構造化された概念エントリ、メソドロジーページ、相互参照ネットワークへ変換します。コンパイル後のナレッジは永続的な資産です -- 矛盾はすでにマーク済み、相互参照は構築済みで、新しい資料を追加するときは増分更新を行います。
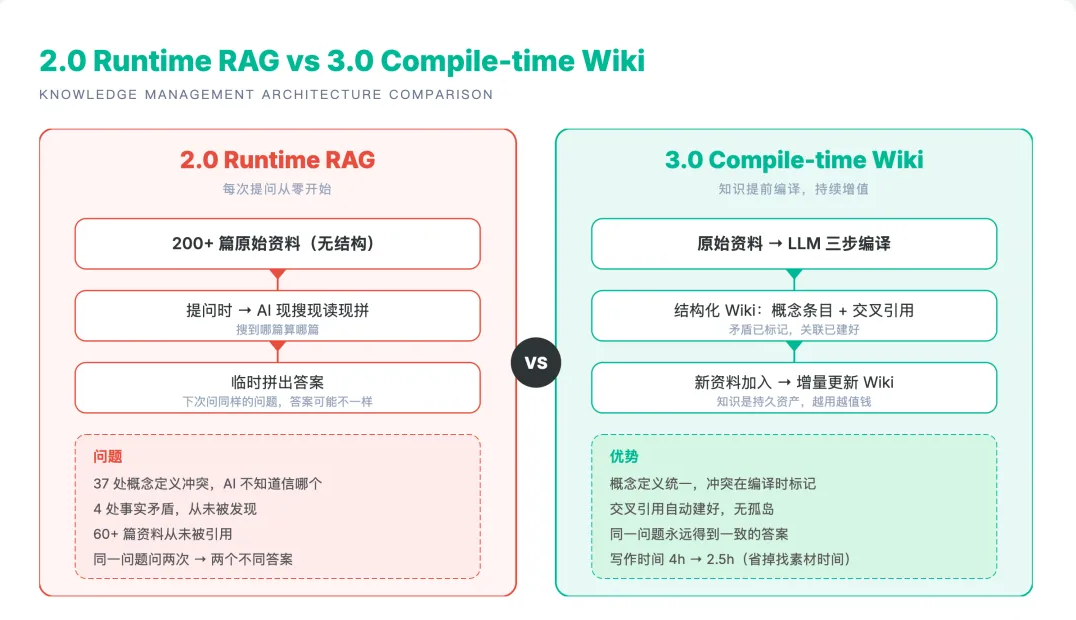
2.0 Runtime RAG vs 3.0 Compile-time Wiki のアーキテクチャ比較
始める前の準備
- Obsidian:ナレッジベースの管理インターフェースとして
- Claude Code:コンパイルエンジンとして
- Obsidian Web Clipper:Web記事を素早くクリップするために(任意)
- 体系的に管理したいナレッジ領域をひとつ
構築にかかる時間は1-2時間の見込みです。
ステップ1:ディレクトリ構造を構築する
コアはたった2つのフォルダです。raw/ には原始資料を読み取り専用で保管し、wiki/ にはLLMのコンパイル成果物を保存します。あなたは raw/ へ記事を放り込むだけ、wiki/ へのコンパイルはLLMの役目です。
以下の構造をそのままコピーしてください:
你的Obsidian仓库/
├── 02_Research/
│   ├── raw/                     # 原始资料(只读)
│   │   ├── articles/            # Web Clipper 剪藏的文章
│   │   ├── reports/             # 行业报告
│   │   └── competitors/         # 竞品分析
│   └── wiki/                    # 编译产物(LLM 维护)
│       ├── summaries/           # 逐篇编译摘要
│       ├── concepts/            # 概念条目(核心)
│       ├── methods/             # 方法论页面
│       └── indexes/
│           ├── index.md         # 全局索引
│           └── log.md           # 操作日志
└── CLAUDE.md                    # 编译规则写在这里
CLAUDE.md にコンパイルルールを追加します:
### 知識コンパイルルール

ユーザーが「コンパイル {ファイルパス}」と言ったとき、以下の手順を実行する:

1. raw/ 下の指定ファイルを読み取る
2. 3ステップコンパイル法(濃縮 → 質疑 → 照合)を実行する
3. wiki/summaries/ にコンパイル要約を書く
4. wiki/concepts/ に関連する概念エントリを作成または更新する
   - 概念がすでに存在する場合、新しい情報をマージし、ソース間の違いを注記する
   - 2本の記事の見解が矛盾する場合、エントリ内に明示的にコンフリクトをマークする
5. wiki/indexes/index.md を更新する(ソース + 関連概念を追記)
6. wiki/indexes/log.md を更新する(操作記録を追記)

概念エントリテンプレート:
---
concept: {概念名}
sources: [{ソース記事1}, {ソース記事2}]
last_updated: {日付}
---
# {概念名}
## 定義
## 重要データポイント(ソース付き)
## 前提と限界
## コンフリクトマーク(あれば)
## 関連概念
ステップ2:3ステップコンパイル法をマスターする
Karpathyのコンパイルの流れは、原文を読み、要約を書き、概念を抽出し、インデックスを更新するというもの。しかしここには盲点があります。要約は情報を圧縮するだけで、新しい知識を生成しない。立場が正反対の2本の記事も、別々にコンパイルした要約は同じ結論になるかもしれません。
私はこれに2つのステップを追加しました:
ステップ1:濃縮
核心的な結論(3つ以内)+ 重要なエビデンスだけに削り込みます。剃刀の法則の発想で:この情報を削ると理解に影響しますか?影響しないなら削ります。
ステップ2:質疑
ここがKarpathy案との重要な違いです。各核心結論について、4つの問いに答えます:
- この結論はどのような前提に依存していますか?
- その前提が成り立たない場合(業界/市場/規模の変更)、結論は依然として成り立ちますか?
- 著者のデータソースは信頼できますか?サンプル数、期間、地域の制約は?
- 著者が言及していない反例や境界条件はありませんか?
ステップ3:照合
他分野から類似の現象を探します。ほかの領域に類似の現象はないか?この知識はどのようなシーンに転用できるか?分野横断的な関連があれば、対応する概念エントリを作成または更新します。
コンパイル用の完全なプロンプト:
以下の記事に対して3ステップコンパイル法を実行してください:

### ステップ1:濃縮
- 剃刀の法則:この情報を削ると理解に影響するか?影響しないなら削る
- 出力:核心結論(3つ以内)+ 各結論を支える重要なエビデンス
- フォーマット:結論は1行ずつ、エビデンスはその下にインデント

### ステップ2:質疑
各核心結論について以下に答える:
1. この結論はどのような前提に依存していますか?
2. その前提が成り立たない場合、結論は依然として成り立ちますか?
3. 著者のデータソースは信頼できますか?サンプル数、期間、地域の制約は?
4. 著者が言及していない反例や境界条件はありませんか?

### ステップ3:照合
1. ほかの分野に類似の現象はないか?
2. この知識はどのようなシーンに転用できるか?
3. 分野横断的な関連があれば、対応する概念エントリを作成または更新する

最後に、概念エントリテンプレートに従ってコンパイル結果を出力する。
ステップ3:コンパイルを実行する
Obsidian Web Clipperで記事を1本 raw/articles/ にクリップし、Claude Codeにこう伝えます:
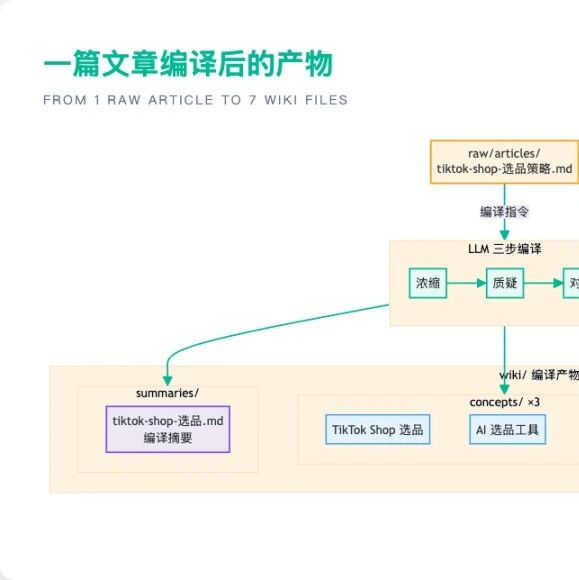
コンパイル 02_Research/raw/articles/2026-04-tiktok-shop-选品策略.mdClaude Codeは6つのアクションを実行します:
- 原文を読み取る
- 3ステップコンパイル法を実行する
wiki/summaries/にコンパイル要約を書くwiki/concepts/下に関連する概念エントリを作成または更新するwiki/indexes/index.mdを更新するwiki/indexes/log.mdに操作記録を追記する
1本の原始記事が、7つのWikiファイルの作成または更新に及ぶのです。
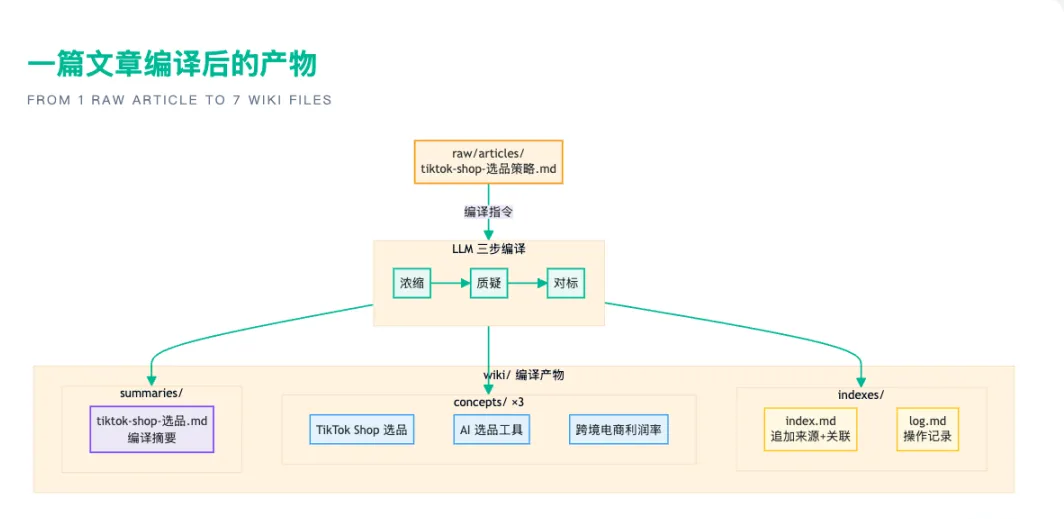
1本の記事をコンパイルした結果:1本の原始記事が7つのWikiファイルになる
重要なのはここです。次に関連する記事をコンパイルするとき、AIはゼロから始めません。既存の概念エントリを読み取り、新しい情報を古い情報とマージし、異同を注記します。矛盾があれば、エントリ内に直接マークします。
週1回のナレッジベース健全性チェック
以下のプロンプトを参考に、ナレッジベースの状態を定期的にチェックしましょう:
wiki/ ディレクトリに健全性チェックを実行し、レポートを生成する:

### 1. 一貫性チェック
concepts/ 下のすべてのエントリをスキャンし、以下を確認:
- 同じ概念の定義がエントリ間で一貫しているか
- 一貫していない場合、コンフリクト箇所と統一の方向性を列挙する

### 2. 完全性チェック
各概念エントリに必須フィールドがすべて含まれているか確認:
- 定義、重要データポイント、前提と限界、関連概念
- 欠落フィールドは「要補充」とマークする

### 3. 孤島検出
入リンクと出リンクがともに2未満のページを洗い出す
- それらのページは、他の概念との関連を作る必要がある
- あるいは重要性が低いのでマージを検討する

### 4. ディレクトリ横断の一貫性(複数アカウント構成)
各アカウントの _style-guide.md と CLAUDE.md をスキャンする
スタイルルールに漏れやコンフリクトがないか確認する

出力フォーマット:表 + 各問題の修正案
3.0が持続的に回る理由
ナレッジベースの維持で最も面倒な部分 -- 相互参照の更新、定義の一貫性維持、矛盾のマーク -- こうした作業のコストは、それがもたらす価値の伸びを追い越してしまいます。LLMはこのコストをほぼゼロまで押し下げました。1回の操作で15のファイルを同時に修正でき、忘れることも、面倒がることもありません。
大事なのは手法がどれだけ先進的かではなく、維持コストがついに無視できる水準まで下がったということです。
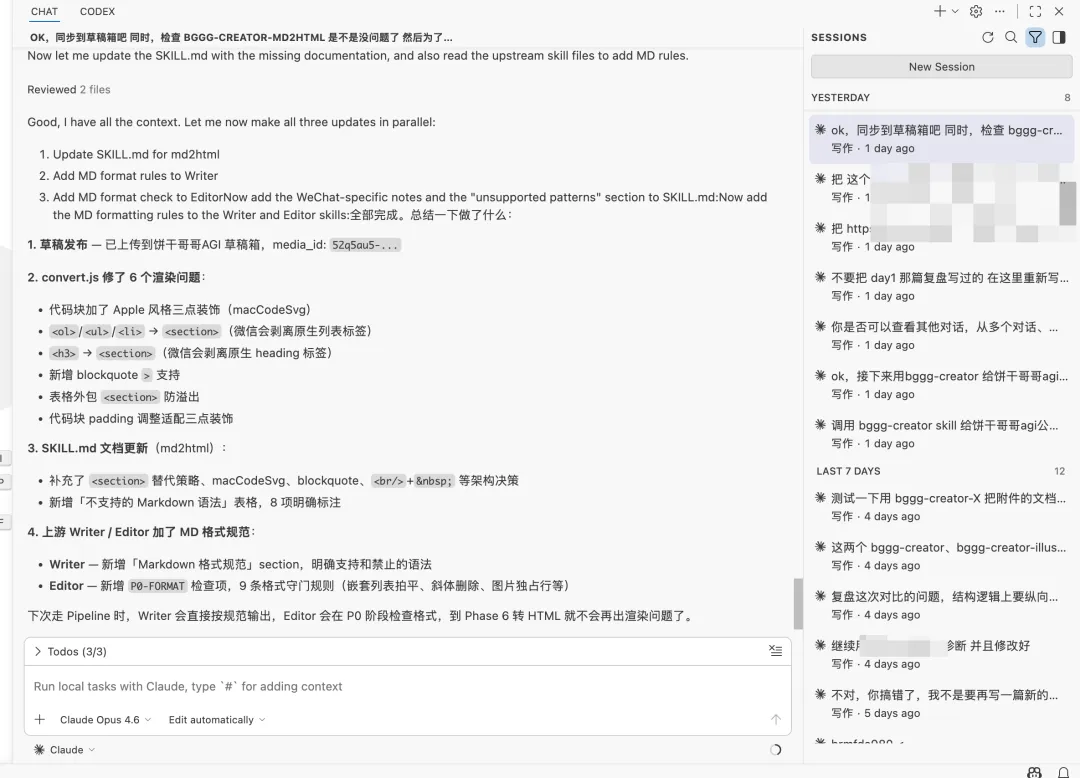
LLMは1回の操作で複数ファイルを同時に修正し、相互参照とコンフリクトマークを自動化できる