
PawBench:オープンソースのAgent評価ベンチマーク、4050のテストユニットでモデルとフレームワーク選びを支援
PawBench v1.0は150タスク・4050テストユニットのAgent評価セットを構築し、ベースモデルと実行フレームワークを同一の体系に収めて、モデル+Harnessの最適な組み合わせを見つける手助けをします。
PawBench:オープンソースのAgent評価ベンチマーク、4050のテストユニットでモデルとフレームワーク選びを支援
PawBench v1.0は150タスク・4050テストユニットのAgent評価セットを構築し、ベースモデルと実行フレームワークを同一の体系に収めて、モデル+Harnessの最適な組み合わせを見つける手助けをします。
Agentタスクが失敗したとき、それはモデルが「ちゃんと考え切れていない」のか、それともツールと環境が「正しく設定されていない」のか。この問いに答えるのはこれまで常に難しいものでした。PawBench v1.0は、ベースモデルと実行フレームワーク(Harness)を同じ評価体系に載せ、最適な組み合わせを見つける手助けをします。
PawBenchとは
PawBenchは、パーソナルアシスタントおよび汎用エージェントのシーン向けオープンソース評価ベンチマークです。単なるモデルランキングを作るのではなく、「モデル + Harness + タスク」の3つを組み合わせてクロス評価を行います。
評価マトリクス:9モデル x 3 Harness x 150タスク = 4,050テストユニット
3つのHarnessはそれぞれHermes、OpenClaw、QwenPawです。すべてのタスクはDockerサンドボックスで実行され、実行トレースと環境スナップショットが保存されます。
150タスクの5次元ラベル体系
各問題は5つの次元でラベル付けされます:
- 応用シーン:オフィス協働、ソフトウェアエンジニアリング、自動化スクリプト、マルチモーダルコンテンツ生成
- 原子能力:ツール呼び出し、Skill利用、プランニング、論理推論、自己検証
- 複雑度:L1 / L2 / L3
- 入力モダリティ:純テキスト vs マルチモーダル
- 実行環境:オフラインサンドボックス vs ネット接続必須
主要な発見
発見1:Harnessはモデルのパフォーマンスを左右する
同じモデルでHarnessだけを入れ替えると、スコア差は最大11.5ポイントに達します。最も典型的な例がqwen3.6-35b-a3bで、QwenPaw環境では70.4点を獲得した一方、Hermesでは68.2点にとどまりました。
原因としては以下が挙げられます:
- 成果物レベルのハード検証の欠如:Harnessはモデルが「完了した」と言うのを聞き入れるだけで、ファイルが本当に存在するかをチェックしない
- パス認識の不足:現在の作業ディレクトリがどこかをモデルに伝えず、モデルが誤った位置に書き込んでしまう
- ツール数の過負荷:Hermesは約65ツール、OpenClawは約30ツール、QwenPawは約15ツール。ツールが多すぎるとコンテキストを圧迫し、意思決定の負担が増す
発見2:Skillの能動的発見が弱点
3つのHarnessはいずれも17のSkillタスクで振るいませんでした。核心的な問題は、Harnessがワークスペース内のSkillファイルを能動的にスキャンせず、グローバルにプリインストールされたスキルリストにのみ依存していることです。
発見3:Web検索はデフォルトの利用可能性に依存
Hermesの検索ツールはAPI Keyを設定しないと有効化できず、ゼロ設定では「施錠された」状態になります。一方、OpenClawは認証不要のDuckDuckGo検索に対応し、ゼロ設定で直接利用できます。
Harness設計の4原則
評価結果に基づき、PawBenchはそのまま使える4つの設計原則を示しています:
| 原則 | ポイント |
|---|---|
| Inform Fully | 実行環境をモデルに明確に伝える:cwd、workspace、出力ディレクトリ、利用可能なリソース |
| Equip on Demand | 重要なツールをデフォルトで利用可能にし、ツール数をモデルのアテンション予算に合わせる |
| Monitor Actively | 成果物が本当に存在するかを確認し、モデルの「完了した」を鵜呑みにしない |
| Recover Gracefully | 異常を検出したら現在の状態を注入し、何が不足しているかを説明して、一度軌道修正の機会を与える |
誰に向いているか
- Agentユーザー:より適したモデルとHarnessの組み合わせ選びを支援
- Harness開発者:4050セルの対照マトリクス+スライス分析機能で、横断的な自己検証、失敗プロファイリング、回帰検証を支援
- 研究者:5次元ラベル体系に基づいて異なる次元のAgent能力を分析
入手方法
プロジェクトはオープンソース化されており、GitHubでagentscope-ai/PawBenchと検索すれば見つかります。新しいHarnessの接続、新しいモデルの評価結果の提出、新しいタスクの貢献を受け付けています。
関連記事
Xiaomi MiMo UltraSpeed:1兆パラメータモデルで1000 tokens/sをたたき出す
XiaomiのMiMo-V2.5-Pro UltraSpeedは、汎用8基GPU構成で1兆パラメータモデルの1000 tokens/s出力を実現。知能を絞ったFlash版ではなくProフルスペック版で、APIはすでに公開され体験申請が可能です。
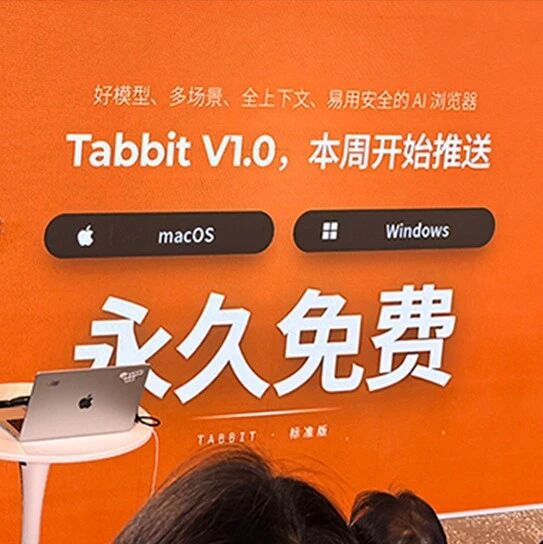
Tabbit:永久無料のAIブラウザ、10以上のトップモデルが使い放題
美团(Meituan)がリリースしたAIブラウザTabbit V1.0は、コア機能が永久無料。国内トップクラスの大規模モデル10以上とAgent能力を内蔵し、300以上の妙招(スキル)をワンクリックで呼び出せます。
AI社員に海外インフルエンサー探しを任せる:AhaCreator実践ガイド
AhaCreatorでインフルエンサー選定、コンテンツ審査から海外送金まで、海外インフルエンサーマーケティングの全工程をこなす方法を丁寧に解説します。個人開発者と海外展開チームに向いています。
AI長尺動画生成:2つのオープンソースフレームワーク比較レビュー
同日に発表された2大オープンソースフレームワーク、VideoClawとJoyAI-Echo。マルチエージェント協調とクロスモーダル記憶ライブラリという異なるアプローチでAI長尺動画の一貫性問題に挑む両者の技術方案を比較します。
ChatGPTの記憶システムが全面刷新:Dreaming V3登場
OpenAIが全新のDreaming V3記憶アーキテクチャを発表。ChatGPTが裏で「夢を見て」あなたの情報を整理し、初めて10億人の無料ユーザーに開放。Plus/Proは記憶容量が2倍になります。
CloudflareがClaude Managed Agentsに対応:開発者向け実践ガイド
CloudflareがClaude Managed Agents対応を追加しました。開発者はCloudflareプラットフォーム上でClaudeエージェントを実行し、プライベートシステムに接続して、セキュアなAIエージェントデプロイを実現できます。