
ローカルで大モデルを動かす実践ガイド:Pi + LM StudioでAgentコーディング環境を構築
PiエージェントフレームワークとLM Studio推論エンジンを組み合わせ、ローカルMacでGemma 4を動かしてAgentコーディングタスクを完了させる。完全なDocker設定とmodels.jsonの例付き。
ローカルで大モデルを動かす実践ガイド:Pi + LM StudioでAgentコーディング環境を構築
PiエージェントフレームワークとLM Studio推論エンジンを組み合わせ、ローカルMacでGemma 4を動かしてAgentコーディングタスクを完了させる。完全なDocker設定とmodels.jsonの例付き。
ローカル大モデルは「かろうじて動く」段階から「仕事になる」段階へ進んだ。本稿の著者 Vicki Boykis(あるスタートアップの創業 ML エンジニア)が HackerNews に投稿したバズ記事が証明しているのは、Pi エージェントフレームワークと LM Studio を組み合わせれば、2022年モデルの M2 Mac(メモリ64GB)1台で Gemma 4 を動かして Agent コーディングタスクを完了できるということだ——Python スクリプトのリファクタリング、ユニットテスト作成、推薦システムリポジトリの構築までこなし、ループの正確率は最先端モデルのおよそ75%に達する。本チュートリアルは完全な設定フローを分解して紹介する。ローカルにプライベートな Agent コーディング環境を作りたい開発者に向いている。
始める前の準備
ローカル Agent フローを動かすには、3つのものが必要だ。ローカルモデル推論エンジン、エージェントフレームワーク、そしてローカルのモデルアーティファクト。本チュートリアルの構成は次のとおり:
- 推論サーバー:LM Studio(GUI で設定が簡単、入門向き)
- エージェントフレームワーク:Pi(軽量の Agent フレームワーク)
- モデル:Gemma 4 シリーズ(
gemma-4-12b-qat推奨。より新しく、より小さく、より速く、正確性の低下は大きくない) - ハードウェア:Mac with Apple Silicon を推奨、ユニファイドメモリ16GB以上(著者は M2 + 64GB)
- 隔離:Docker(強く推奨。Agent の実行権限を制限)
- 所要時間:30分の設定 + モデルのダウンロード時間
- コスト:完全に無料(オープンソースツール + ローカル実行)
💡 ヒント:著者は複数のローカル推論ソリューション(Open WebUI + llama.cpp、llama-cpp-python、Ollama、llamafiles、LM Studio)を実際に試し、最終的に LM Studio を選んだ。設定のハードルが最も低いからだ。極限の速度を追うなら、llama.cpp を直接使うほうが速い。
具体的な手順
ステップ1:LM Studio のインストールとモデルのダウンロード
LM Studio 公式サイトからダウンロードしてインストールする。開いたら検索バーで Gemma 4 シリーズのモデルを探そう。推奨は:
google/gemma-4-12b-qat(推奨。小さくて速い)gemma-4-26b-a4b(性能はより強力だが、より多くのメモリを必要とする)
ダウンロード完了後、LM Studio の Local Server タブで推論サービスを起動する。デフォルトの待受は http://localhost:1234/v1(OpenAI API 形式と互換)。
ステップ2:Pi の models.json の設定
著者はすべての Pi セッションを Docker コンテナ内で実行しているため、Pi の models.json を編集して、コンテナ内の Pi がホスト上の LM Studio の推論エンドポイントにアクセスできるようにする必要がある。
キーとなる設定は、baseUrl を host.docker.internal:1234 に向けることだ(Docker からホストのサービスへアクセスする標準的な方法):
"lmstudio": {
  "baseUrl": "http://host.docker.internal:1234/v1",
  "api": "openai-completions",
  "apiKey": "not-needed",
  "models": [
    {
      "id": "google/gemma-4-12b-qat",
      "input": [
        "text",
        "image"
      ]
    }
  ]
}
このファイルを ${HOME}/.pi/agent/models.json に保存する。
💡 ヒント:
gemma-4-12b-qatはマルチモーダル入力(text + image)に対応しているため、input フィールドに両方の型が並んでいる。モデルがテキストのみ対応なら、"image"を削除すればよい。
ステップ3:Docker Compose の設定
これが最も重要なステップだ——Pi を権限を絞ったコンテナで走らせ、bash 権限だけを与える(Python コードを直接実行させず、ネット閲覧もさせず)、Agent の誤操作でホストのファイルが消されるのを避ける。
services:
  pi:
    build:
      context: .
      dockerfile: Dockerfile
    image: pi-agent:0.74.0
    init: true
    stdin_open: true
    tty: true
    extra_hosts:
      - "host.docker.internal:host-gateway"
    environment:
      ANTHROPIC_API_KEY: ${ANTHROPIC_API_KEY:-}
      OPENAI_API_KEY: ${OPENAI_API_KEY:-not-needed}
      GEMINI_API_KEY: ${GEMINI_API_KEY:-}
      OPENAI_API_BASE: ${OPENAI_API_BASE:-http://host.docker.internal:1234/v1}
      WHATEVER_API_KEY: ${WHATEVER_API_KEY:-}
    volumes:
      - ${HOME}/.pi/agent/models.json:/config/models.json
      - ${WORKSPACE:-.}:/workspace
      - pi-config:/config
      - pi-sessions:/sessions
    working_dir: /workspace

volumes:
  pi-config:
  pi-sessions:
キーポイントの説明:
extra_hostsがhost.docker.internalをホストのゲートウェイにマッピングする。これでコンテナから LM Studio にアクセスできる。OPENAI_API_BASEはデフォルトでローカルの LM Studio を指す。OpenAI 公式 API を同時に使う場合は、別途 base を指定する必要があるので注意。volumesが作業ディレクトリをコンテナにマウントし、Agent はこのディレクトリ内のファイルしか操作できない。
ステップ4:起動スクリプトの作成
以下の bash スクリプトは、コンテナのビルド、ワークスペースの設定、Pi の起動を自動化する:
#!/usr/bin/env bash
# Pi — Start the containerized Pi agent.

SCRIPT_DIR="$(cd -- "$(dirname "${BASH_SOURCE[0]}")" && pwd)"
WORKSPACE_DIR="${WORKSPACE:-$(pwd)}"

case "$WORKSPACE_DIR" in
  /) ;;
  *) WORKSPACE_DIR="$(cd -- "$WORKSPACE_DIR" && pwd)" ;;
esac

export WORKSPACE="$WORKSPACE_DIR"
sandbox="${PI_SANDBOX:-0}"
pi_args=()

while (($#)); do
  case "$1" in
    --sandbox)    sandbox=1 ;;
    --no-sandbox) sandbox=0 ;;
    *)            pi_args+=("$1") ;;
  esac
  shift
done

compose_files=( -f "$SCRIPT_DIR/docker-compose.yml" )
if [[ "$sandbox" == "1" ]]; then
  compose_files+=( -f "$SCRIPT_DIR/docker-compose.sandbox.yml" )
fi

repo_slug="$(basename -- "$WORKSPACE_DIR" | tr -c 'a-zA-Z0-9_.-' '-' | sed 's/^-//')"
[[ -z "$repo_slug" ]] && repo_slug="workspace"
container_name="pi-${repo_slug}-$$"

api_key_args=(
  -e OPENAI_API_KEY
  -e DEEPSEEK_API_KEY
  -e ANTHROPIC_API_KEY
  -e GEMINI_API_KEY
)

cmd=(
  docker compose
  --project-directory "$SCRIPT_DIR"
  "${compose_files[@]}"
  run --rm
  --name "$container_name"
  "${api_key_args[@]}"
  pi
)

if ((${#pi_args[@]})); then
  cmd+=("${pi_args[@]}")
fi

exec "${cmd[@]}"
pi という名前で保存し、実行権限を与え(chmod +x pi)、Agent に作業させたいプロジェクトディレクトリで実行すればよい。
検証結果
設定完了後、作業ディレクトリで起動スクリプトを実行する。Pi は Docker コンテナを起動し、マウントした models.json を読み込み、LM Studio の推論エンドポイントへ接続する。
著者がこの構成で完了した具体的なタスクは次のとおり:
- ある Python スクリプト(元は notebook)を5〜6個のモジュールを含むリポジトリへリファクタリングし、モジュールのコード検査を行って、ジェネリクスが正しい型ヒントを使っていることを確認した。
- ブログ記事の校正、ユニットテストの作成。
- 双塔モデルベースの推薦システムリポジトリの構築。
これらのタスクはいずれも、昨年のローカルモデルが到達できた水準をはるかに超えている。実行時の KV キャッシュは64GB RAM の上限近くまで成長し、モデルがハードウェアを本当に使い切っていることを示している。
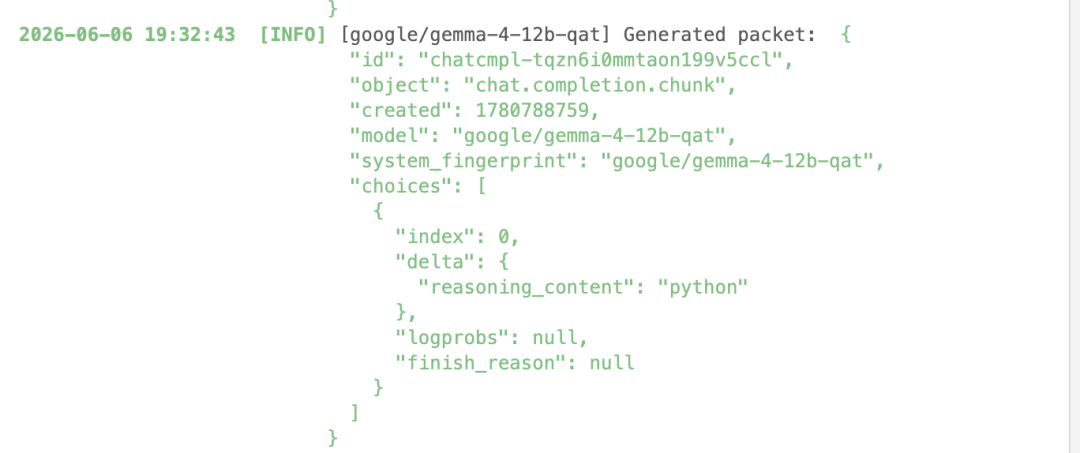
ローカル運用の最も魅力的な点のひとつは透明度だ。token の流入出をリアルタイムで観察し、コンテキストウィンドウのサイズを変更し、システムプロンプトと量子化の設定を調整し、GPU が token をどう処理するかを深く理解できる。
よくある質問
- 推論速度が遅すぎる:まずより小さいモデルを試す(
26bではなくgemma-4-12b-qatなど)。極限の速度を追うなら、LM Studio ではなくllama.cppの直接呼び出しに切り替える。 - コンテキストウィンドウが制限される:ローカルのコンテキストウィンドウのサイズは、完全にハードウェア次第だ。64GB メモリの Mac は満載近くまで耐えられる。メモリがより小さいデバイスは、より小さい量子化のモデルを選ぶ必要がある。
- プロンプトテンプレートの不一致:初期バージョンに多い問題。LM Studio と HuggingFace の「このモデルを使用」ボタンで、関連作業は大幅に簡単になった。この種の問題は通常、すぐにコミュニティが修正する。
- Agent がファイルを誤削除する:だからこそ Docker で隔離する。たとえ Agent がコンテナ内で問題を起こしても、ホストの他のファイルには波及しない。ネット機能(curl など)が必要なら、別の独立したイメージで権限を開放することをおすすめする。
- 本番環境で使えるか:著者は「本番のソフトウェア開発に完全に対応済みかは確信がない」と明言している。本番パイプラインの中核ではなく、開発支援と実験環境として扱うこと。
関連記事
Hermes Agent:オープンソースの Python プロジェクトが OpenAI Codex を破る
Hermes Agent は3つの工学的最適化で起動時間を63%短縮し、11項目の CLI ベンチマークで Rust 製の OpenAI Codex を6:5で破りました。GitHub のスターは16万を突破。
skill-cleaner:Agentのスキルをダイエットさせるオープンソースツール
ロブスターの父Peterがskill-cleanerをオープンソース化。5つの核心機能でAgentスキルの記述を監査・最適化し、Tokenコストを節約してAgentの呼び出し精度を向上。GitHubで公開済み。
SkyClaw-v1.0:Opus 4.6に迫る無料のAgentモデル
Kunlun TechがAgentモデル「SkyClaw-v1.0」をリリース。性能はClaude Opus 4.6に迫り、価格は主流モデルの半分。OpenAIインターフェースと互換で、期間限定で無料開放中。
CODA:LLMと初心者が光速のGPUカーネルを書けるようにする
MITとプリンストン発のオープンソースプロジェクト。Transformer訓練中の細切れの計算をGEMM-Epilogueパターンに書き換え、逆伝播を1.6-1.8倍高速化します。
Codexマルチマシン協働:AIメンバーの利用枠を本当に使い切る方法
4台のMacでCodexマルチマシン協働システムを構築。調査計画からバッチ動画生成までを担わせ、AIメンバーを「更新の不安」から「継続する生産能力」へと変える方法を紹介します。
ECC:Claude Code向け38エージェントのオープンソース設定システム
GitHub 15万スターのClaude Code設定ツール。38個の専門エージェント、156項目のスキル、1282項目のセキュリティテストを内蔵し、MITライセンスで完全オープンソースです。