
CODA:LLMと初心者が光速のGPUカーネルを書けるようにする
MITとプリンストン発のオープンソースプロジェクト。Transformer訓練中の細切れの計算をGEMM-Epilogueパターンに書き換え、逆伝播を1.6-1.8倍高速化します。
CODA:LLMと初心者が光速のGPUカーネルを書けるようにする
MITとプリンストン発のオープンソースプロジェクト。Transformer訓練中の細切れの計算をGEMM-Epilogueパターンに書き換え、逆伝播を1.6-1.8倍高速化します。
GPU カーネル最適化は長らく参入障壁が極めて高い分野で、通常はベテラン CUDA エンジニアによる手動チューニングが必要です。MIT、プリンストン、Together AI、Meta の研究者らが発表した CODA プロジェクトは、この状況を変えようとしています -- 一連のプログラミング抽象によって、LLM や初心者でも Transformer 向けの高性能 GPU カーネルを書けるようにするのです。
FlashAttention の中心著者である Tri Dao はリポスト時にこう断言しました:「LLM と初心者が光速カーネルを書ける」と。
論文アドレス:arxiv.org/abs/2605.19269 コードアドレス:github.com/HanGuo97/coda-kernels
課題:大モデル訓練の「手抜き税」
1枚の H100 で LLaMA-3 スタイルの 1B パラメータモデルを訓練すると、行列乗算(GEMM)とアテンションが確かに主要な計算資源を占めます。しかしプロファイラは、静かな「時間の殺人者」たちを暴き出します:RMSNorm、SwiGLU、RoPE、残差加算、層をまたぐリダクションです。
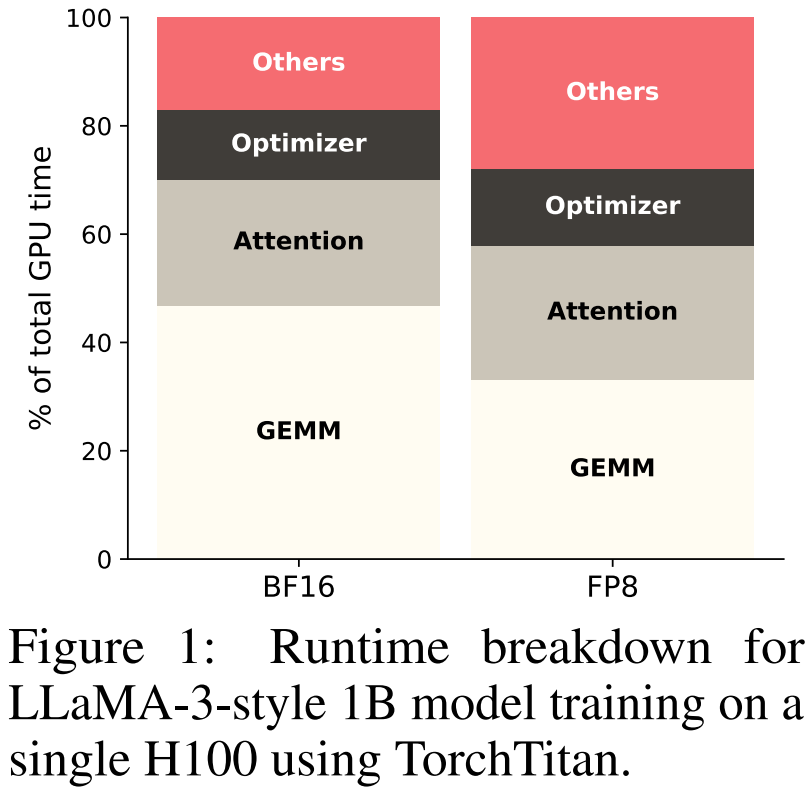
これらの操作は1つひとつ計算量は大きくないのに、大きな中間テンソルを VRAM から頻繁に出し入れします。これがメモリ帯域幅のボトルネックです -- 料理の腕が絶品のシェフが、一品作るたびに食材を遠くの倉庫から運んでは戻しているようなものです。
FP8 や FP4 といった低精度フォーマットで行列計算がどんどん速くなるにつれ、こうした「運搬」操作の相対コストは逆に上昇しています。PyTorch は Transformer を一連のオペレータ列として表現するため、オペレータ間の境界がまさに、オペレータをまたぐ融合最適化を妨げています。
核心の洞察:「エピローグ」に宝が眠る
GPU 上の高性能行列乗算(GEMM)カーネルは2つの部分に分かれます:
- メインループ(Mainloop):核心となる行列のタイル分割乗加計算
- エピローグ(Epilogue):結果を VRAM に書き戻す前の仕上げ処理(バイアス加算、型変換など)
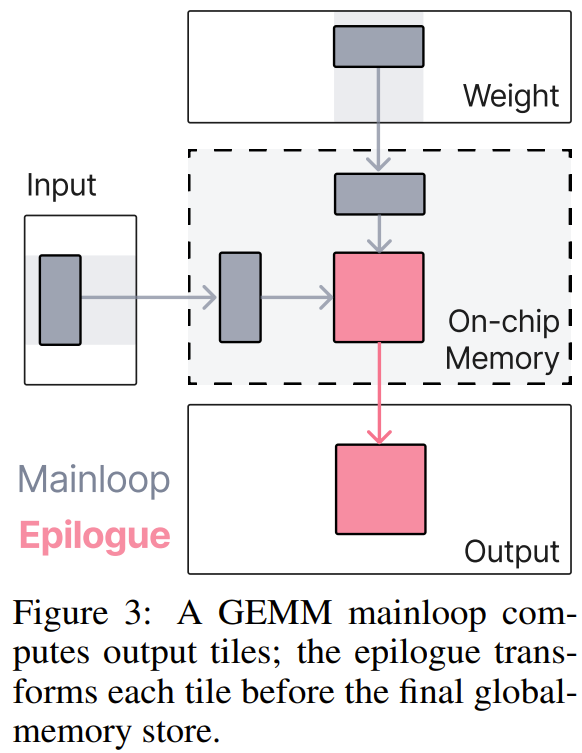
エピローグが存在する意味は、この時点で行列乗算の出力がまだオンチップのレジスタに「生きて」おり、グローバル VRAM には書き込まれていないことです。これはごく短い黄金の窓です -- この瞬間に多くの計算を詰め込めれば、VRAM への書き込みと再読み出しの往復を1回節約できます。
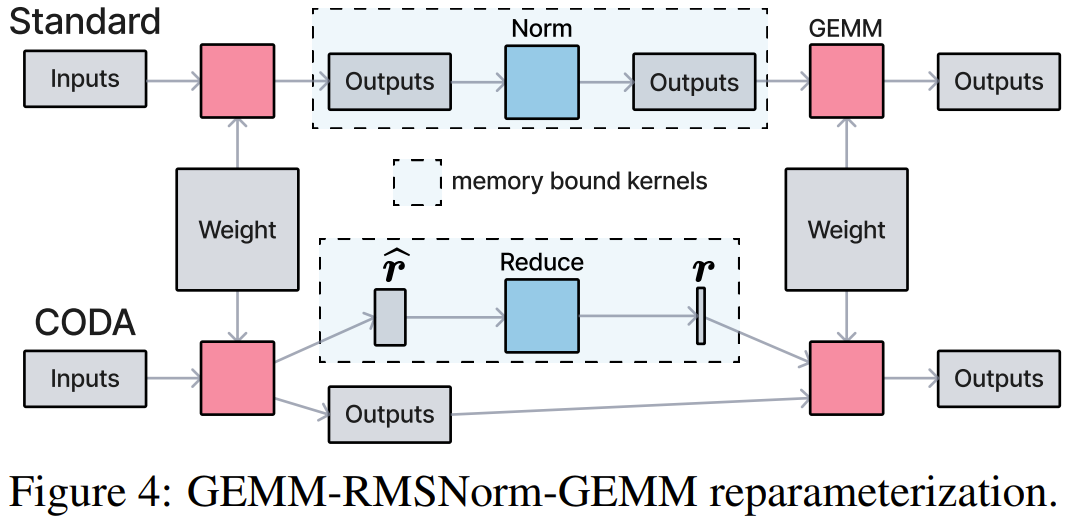
CODA の核心の洞察は、Transformer のメモリ集約型操作を代数的に再パラメータ化し、「エピローグ」の窓に押し込んで実行できるということです。
最も一般的な GEMM-RMSNorm-GEMM パターンを例にとると、RMS 正規化の行スケーリング係数 r は後続の行列乗算と可換なので、r の適用を2番目の GEMM のエピローグまで遅らせられます。こうして完全な RMSNorm 計算が消えます。
組み合わせ可能な5種類の「積み木」
CODA は特定の融合カーネルではなく、一式のプログラミング抽象です。専門家が最適化した GEMM メインループを固定した上で、エピローグの位置に5種類の組み合わせ可能なプリミティブを公開します:
| プリミティブ型 | 用途 |
|---|---|
| 要素ごとの変換 | 残差加算、活性化関数、RoPE |
| ベクトルのロードとストア | RMSNorm 重みのブロードキャスト |
| 行列タイルのロードとストア | 逆伝播用の中間活性の保存 |
| タイル単位リダクション | 局所二乗平均、タイル分割 log-sum-exp |
| 状態付き変換 | オンライン正規化に必要な max と sum-exp の統計 |
この5種類の積み木で、標準的な Transformer の順伝播と逆伝播のうち、アテンション以外のほぼすべての操作をカバーできます。
LLM は GPU カーネルを書けるのか?
論文では2つの実装モードが評価されました:
- CODA (LLM):Claude Code が生成。研究者がプリミティブの説明、サンプル、実装ログを提供し、AI が本体コードを完成、人間は軽い監督のみ
- CODA (Human):人間のプログラマが同じ再パラメータ化の発想で独立して作成
LLM が生成したカーネルはほとんどのベンチマークで手書き版と互角であり、一部の構成ではわずかに上回ることさえありました。GPU カーネル最適化という、従来は参入障壁が極めて高かった分野では、これは稀有な結論です。
実験結果
ベンチマークは厳しい相手を選びました:cuBLAS + torch.compile、Liger Kernel、FlashInfer です。
重要なデータ:
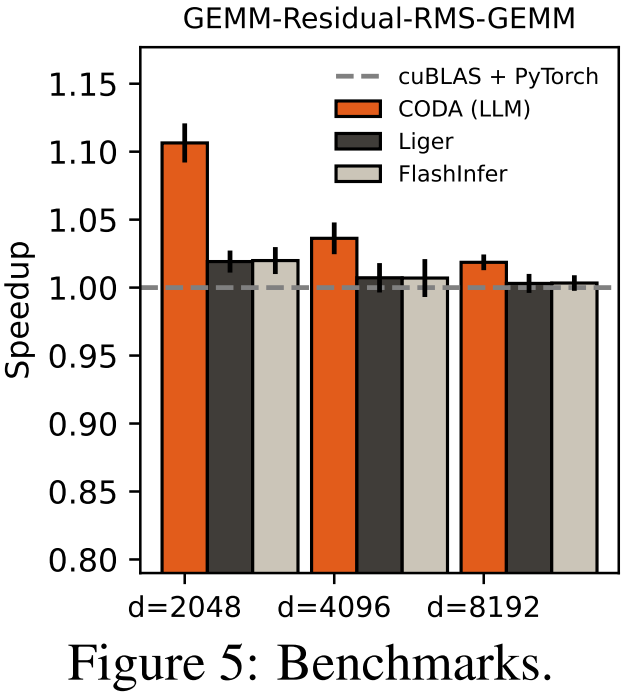
- GEMM-RMSNorm-GEMM:1B、7B、70B の3つのモデル規模の隠れ次元で、いずれも cuBLAS + PyTorch のベースラインを上回る
- 逆伝播の利益は特に顕著:GEMM-Residual-PartialRMS-GEMM の逆伝播カーネルはベースライン比で 1.6-1.8倍 に高速化
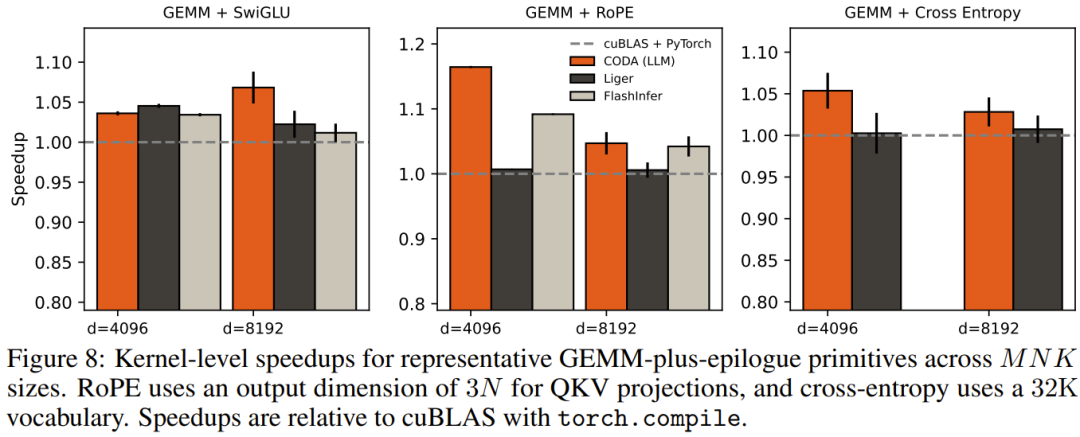
- SwiGLU の逆伝播:約1.4-1.6倍の向上
- LLM と人間の実装の差はわずかで、逆伝播の方向ではほぼ一致
向いている人
- 大モデルを訓練するチームで、GPU 性能の最後の一滴まで絞り出したいところ
- GPU カーネル最適化の初心者で、高レベルの抽象で高性能コードを書きたい人
- 「AI は GPU カーネルを書けるのか」という命題を検証したい研究者
参考リンク:
関連記事
XtraGPT:全文コンテキストに基づく AI 論文修正ツール
ACL 2026 論文。20 条の学術ライティング基準と全文コンテキストモデリングにより、AI による論文修正を漠然とした推敲から制御可能な的確なリビジョンへ変える
一行のコードで Fable 5 を復活させる:システムプロンプト注入の実践と原理解析
漏洩した Fable 5 のシステムレベル Prompt と --system-prompt-file パラメータを使い、Opus 4.8 に Fable 5 の「人格の原稿」を注入して近い出力効果を実現する方法
FuseSearch:40 億パラメータの小型モデルが商用大規模モデルのコード特定能力を圧倒する仕組み
Ant Group の ACL 2026 新作 FuseSearch-4B。適応的並列検索戦略により、コード特定タスクで Claude Haiku 4.5 と同等の性能を達成。速度 93.6% 向上、Token 68.9% 削減
GLM-5.2 の 100 万トークンコンテキスト実測:85 ページのワールドカップ展望を一括生成
Zhipu の GLM-5.2 は 100 万 token コンテキスト対応、来週 MIT ライセンスでオープンソース化。85 ページのワールドカップ展望 PPT を実測で完了させ、マルチ agent 並列処理の効率は期待を超える
OpenRouter Fusion チュートリアル:3 モデル組み合わせで Fable 5 を代替、コスト半減
OpenRouter の Fusion マルチモデル融合。Kimi K2.6+DeepSeek V4 Pro+Gemini 3 Flash の組み合わせで、DRACO ベンチマークにおいて Fable 5 に性能で並び、コストはわずか 50%
VeraRetouch:0.6BパラメータのAIレタッチモデル、スマホ端末内処理の新手法
vivoが浙江大学と共同でVeraRetouch軽量レタッチフレームワークを発表。0.6Bの視覚言語モデルをベースに、自動レタッチ・スタイルレタッチ・パラメータレタッチに対応し、iPhone上で13秒で処理を完了します。