
Doubao Seed-Audio 1.0 実測:キャラ対話・効果音・BGMを一度に生成
Volcano Engine の Seed-Audio 1.0 は映像級の全要素ダイレクト出力へ進化。1本のプロンプトで多キャラの対話、効果音、BGMを生成し、完成映像級の音に迫ります。
Doubao Seed-Audio 1.0 実測:キャラ対話・効果音・BGMを一度に生成
Volcano Engine の Seed-Audio 1.0 は映像級の全要素ダイレクト出力へ進化。1本のプロンプトで多キャラの対話、効果音、BGMを生成し、完成映像級の音に迫ります。
Volcano Engine は前世代の「Doubao 音声合成モデル 2.0」を直接アップグレードし、「Doubao オーディオ生成モデル 1.0(Seed-Audio 1.0)」に改称しました。「音声合成」から「オーディオ生成」への変化は単なる改名ごっこではありません——1回のプロンプトでキャラクターの対話、環境効果音、BGMをパッケージとして出力できることを意味します。キャラAを生成し、キャラBを生成し、BGMを重ね、最後に編集ソフトに放り込んで段階的に揃える、といった作業はもう不要です。本記事では3つの実測ケースで、何ができて境界がどこにあるかを説明します。
Seed-Audio 1.0 とは
「AI 版のアフレコポストプロセスワークフロー全体」と捉えるとよいでしょう。従来のワークフローでは、声優を呼んでセリフを収録し、効果音担当に環境音を敷かせ、作曲家にBGMを作ってもらい、最後にミキサーが合成します。Seed-Audio 1.0 はこの一連の流れを1本のプロンプトに圧縮します——情景を描写すると、ボーカル、効果音、音楽をそのままパッケージ出力します。コアのアップグレードポイントは公式に「映像級全要素ダイレクト出力」と名付けられました。
コア機能
機能1:長尺の継続生成と、セグメントをまたぐ音色の一貫性
前バージョン 2.0 の「デザイナーの独白」パートをそのまま残し、1.0 で続きを生成すると、全体で1分10秒になりました。最初の16秒は元の独白で、16秒目から彼とクライアントの対話に入ります——同じ役柄、同じ音色、同じ疲弊した状態のまま、シーンが一人の独白から二人の対峙へと変わります。
重要なディテール:電話を切った後の「プー——プー——プー——」という話中音と3秒間の沈黙は、AIが自力で生成したもので、後からの重ね加工は一切ありません。これが「全要素ダイレクト出力」の実力です——1つのナラティブがどんな音のリズムを必要としているかを理解しているのです。
機能2:1本のプロンプトで漫劇の完全なアフレコを生成
テストシーン:3人漫劇の脚本を用意しました——ナレーション(青年男性)、長老(老年男性)、少年。セリフは極めて感情の張りが強く、ナレーションは低く渋い国風漫劇の口調、長老の声は老いて嗄れ、見下すような軽蔑を帯び、少年の声は澄み切って怒りを孕んでいます。
ボーカル以外にも、脚本には古箏、大太鼓、弦楽、足音の摩擦、霊剣の抜鞘、金属の打撃、群衆のどよめき、鐘の音が仕込まれています——爽快系ストーリーに必要な要素が揃っています。
旧来のワークフローでは、各キャラクターを個別に生成 → BGMを探す → 足音、掌風の音、火鉢の音を重ねる → 編集ソフトに放り込んで段階的に揃える、という手順が必要でした。Seed-Audio 1.0 は1本のプロンプトで、漫劇全体に必要な音の雰囲気をパッケージで出力します。
機能3:スポーツ実況もダイレクト出力できる
「カーボベルデのゴールキーパーがスペインを無失点に抑えた」という実際のワールドカップの背景を使い、実況を生成させました。スポーツ中継に必要なのは、綿密に並べられた劇的なサウンドデザインではなく、混沌とした臨場感です。観客が叫び、スタジアムに反響が響き、実況アナは試合の流れに沿って——抑え、加速し、爆発し、沈静化していきます。
実際に聴くとレイヤーが明瞭です。ボーカルが手前、現場音が奥にあり、背景の群衆の声がボーカルを覆い隠さず、まるで本当に中継席に座っているように聴こえます。
漫劇の脚本で多キャラシーンをテスト。キャラクターごとの音色、感情、空間的な配置が一度に再現されました。
実際に使ってみて
メリット
- ポストプロセス削減:最も直接的な実感は、DAW(デジタルオーディオワークステーション)を開いてトラックを揃える必要がなくなったこと。1本のプロンプトを入力すれば、完全な音が出てきます。
- 感情に演出がある:単に人間らしいだけでなく、音で情景を「演出」できます。例えばクライアント側のボスが叩き起こされたときの眠気や、電話を切った後の話中音も、ナラティブの一部です。
- 臨場感がリアル:スポーツ実況のような混沌としたレイヤー感(ボーカル+群衆+反響)が必要なシーンで、レイヤーが明瞭に分かれて濁りません。
限界
- 複雑で長いパートは後半ほど苦しくなる:動画生成と同様、複雑なパートほど後半で再現度が割り引かれ、分割生成か人的介入による微調整が必要です。
- プロンプトの腕前が要求される:「全要素ダイレクト出力」は記述能力へのハードルがより高く、キャラ、シーン、感情の流れ、必要な効果音を書き明かにしないと、モデルが勝手に補完します。
応用シーン
- オーディオブック / 漫劇 / ショートドラマのアフレコ:以前からコミュニティでは「いつ番茄小説に搭載されるのか」と催促の声がありました。全要素ダイレクト出力により、音声コンテンツの工業化が現実味を帯びます
- ショート動画のポストプロセス音声:vlog や解説の環境音と BGM をまとめて産出
- スポーツ / ニュースの現場実況:臨場感と感情のレイヤーが必要なコンテンツ
- ゲームのカットシーンアフレコ:NPC の対話、戦闘効果音、BGM を一度で仕上げる
API は招待制テストを開始しており、Volcano Engine Ark コンソールから申請できます。
関連記事
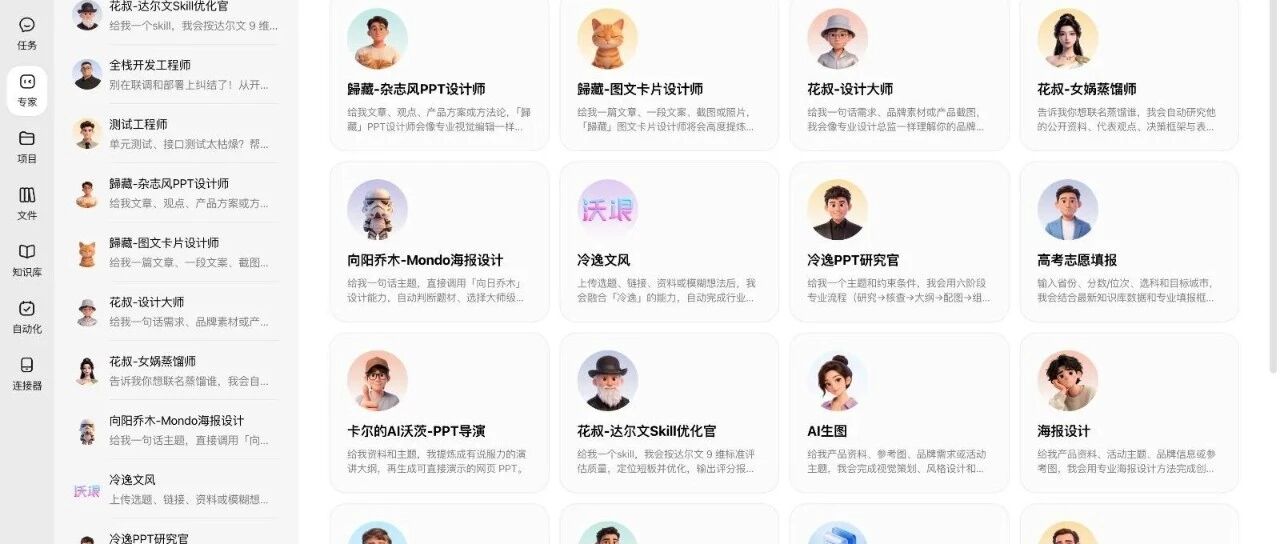
Nami Work 実測レビュー:たった一言で3社の大規模モデルをまたぎ、32秒のプロモーション動画を自動編集
ByteDance の Nami Work(Work.n.cn)を実際のタスクで検証——プロンプト1本で Seedance 2.0 のテキスト動画生成 + MiniMax TTS + ffmpeg を呼び出し、3社のモデルベンダーをまたいで32秒のプロモーション動画を完成。その過程、判断、制約がすべて画面上に可視化されます。
Opus 5「チャレンジループ」プロンプト:AI 自身に発注側を演じさせ、24時間で3Aゲームのプロトタイプを作らせる
Matt Shumer の「チャレンジループ(Challenge Loop)」プロンプトは、Opus 5 を「メイン Agent + 制作 Agent + 審査 Agent」のマルチエージェント構造で自走的に反復させ、Three.js + Blender MCP と組み合わせて、たった1人で24時間以内に『Outer Wilds』級のブラウザゲームを再現します。
DyRef 実践ガイド:Qwen 画像編集モデルに複数参照の一貫性を加え、7枚の参照図でも崩れない
ハルビン工業大学(深圳)の DyRef(ECCV 2026 Oral)は、Qwen-Image-Edit-2511 の上に重ねる複数参照一貫性のファインチューニング手法 + RL 動的報酬トレーニングフレームワークで、最大7枚の参照図でも被写体・ポーズ・スタイルの一貫性を保ちます。本稿ではローカルでの推論と、任意の SFT/RL トレーニングの実行方法を解説します。
Qwen Office 実測レビュー:7分で決算PPTを作り、3シナリオでAlibabaの新オフィスAgentを検証
Alibaba の Qwen Office(qwenwork.cn)実測チュートリアル。決算PPTの生成、ポッドキャストの Feishu ドキュメント化、EC サイト構築の3つの再現可能シナリオをカバーし、価格、クレジット消費、失敗の避け方も添付します。
SearchOS:中国人民大学 + Ant Group オープンソースのマルチエージェント検索フレームワーク、検索状態をインフラに変える
SearchOS は中国人民大学と Ant Group が共同オープンソース化したマルチエージェント検索コラボレーションフレームワーク。リレーショナルデータベースの考え方を取り入れ、検索状態をスケジューリング可能なインフラに変え、約280の検索スキルを内蔵しています。
天工動画Agent 実践ガイド:脚本から書き出しまで、ブランド周辺グッズ動画を一気通貫で作る
Kunlun Tech の天工動画Agent(ブラウザ内で動く AI video workbench)の完全実践チュートリアル。8つのステージを通じて、ブランドのプロンプトから1080P の完成映像までを解説し、デザインスペックの蓄積とブラインドボックスシリーズへの再利用テクニックも添付します。