
cavemanプラグイン:Claude Codeの無駄話を減らしてTokenを節約
GitHub 2万Starを突破して話題のcavemanプラグイン。AIの出力スタイルを簡潔にしてToken消費を節約します。Claude CodeとCodexに対応し、三段階の圧縮強度を用途に応じて切り替えられます。
cavemanプラグイン:Claude Codeの無駄話を減らしてTokenを節約
GitHub 2万Starを突破して話題のcavemanプラグイン。AIの出力スタイルを簡潔にしてToken消費を節約します。Claude CodeとCodexに対応し、三段階の圧縮強度を用途に応じて切り替えられます。
Claude CodeやCodexで開発しているなら、こんな悩みを抱えたことはないでしょうか。欲しいのは二行のコードなのに、AIは五段落もの「正規表現エッセイ」を書いてくる。cavemanプラグインはこの問題を解決するためのものです -- AIに洞穴人のように話させ、技術的な意味に影響しない社交辞令をすべて削除し、出力Tokenを約75%節約できると謳っています。
cavemanとは
cavemanはClaude CodeとCodexの両方に対応するSkill/プラグインで、GitHub Starは2万を突破しています。核心のアイデアはシンプルです。AI Agentに最も簡潔な形で技術コンテンツを出力させ、正確性は犠牲にせず、無駄口だけを削るのです。
- プロジェクトURL: https://github.com/JuliusBrussee/caveman
- 作者: Julius Brussee
cavemanのGitHub Star増加曲線。Hacker Newsで爆発的に話題になった後、数十から2万へと急騰しました。
インストール方法
cavemanはClaude CodeのSkillメカニズムを基盤に動作します。インストールはとても簡単で、コマンドひとつで完了です。
npx skills add JuliusBrussee/cavemanインストール後、Claude Codeで以下のいずれかのキーワードを入力すれば有効化できます。
caveman modetalk like cavemanuse cavemanless tokensbe brief/caveman(スラッシュコマンド)
三段階の圧縮強度
cavemanは三つの圧縮レベルをサポートしており、用途に応じて選択できます。
liteモード:フィラー語を削除し、完全な文は維持
プロフェッショナルで簡潔な出力が求められるシーンに適しています。
「接続プールは、すでに開かれているデータベース接続を再利用します。リクエストごとに新規に作成するのではなく、重複するハンドシェイクのコストを避けるのです。」
fullモード(デフォルト):断片的な文+短い語への置き換え
典型的なcavemanスタイル。装飾的な語を削ぎ落とします。
「接続プールは開かれたDB接続を再利用。リクエストごとに新規作成はしない。ハンドシェイクのコストを削減。」
ultraモード:大量の略語+矢印表現
極限の圧縮。よく使う用語を略語に置き換えます。
「接続プール=DB接続を再利用。ハンドシェイクをスキップ→高同時実行でも高速。」
実際の効果比較
以下は、バグ修正シーンの出力比較です。
通常モード:
もちろんです!喜んでお手伝いします。お困りの問題は、認証ミドルウェア内のトークン有効期限判定ロジックに起因している可能性が高いです。具体的には、判定条件に小なり(<)を使っており、小なりイコール(<=)にすべきところを...
cavemanモード:
バグは認証ミドルウェア。Tokenの有効期限判定で
<を使っており、<=になっていない。ここを修正:
コードブロックとエラーメッセージは変更されず、自然言語の説明部分だけが圧縮されます。
コア圧縮ルール
cavemanの SKILL.md には具体的な圧縮戦略が定義されています。
- 削除: 冠詞、語気のフィラー、社交辞令、躊躇を示す表現
- 許容: 短文、断片的な文
- 優先使用: より短い同義語(「大きい」で「巨大な」を置き換え、「修正する」で「解決策を実装する」を置き換える)
- 変更しない: 技術用語、コードブロック、エラーメッセージ
- 推奨文型: [問題][アクション][理由]。[次のステップ]。
注意点
利用を決める前に、いくつかの重要な制限を把握しておく必要があります。
1. 可視出力だけを圧縮し、思考プロセスは圧縮しない
作者自身がHacker Newsで明確にしていますが、cavemanはhidden reasoning tokensやthinking tokensには影響しません。モデルがバックグラウンドで行う推論プロセスは短くならず、最終的に口に出す部分だけを圧縮します。
2. Skill自体がコンテキストを消費する
cavemanというSkillを読み込むこと自体が、一定のコンテキスト予算を占有します(Anthropic公式ドキュメントに説明があります)。したがって、エンドツーエンドの実際のコスト削減は、READMEの「75%」と一致するとは限りません。
3. 75%というデータの出所
作者はベンチマークスクリプトと、いくつかのタスクにおけるToken比較(22%から87%の範囲、平均65%)を公開しています。ただし作者自身も、これは初期テストであり厳密なベンチマークではないと述べています。
Token節約の比較データ。タスクによって節約率の差はかなり大きいです。
学術的な裏付けはあるか
関連する二本の論文が、「簡潔な出力は必ずしも性能を損なわない」ことについて背景を提供しています。
- 2024年の論文《The Benefits of a Concise Chain of Thought》は、モデルに簡潔な推論チェーンの使用を求めると、回答の長さが48.70%減少し、問題解決能力にはほぼ目立った低下がないことを発見
- 2026年の論文《Brevity Constraints Reverse Performance Hierarchies》は、大規模モデルに簡潔さの制約を加えると、精度が26ポイント向上しうると指摘
ただしこの二つの研究は汎用的な簡潔プロンプト戦略を扱ったものであり、caveman専用の評価ではありません。
適したシーン
cavemanが向いているのは、次のようなシーンです。
- 日常のコーディングタスク:バグ修正、機能追加、ツールスクリプトの作成。AIにエッセイを書かせる必要はない
- Token予算が厳しい:従量課金のプロジェクトでは、一円でも節約したい
- 大量のコード修正:複数ファイルを同時に修正し、冗長な出力を減らす
- CI/CD内のAgent:自動化フローでは人間に優しい説明は不要
向いていないシーン:
- 新しい概念を学ぶとき、AIに詳しく解説してほしい場合
- コードレビューで、AIに設計の考え方を分析してほしい場合
- 非エンジニアのチームメンバーと協業するとき
cavemanが人気を博したのは、本質的にはひとつのシグナルです。開発者はAIの冗長な出力にうんざりしている。ユーザーが冗長なTokenにお金を払い続けるくらいならAIに「洞穴人」のように話させることを選ぶのであれば、「抑制」こそがAIツールの基本能力になるべきだと物語っています。
関連記事
NVIDIA RTX Spark:NVIDIA が AI PC を再定義、128G 統合メモリで 120B モデルをローカル実行
NVIDIA がコンシューマー向け AI チップ RTX Spark を発表。128GB 統合メモリと 1 PFLOP の演算力を搭載し、14mm のノート PC 上で 120B 大規模モデルをローカル実行可能に。Windows エコシステムは AI PC 時代を迎える
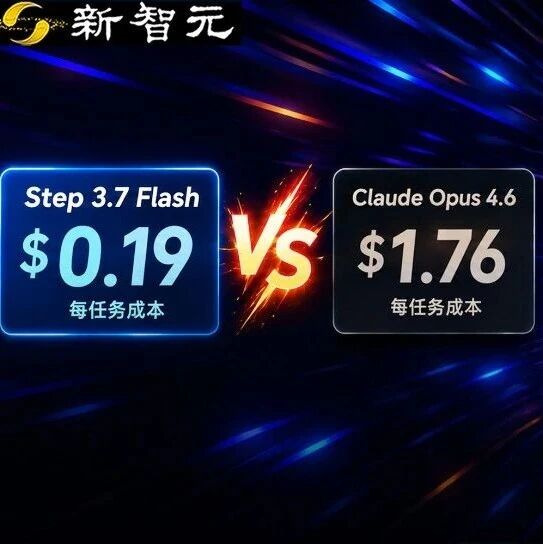
Step 3.7 Flash 実測:400TPS の超高速推論、Agent タスクのコストは Claude のわずか1/9
StepFun が Step 3.7 Flash を発表。400トークン/秒の推論速度で、11B の活性化パラメータで Claude Opus 4.6 の97%の性能を実現。オープンソースでローカルデプロイも可能
ClawGym:Agent の訓練・評価一体化オープンソースフレームワーク
人民大学が Claw Agent のデータ+訓練+評価を一気通貫でつなぐフレームワークをオープンソース化。13.5K の実行可能タスクを含み、サンドボックス並列強化学習をサポート
Codex Computer Use が Windows に登場:実践ガイド
OpenAI Codex が Windows PC の操作を正式サポート。完全な有効化手順、制限事項の説明、スマホからのリモートコントロール方法を紹介
Gamma-World:オープンソースのマルチエージェント世界モデル
NVIDIA が清華大学と共同でマルチエージェント世界モデルをオープンソース化。2人での訓練から4人へ直接汎化し、ゼロショットでの多人数シーンのリアルタイム推演をサポート
Step 3.7 Flash を Claude Code に接続:実測ガイド
StepFun のオープンソース Flash モデルを Claude Code に接続する実測レポート。複雑な Agent ワークフローで、中国製モデルがクローズドソース基盤の代わりを果たせるかを検証