
FineVLA:どちらの手で、どこを掴むか、一言で全部決まる
香港大学 XLANG Lab × Alibaba Qwen チームが FineVLA フレームワークをオープンソース化。ロボットポリシー学習における言語監督を「何をするか」から「どうやるか」へ細分化し、RoboTwin シミュレーションで 86.8% の成功率(+15)、実機双腕で 62.7/100 を達成。コード、モデル、ベンチマークをすべて公開しています。
FineVLA:どちらの手で、どこを掴むか、一言で全部決まる
香港大学 XLANG Lab × Alibaba Qwen チームが FineVLA フレームワークをオープンソース化。ロボットポリシー学習における言語監督を「何をするか」から「どうやるか」へ細分化し、RoboTwin シミュレーションで 86.8% の成功率(+15)、実機双腕で 62.7/100 を達成。コード、モデル、ベンチマークをすべて公開しています。
ロボットに「カップをカゴに入れて」と伝えると、ロボットはタスクを完了できます。しかし、どちらの手を使うか、どの方向から近づくか、カップの本体を掴むか持ち手を掴むか——実行の質を決めるこうした細部は、既存のロボットデータセットではほとんど注釈されていません。そのためモデルが学ぶのは「最終的に成功すること」であり、言語から実行上の制約を学ぶことは難しくなります。香港大学 XLANG Lab と Alibaba Qwen チームが共同で提案した FineVLA フレームワークが解決しようとしているのは、まさにこの長年の痛みです。VLA モデルがタスクを完了できるだけでなく、人間が指定したやり方でタスクを完了できるようにします。
最良の混合ポリシーは RoboTwin シミュレーションで 86.8%/82.5% に達し(ベースライン比 +15.0/+11.1)、実機の双腕ロボットでは 62.7/100 に達しました(Raw-only は 49.9)。コード、モデル、評価ベンチマークはすべてオープンソースです。
接触領域、対象物体、実行アーム、軌跡方向、失敗回復——こうした実行に敏感な要素はすべて言語で制御できます。
背景:VLA モデルはなぜまだ「言うことを聞かない」のか
VLA(Vision-Language-Action)モデルはすでに自然言語に基づいて掴みや置きを行えますが、言語監督の粒度が粗すぎます。同じ「スプーンを拾う」でも、異なる軌跡は左腕を使うか右腕を使うか、障害を迂回するか直進するか、スプーンの持ち柄に触れるか先端に触れるかが異なるのに、データセットではしばしば同じ 1 本の目標級指令が共有されています。
これは監督の曖昧さをもたらします。モデルは「成功」を学んでも、どちらの手を使うか、どの方向から近づくかといった実行制約は学べません。制御可能な VLA システムの構築には 3 つの核心的課題があります:
- 異種データから細粒度注釈へのインフラが不足
- ロボットの細粒度理解を評価するベンチマークと、スケーラブルで低コストの注釈器が不足
- 細粒度言語が本当にポリシー学習を向上させるかの体系的証拠が不足
FineVLA はこの 3 つの問題を一度に受け止め、「データ—モデル—評価—ポリシー」の完全なループを形成します。
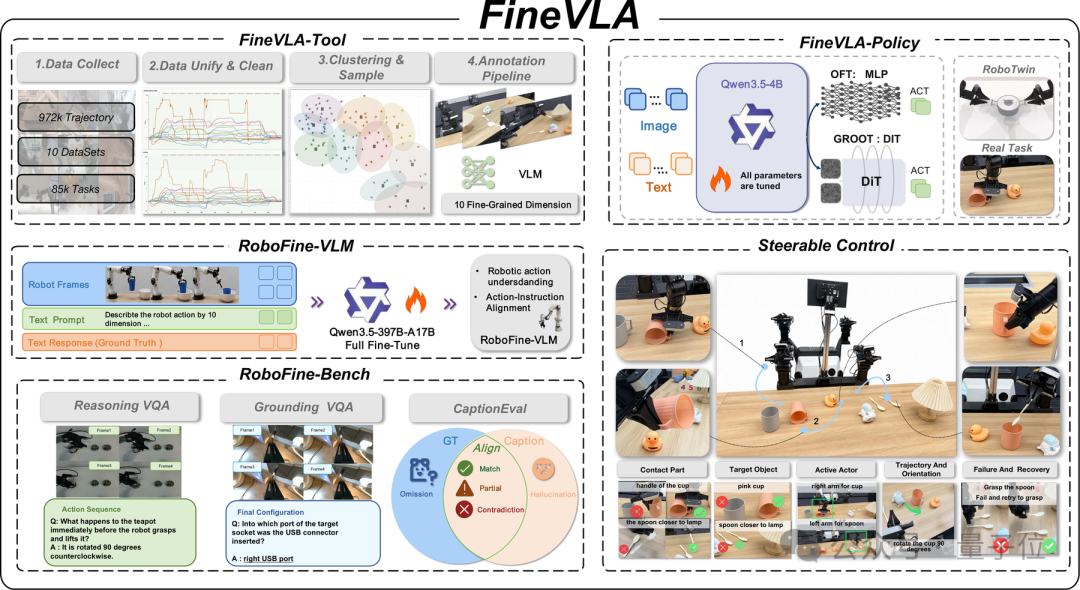
左側:FineVLA-Tool のデータ構築。右側:FineVLA-Policy のポリシー学習。
4 つの核心コンポーネント
FineVLA-Tool:97 万本の軌跡 → 47159 本の代表的サンプル
異種ロボットデータを高品質な細粒度監督に変換する、4 つの段階:
- フォーマット統一:Bridge V2、BC-Z、RT-1、RoboMIND など 10 個のオープンソースデータセットから 972247 本の軌跡を集約し、LeRobot2.1 フォーマットに統一
- 動作の正規化:まちまちな時間参照と運動学表現を絶対座標 + 正規化四元数回転に統一し、破損軌跡を除去
- DTW クラスタリングによる重複除去:動的時間伸縮に基づいて動作類似度を計算して階層クラスタリングを行い、97 万本から 47159 本の代表的サンプルを精査
- 10 次元の細粒度注釈:動作シーケンス、実行体(左/右腕)、対象物体、接触と接近の方式、軌跡方向、失敗回復などの 10 次元——平均語数は 9.3 から **96.8(10.4 倍)**へ増加
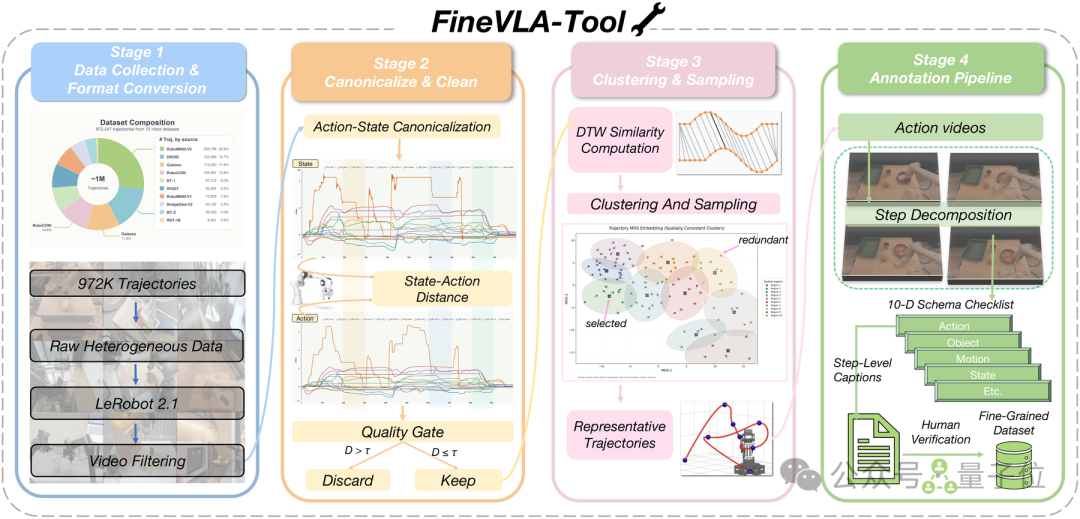
10 個のオープンソースデータセットから 97 万本の軌跡を集約し、フォーマット統一 + クラスタリングによる重複除去 + 10 次元の細粒度注釈を行います。
RoboFine-VLM:VLM にロボットが「どう動くか」を記述させる
汎用 VLM は、物体の曖昧さの区別、接触領域、運動経路といった実行の細部をしばしば見落とします。チームは Qwen3.5-VL-397B-A17B に全パラメータの教師ありファインチューニングを行い、RoboFine-VLM を得ました——10 個の制御次元をカバーするステップ級の動作記述を出力でき、将来のデータ拡張に使えるスケーラブルな注釈器になります。
RoboFine-Bench:細粒度の動作理解を評価
500 本の動画、32 種のロボット形態、11631 個の原子事実を含み、学習セットとは厳密に重複なし。2 つのトラックが設けられています:
- VQA トラック:1030 問。10 次元に沿って分布し、Grounding / Action / State の 3 つの評価軸に集約
- Caption トラック:モデルが動作整合したステップ級記述を生成することを求め、LLM が出力と原子事実の整合度を判定して、一貫性、カバー率、反幻覚の 3 指標を産出
FineVLA-Policy:細粒度言語のポリシー上の利益を検証
視覚観察と動作ラベルを固定し、ペアになる言語(Raw-only / FG-only / Mixed)だけを変えて、言語監督の効果を厳密に分離します。
実験結果
モデルの理解能力
RoboFine-VLM は VQA トラックで 68.2% を取得し、最強の汎用ベースライン GPT-5.4(60.2%)を +8.0 ポイント上回りました。Caption hard 設定では 82.2% で、GPT-5.4(78.0%)を超えています。自動採点と人手の順位は高度に一致しました(Spearman 0.943)。
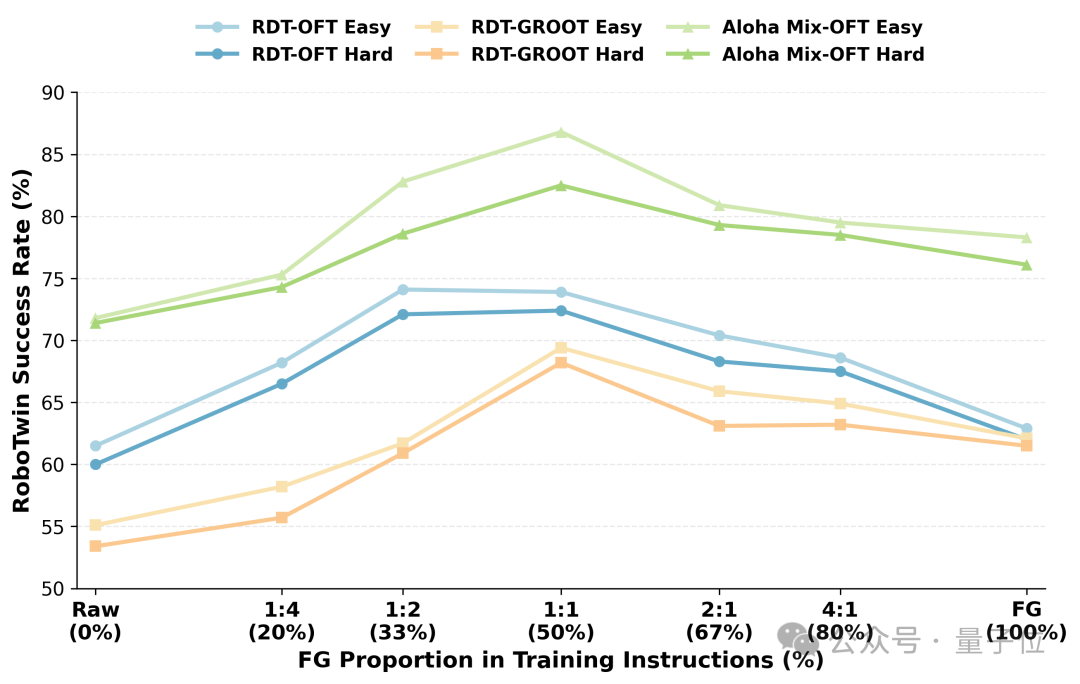
RoboTwin シミュレーション:逆 U 字カーブ
2 つの重要な発見:
- FG-only はすべての設定で Raw-only を上回る(利得 +1.4 から +8.1)。細粒度監督はタスク成功率を損ないません
- 成功率は逆 U 字の傾向を示し、ピークは FG:Raw = 1:2 から 1:1 の間にあります
最良設定は 86.8%/82.5% に達し、ベースライン比 +15.0/+11.1。Raw はモデルに「何をするか」を、FG はモデルに「どうやるか」を伝え、両者は互いに補完し合います。
実機双腕:制御可能要素が全面的に向上
CobotMagic 双腕プラットフォームでは「ペア評価」を用いました——同じ視覚シーンで言語の制御要素を 1 つだけ変える方法です。FG:Raw=1:1 は Avg(ID) で 62.7/100 に達しました(Raw-only 49.9、FG-only 54.4)。
具体的な制御要素での向上は、姿勢 +23、色 +18、接近方向 +18、回転方向 +10、実行アーム +4。大きな利得は目標級指令が指定していない要素に集中しています——これこそ FineVLA が最も価値を持つ点です。
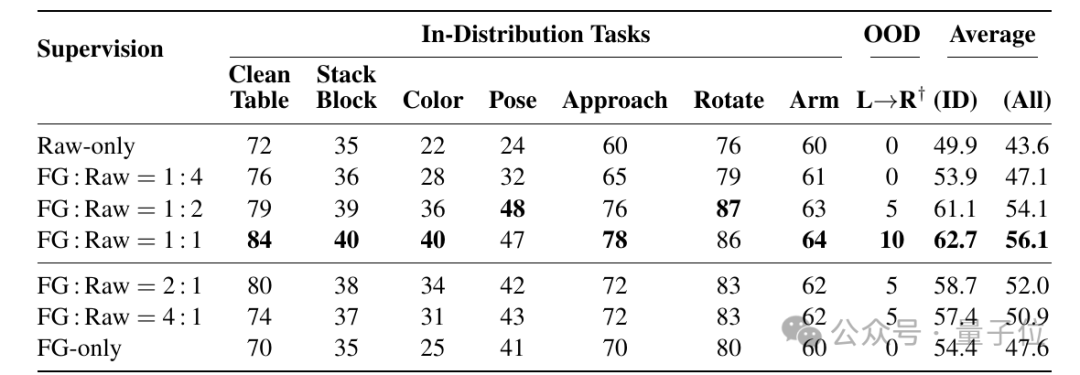
姿勢は 24 から 47 へ、色は 22 から 40 へ、接近方向は 60 から 78 へ向上。
使い方
オープンソースのリソースは揃っています:
- 論文:arxiv.org/abs/2605.27284
- プロジェクトページ:finevla.xlang.ai
- GitHub:github.com/xlang-ai/FineVLA
- 評価ベンチマーク:HuggingFace の
RoboFine-bench - 注釈モデル:HuggingFace の
RoboFine-VLM-397B-A17B
応用シーン
- ロボットポリシー研究チーム:FineVLA-Data の 47159 本の細粒度注釈をそのまま再利用するか、RoboFine-VLM で自社データの注釈を拡張
- VLA モデル評価:RoboFine-Bench は Grounding / Action / State の 3 軸の体系的評価を提供し、「細粒度理解」という長年の空白を埋めます
- 双腕 / ヒューマノイドロボットチーム:混合学習のレシピ(FG:Raw=1:1)は、姿勢や接近方向などの重要な制御要素を向上させることが検証済み
- VLM for Robotics:RoboFine-VLM はスケーラブルな注釈器として、より多くのラベルなしロボット動画を細粒度監督に変換できます
💡 ヒント:核心の結論は「データにより長い記述を足すこと」ではなく、細粒度言語は目標級指令を置き換えるのではなく強化すべきということです。最良の配合は FG:Raw ≈ 1:2 から 1:1 で、純粋な細粒度はむしろ混合学習に及びません——Raw が「何をするか」を、FG が「どうやるか」を担い、両者は欠かせません。
プロジェクトアドレス:github.com/xlang-ai/FineVLA
関連記事
PerfEvolve:AgentにベテランDBAのようにデータベースパラメータを調整させる
中国科学院ソフトウェア研究所がPerfEvolveフレームワークをオープンソース化。静的なパラメータ調整ドキュメントをAgentが実行可能な手続き的スキルへ変換し、PostgreSQL v16で最大58.9%の性能向上を実現。LLMの調整失敗に効く特効薬です。
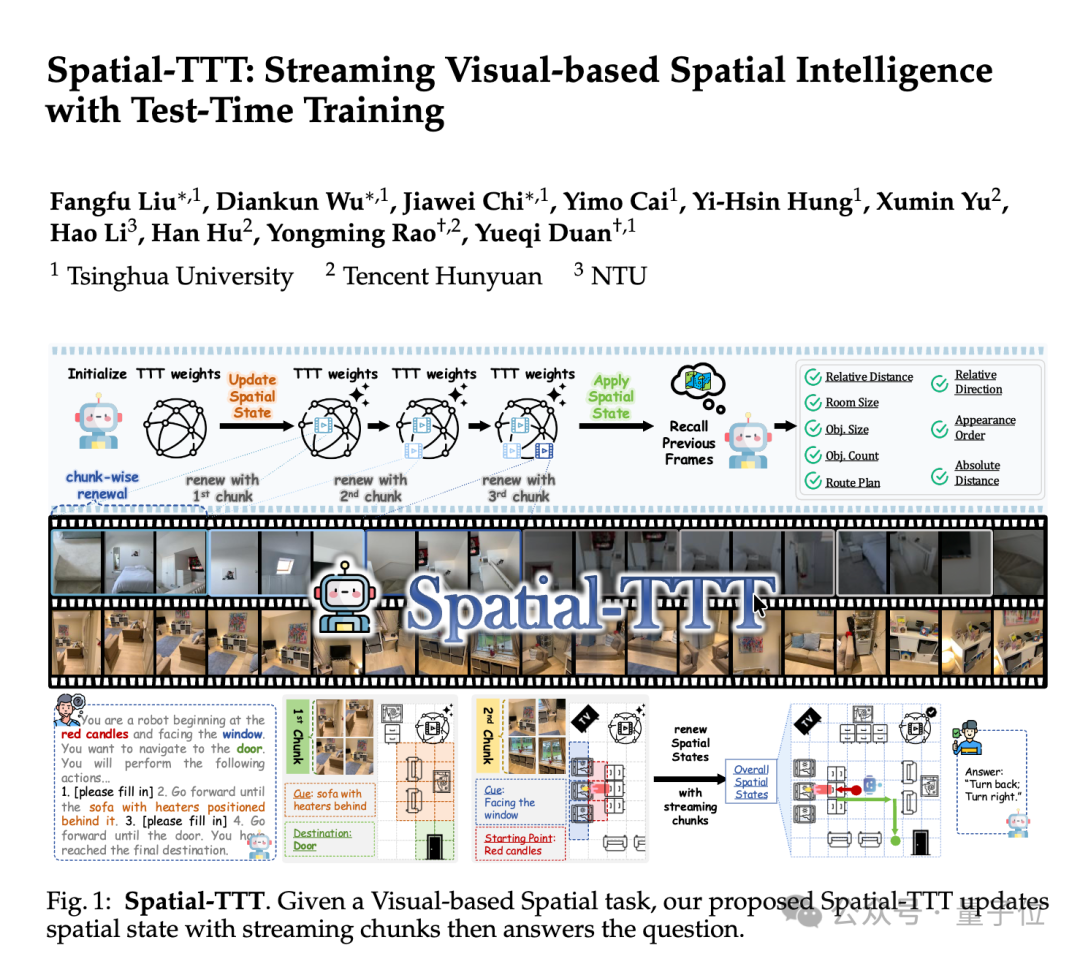
Spatial-TTT:2Bパラメータのオープンソース空間知能モデル
清華大学がオープンソース化したSpatial-TTTがECCV 2026に採択。わずか2Bパラメータで複数の空間知能ベンチマークにおいてGPT-5、Gemini-3-proを上回り、120分のストリーミング動画を処理し、観ながら空間記憶を更新できます。
TerminalWorld:初の実CLIワークフローAgentベンチマーク
8万件の人間のターミナル録画から鍛え上げられた1530タスクの評価セット。18類のワークフロー、1280個のコマンドツールをカバーし、Agentが実ターミナルシーンで「ランキング高得点、実投入で失敗」という持病を抱える問題に効く特効薬です。
若愚攬月01:世界初のAI防爆ロボット、実車に自分で給油する
若愚九天ロボットブレインに駆動される防爆ロボット攬月01は、ガソリンスタンドで24時間、キャップ開け・ノズル取り・注油・ノズル戻しの全工程を自律的にこなし、身体知能を高リスクシーンへ落とし込みました。
TRIAD:AIエージェントに拒否だけでなく危険な計画の修復までできるようにする
オープンソースのAgent安全フレームワークTRIADは、2値分類のガードレールを3路判断(継続/更新/拒否)に置き換え、プロンプトインジェクション攻撃下でもユーザーの本来タスクを守ります。
Volcano EngineのAgent Infra全面アップグレード:1+N+X体系、AgentKitとArkClaw企業版
Seedance 2.0の瞬間から企業級Agentインフラまで。Volcano Engineは1+N+X体系、AgentKit、ArkClaw企業版によって、Agentを個人ツールから組織のワークフローへ本当に移します。