
JoyAI-Echo:5分間の長尺動画生成をオープンソース化
JDがオープンソース化したAI長尺動画生成フレームワーク。最大5分のショットまたぎの音声付き動画を一度に生成し、部分的な修正にも対応します。ガチャのような盲目的な生成とはおさらばです。
JoyAI-Echo:5分間の長尺動画生成をオープンソース化
JDがオープンソース化したAI長尺動画生成フレームワーク。最大5分のショットまたぎの音声付き動画を一度に生成し、部分的な修正にも対応します。ガチャのような盲目的な生成とはおさらばです。
AI動画生成はずっと「ショート動画」という壁で止まっていました。市場のモデルの多くは20秒以内の断片しか生成できず、分単位に延びるとキャラクターがショットをまたいで別の顔になり、声がドリフトし、1つのショットを変えるだけで全部作り直しになるため、AI長尺動画はずっとdemo段階にとどまっていました。
JDが最近オープンソース化したJoyAI-Echoフレームワークが、このボトルネックの打破を目指しています。最大5分のショットまたぎの音声付き動画を一度に生成し、キャラクターの顔と話し声の声色が全編一貫することを保証し、自然言語による部分修正に対応します。コードと重みはどちらも公開済みです。
JoyAI-Echoとは
JoyAI-EchoはJDがオープンソース化した長尺音声付き動画生成フレームワークです。市場によくあるショート動画生成モデルとは異なり、「長時間の一貫性」という核心問題の解決に特化しています。同じキャラクターが5分間、十数回のショット切り替えの中でずっと同じ顔、同じ声を保つようにするのです。
現在、コードと重みファイルはどちらもGitHubで公開されており、無料でダウンロードして利用できます。
- GitHub: https://github.com/jd-opensource/JoyAI-Echo
- プロジェクトページ: https://echo-team-joy-future-academy-jd.github.io/Echo-LongVideo-Page/
コア機能
ショットをまたぐ音声・映像の二重の一貫性
従来のAI動画の最大の痛点は「顔が変わる」ことでした。JoyAI-Echoは「スロットペアリング」という音声・映像記憶の相互作用メカニズムで、各キャラクターの顔の特徴と声を紐付けます。新しいショットを生成するとき、システムは記憶ライブラリから対応キャラクターの視覚・音声マーカーを検索し、ショット間の一貫性を保証します。
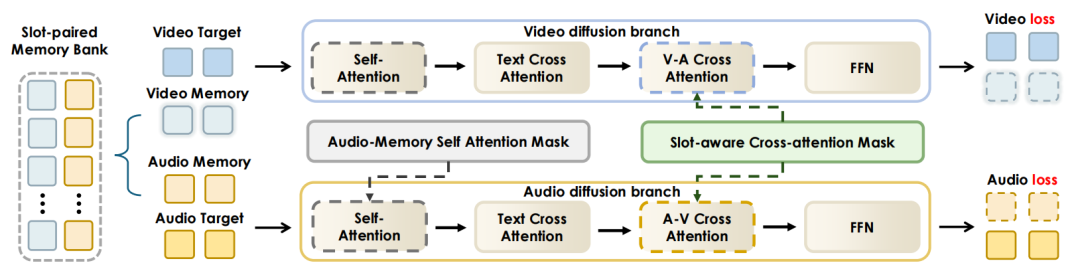
スロットペアリングによる視聴覚記憶相互作用メカニズム:各履歴イベントは整列した視覚と音声の記憶マーカーを含み、ペアリングされた視覚と音声の記憶スロット同士が一対一で相互作用し、イベントをまたいだ顔と声の混線を防ぎます。
ノンリニア編集と部分的な再生成
従来は1つのショットを変えるにも動画全体を作り直す必要がありました。JoyAI-EchoはDirector Agent(監督エージェント)を導入し、自然言語でAIに指示して部分的な修正を行えます。あるショットが気に入らない?「この追跡シーンの背景を雨に変えて」と直接伝えれば、システムがそのショットを自動で特定して再描画し、他のショットには影響しません。
Director Agentは長尺動画生成を計画、生成、レビューの3段階に分け、部分フィードバックを使ったノンリニアな修正に対応します。
高解像度リアルタイム超解像度
統合型シングルステップ超解像度アーキテクチャ(Unified One-Step SR)により、JoyAI-Echoはストリーミング遅延制約の下で2段階のリアルタイム超解像度に対応し、最高で1472x2560解像度の高精細動画をそのまま出力できます。拡散フローの順伝播ステップ1回で720pを2K画質へ引き上げます。
技術的ハイライト
100万級のアイデンティティ中心型コーパス
従来のAI動画学習は単一ショートの品質を最適化するフラットなデータセットに依存しており、モデルは短時間の画面の描き方しか学んだことがなく、同じキャラクターの異なる時空間での視覚的連続性を理解していませんでした。JoyAI-Echoは全新のアイデンティティ中心型動画コーパス(Identity-Centric Video Corpus)を構築し、映画、ドラマ、長尺動画から100万以上のキャラクターアイデンティティの原型を抽出して、生成コンテンツの一貫性を保証します。
段階的に進化する記憶ライブラリ
エンドツーエンド生成を捨て、段階的に進化する記憶ライブラリ(Evolving Memory Bank)に基づく反復的な絵コンテ合成メカニズムを採用しました。生成フェーズでは、対象の動画と音声マーカーを2つの拡散ブランチが処理し、記憶マーカーは条件コンテキストとしてのみ使われ、損失計算には参加しません。
ポストトレーニング体系
- リップシンク:長いコンテキストの損失リダイレクトと勾配拡大。2段階で6倍まで拡大し、台詞から口の動きへの制御力を強化
- 画質向上:480pから720pへの段階的解像度スケジューリングで、単一ショットの質感と複数ショットの一貫性を両立
- RLHFアライメント:OmniNFTフレームワークで「音声と映像の報酬不一致」などのボトルネックを解決
- 推論高速化:DMD蒸留で多ステップ生成を8ステップに圧縮し、記憶入力の劣化シミュレーションを加えてロバスト性を強化
実際の効果
100の脚本ストーリー、3000の順序付きショットを含む超長尺生成ベンチマーク評価セットで、JoyAI-Echoの台詞正解率は0.8646に達し、視聴覚一貫性の各指標はいずれも上位に位置しています。
適用シーン
- 映像のプリビジュアライゼーション:絵コンテ動画を素早く生成し、ナラティブのテンポと視覚スタイルを検証
- デジタルヒューマンコンテンツ制作:キャラクターの一貫性を長時間保つ対話動画
- ストーリー型ショート動画:複数ショットの完全なナラティブコンテンツを一度に生成
- 学術研究:オープンソースのコードと重みで二次開発やアルゴリズム改良が容易
ヒント: このプロジェクトにはある程度のGPU計算資源が必要です。2K解像度の動画を生成する場合は、ビデオメモリ24GB以上のグラフィックカードの使用を推奨します。
関連記事
Kimi Work Beta:コードを書くAgentから、仕事をこなすAgentへ
Moonshot AIがKimi Work Betaをリリース。ナレッジワーカー向けの汎用ローカルAgentで、300の子Agent並行協働、13時間の長時間タスク、ブラウザ操作、Skillインストールに対応します。
OpenSquilla Meta Skill:一連のワークフローを1つのSkillに収める
OpenSquillaがMeta Skill機能をリリース。1つのSkillに複数の子Skillを内蔵し、長時間のワークフローを端から端までつなげられるうえ、トークンコストも60-80%節約できます。
碼上飛:ひと言から、実際に動く完全なビジネスへ
碼上飛は一人会社の3つの核心工程をクローズドループにまとめます。ひと言で管理画面つきの完全なAppを生成し、AI経営アシスタントがポスターとコピーを自動生成し、7x24のAIカスタマーサポートをWeChatにワンクリックで接続します。
AIフルオート動画編集:3点セットで1日100本の動画更新
HyperFrames + Remotion + Gitの3点セットでAIフルオート動画編集を実現。HTMLからReactコンポーネントまで、完全なインストールコマンドとハマりどころの記録つきです。
Claude Code /workflows 実戦ガイド
Claude Code /workflows機能の使用シーンと実践テクニックを詳解。マルチAgentの並列処理でコードベースの清掃や難題の調査を行う方法を解説します。
オープンソースのSkillでCleanMyMacを置き換える
オープンソースのPCクリーンアップSkill。AgentがMac/Windowsを読み取り専用で分析し、ビジュアル化されたHTMLレポートを生成して段階的にクリーンアップします。実測で120Gの空きを確保しました。