
RynnWorld-Teleop:DAMO アカデミーがオープンソース化したデジタルテレオペ。実機なしでロボットの学習データを収集
Alibaba DAMO アカデミーがデジタルテレオペレーション方式「RynnWorld-Teleop」をオープンソース化。ジェスチャーでワールドモデルを駆動してロボットの視覚デモを生成し、関節レベルのラベル付き学習データを自動で出力します。本記事では中核となる発想、公開内容、適用シナリオを解説します。
RynnWorld-Teleop:DAMO アカデミーがオープンソース化したデジタルテレオペ。実機なしでロボットの学習データを収集
Alibaba DAMO アカデミーがデジタルテレオペレーション方式「RynnWorld-Teleop」をオープンソース化。ジェスチャーでワールドモデルを駆動してロボットの視覚デモを生成し、関節レベルのラベル付き学習データを自動で出力します。本記事では中核となる発想、公開内容、適用シナリオを解説します。
7 月 17 日、Alibaba DAMO アカデミー(達摩院)は RynnWorld-Teleop——「デジタルテレオペレーション(Digital Teleoperation)」によるエンボディッドデータ収集ソリューション——をオープンソース化しました。論文は arXiv に公開済み(2607.06558)で、コードは github.com/alibaba-damo-academy にあります。その核心的なセールスポイントを一言で言えば、実機がなくても、そのまま学習に使えるロボットデータを収集できるということです。エンボディッド AI(身体性を持つ AI)を手がけ、実ロボットによるデータ収集のコストに足を踏まれているチームにとって、真剣に検討する価値のあるソリューションです。本記事では、その中核となる発想、公開内容、DAMO アカデミーのエンボディッドエコシステムにおける位置づけ、そして適用シナリオを解説します。
RynnWorld-Teleop とは
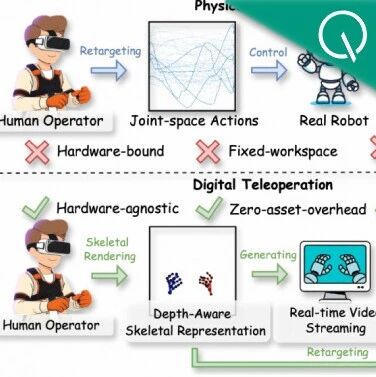
エンボディッド AI の最大のボトルネックの 1 つはデータです。実ロボットでの収集は遅く、高く、危険で、しかもハードウェアに強く結びついています。ロボットを 1 台変えるだけで、収集し直さなければなりません。RynnWorld-Teleop が示した解法は「デジタルテレオペレーション」です。核心は、**ワールドモデル(World Model)**を「仮想ロボット」として使い、データ収集を実ハードウェアから完全に切り離すことにあります。
従来のテレオペレーションとデジタルテレオペレーションの比較:
| 視点 | 従来のテレオペレーション | RynnWorld-Teleop |
|---|---|---|
| ハードウェア依存 | 実ロボットが必要 | 実機不要 |
| 視覚デモ | 実カメラで撮影 | ワールドモデルがリアルタイム生成 |
| 動作ラベル | 手作業または追加のアノテーション | 関節レベルのラベルを自動生成 |
| 拡張性 | ハードウェア台数に制限 | 無限に合成可能 |
| クロスプラットフォーム移行 | 特定のロボット機種に強く結合 | ハードウェア非依存 |
核心となる発想:ジェスチャー駆動のワールドモデル
ソリューション全体のデータフローは 3 ステップに分解できます:
1. オペレーターがジェスチャーを行う(人間側の入力)
        ↓
2. ワールドモデル(RynnWorld)がジェスチャーを「デジタルロボット」の動作に変換し、
   対応する視覚デモ動画をリアルタイムに生成する
        ↓
3. 関節レベルの動作ラベルを同時に出力する(そのまま学習に使える action label)
ここでの重要な技術ポイントは**動作条件付けされたワールドモデル(Action-Conditioned World Model)**です。このモデルは単に動画を生成するのではなく、「動作が与えられた条件のもとで」次に見えるはずの画面を生成します。これにより、生成された視覚デモと動作ラベルは最初から整合しており、下流のポリシーモデルの学習にそのまま投入できます。
本当に解決している問題
デジタルテレオペレーションの価値は「もう 1 つのデータ収集手法」ではなく、エンボディッドデータのコスト構造を変えることにあります:
- ハードウェアからの解放:実ロボットを購入・保守しなくてもデータを収集できる
- リスクゼロ:衝突や人身事故といった物理的リスクが存在しない
- 無限に拡張可能:合成できるデータ量は計算資源(GPU など)の制約を受けるだけで、ハードウェア台数の制約を受けない
- 自動アノテーション:関節レベルの動作ラベルはプロセスの副産物であり、大量の人手によるアノテーションコストを省ける
- ハードウェア横断:理論上は 1 セットのデータで複数のロボット形態を学習できる
初期段階のエンボディッドチーム、アカデミックな研究室、ポリシーモデルを素早く検証したい研究者にとって、「データ収集」という足かせを外せるに等しいと言えます。
DAMO アカデミーのエンボディッドエコシステムにおける位置づけ
DAMO アカデミーのエンボディッド分野の取り組みは「三本柱」で、、RynnWorld-Teleop はその 1 つです:
- RynnBrain:エンボディッドブレーンの基盤モデル。理解と意思決定を担う
- RynnWorld-Teleop:今回オープンソース化されたデジタルテレオペレーション。データ収集を担う
- RynnRCP(Robot Context Protocol):ロボットコンテキストプロトコル。コンテキストとツール呼び出しの標準化を担う
3 点セットを組み合わせると、「データ収集 → ブレーンの学習 → インターフェースの標準化」という完全なパイプラインをカバーします。RynnWorld-Teleop の中での位置づけはデータ生成側であり、エンボディッドプロセス全体の最上流にあたる環節です。
実際の使い勝手と適用シナリオ
向いている人
- エンボディッド AI の研究チーム:大量の学習データが必要だが、実機を複数台買えない/買いたくない
- ポリシーモデルの学習者:action label 付きの(視覚, 動作)ペアデータが必要
- クロスハードウェア移行の研究:同じデータセットが異なるロボット形態でどう機能するかを検証したい
- 学術実験の再現:オープンソース + 実機不要でハードルが極めて低く、論文の再現や教育に適する
検討が必要な点
- Sim-to-Real Gap(シミュレーションと現実の隔たり):ワールドモデルが生成する映像がどれほどリアルでも、現実の物理世界とは差があります。下流のポリシーを実機にデプロイする前には、少量の実データでファインチューニングが必要になる可能性がまだ残ります。
- ワールドモデル自体のバイアス:ワールドモデルの生成品質がデータ品質を直接決めるため、「生成映像が分布からずれる」リスクがあり、対応する品質検査プロセスが必要です。
- DAMO アカデミーエコシステムへの依存:RynnBrain、RynnRCP と組み合わせたときに最も効果を発揮します。単独で導入する場合は互換性のコストを見積もる必要があります。
使い始め方
# 1. コードを取得する
git clone https://github.com/alibaba-damo-academy/<rynnworld-teleop 仓库名>

# 2. 論文を読んでアーキテクチャを理解する
# arXiv: https://arxiv.org/abs/2607.06558
# 論文タイトル:RynnWorld-Teleop: An Action-Conditioned World Model
#          for Digital Teleoperation

# 3. リポジトリの README に従ってワールドモデルの推論環境を整える
# 注意:リアルタイム動画生成には GPU の計算能力が必要で、1 台構成の推論設定は公式の説明を参照
💡 ヒント:リポジトリの具体的なパスは、github.com/alibaba-damo-academy で実際に公開されているものを基準にしてください。論文の実装詳細(ワールドモデルの規模、動作条件付けの方式、学習レシピ)は、再現に着手する前に一通り目を通すことをおすすめします。
利用前に注意すべきこと
- 実データの代替ではなく補完:実データ収集を完全に省くことには sim-to-real のリスクがまだ残ります。「主なデータソース + 少量の実データによるファインチューニング」という組み合わせの構成をおすすめします。
- ワールドモデルの品質上限に注目:生成される視覚デモの品質が、下流のポリシーモデルの天井を決めます。タスクが繊細な操作(柔軟物体、精密組立など)を含むなら、生成サンプルの分布のずれを自測してから規模を決めてください。
- エコシステムへの結合度:RynnBrain / RynnRCP と深く組み合わせるほど恩恵は大きくなります。完全に単独で使う場合は導入コストを見積もってください。
参考ソース
- 論文:arXiv 2607.06558 — RynnWorld-Teleop: An Action-Conditioned World Model for Digital Teleoperation
- オープンソースリポジトリ:github.com/alibaba-damo-academy
- DAMO アカデミー公式発表(2026-07-17)