
動画を図解ブログへ:AgentとマルチモーダルモデルでKarpathyのワークフローを作り直す
Doubao Seed 2.0 LiteのオールモーダルモデルとAgentを組み合わせ、動画を自動で図解ブログ化する4ステップワークフロー。従来のASR+LLMパイプラインで画面情報が失われる問題を解決します。
動画を図解ブログへ:AgentとマルチモーダルモデルでKarpathyのワークフローを作り直す
Doubao Seed 2.0 LiteのオールモーダルモデルとAgentを組み合わせ、動画を自動で図解ブログ化する4ステップワークフロー。従来のASR+LLMパイプラインで画面情報が失われる問題を解決します。
2年前、Andrej Karpathyは自身の2時間13分に及ぶtokenizerの解説動画を、自動的に1本のブログ記事へ変換したいと考えていました。当時の手法(Whisperによる文字起こし + LLMでの書き直し + 手動での画像選定)は、各段階で情報が失われるため、結果が不安定でした。今では、オールモーダル理解モデルDoubao-Seed-2.0-liteとAgentワークフローのおかげで、この作業はついにエンジニアリング的に完遂できるようになりました。
この記事では、「動画から図解ブログへの変換」を4ステップの実践フローで最後まで丁寧に解説していきます。
問題の本質
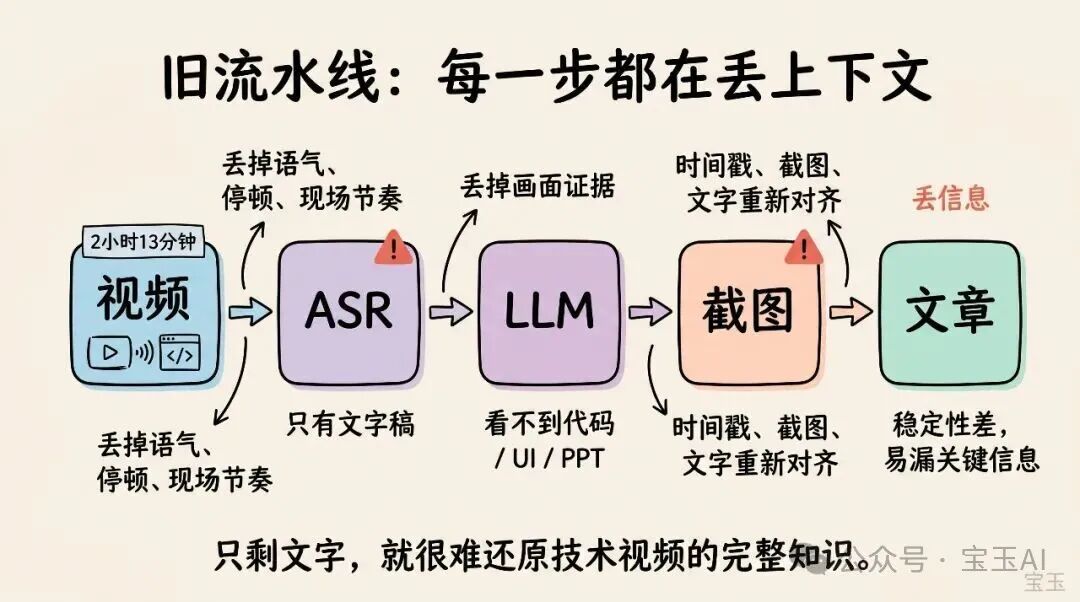
従来のASR + LLMパイプラインには根本的な欠陥があります。文字起こしの段階で大量の情報が失われてしまうのです。
- ASRは「話者が何を言ったか」だけを残し、トーン、間(ま)、背景音を失ってしまう
- LLMは文字起こし原稿しか読めず、画面上のコード、図表、PPTが見えない
- 配図は別の独立タスクで、手動でフレームを選ぶか、追加の視覚モデルを導入するしかない
技術動画の重要な情報の多くは音声ではなく画面の中にあります。スライド上のアーキテクチャ図、ターミナルで実行されるコマンド、IDEで修正されたコード行、GitHub PRのステータス変化などです。
オールモーダルモデルの価値は、「音声」「画面」「画面上のテキスト」「コンテキストテキスト」を同じ理解空間に置き、次の問いに同時に答えられる点にあります。話者は何を語ったか? 画面には何が映ったか? その両者が合わさって伝える技術的な意味は何か?
開始前の準備
- 必要なツール:Agentフレームワーク(Claude Code、Traeなど)、Doubao-Seed-2.0-lite API、ffmpeg
- 必要なアカウント:Doubao大規模モデルのAPI Key(Volcano Engineプラットフォームで登録して取得)
- 技術要件:基本的なコマンドライン操作能力、TypeScript/Pythonの基礎
- オープンソースSkill:
doubao-multimodal(https://github.com/JimLiu/doubao-multimodal-skill)
doubao-multimodalはBun + TypeScriptで書かれたCLIツールで、Doubao-Seedのマルチモーダルchat completionエンドポイントをラップしています。ローカルファイルやリモートURLを受け付け、ダウンロード、動画の分割、並行呼び出し、結果のマージといったエンジニアリングの細部を自動処理します。
Skill内蔵のアトミックなTask
| Task | 用途 | 画面を保持するか |
|---|---|---|
asr | 音声のみの文字起こし | いいえ |
asr-timestamp | 1文字ごとにタイムスタンプ付き | いいえ |
multispeaker-asr | 話者分離文字起こし | いいえ |
diarize | 話者 + 時間帯のログ | いいえ |
caption | 音声・動画全体の説明レポート | はい |
video-timeline | 動画イベントのタイムラインJSONを出力 | はい |
keyframe-extract | 技術ブログ用のキーフレーム画像を選定 | はい |
understand | カスタムpromptによる汎用音声・動画理解 | はい |
これらのtaskはアトミックなので、自由に組み合わせられます。ブログ執筆に限らず、promptと出力フォーマットを入れ替えれば、同じSkillを文字起こしレポート、競合分析、授業記録などのシーンにも活用できます。
4ステップフローの詳細解説
ステップ1:長い動画を分割する。ただしプレーンテキストへ「潰さない」
モデルの1回の入力には、長さとサイズの制限があります。Skillはまず動画をチェックし、20分または50MBを超えていればffmpegで自動分割します。解像度が720pより高ければ720pにダウンサンプリングします。分割後は並行でモデルを呼び出し、時間順に結果をマージします。
重要なポイント:分割は文字起こしではありません。各セグメントには動画・画面・音声の情報がそのまま残り、モデルはスライド、コード、UIを見て、話者の声を聞くことができます。
# Skill 自动执行的切片逻辑(无需手动操作)
ffmpeg -i input.mp4 -c copy -map 0 -segment_time 600 -f segment output%03d.mp4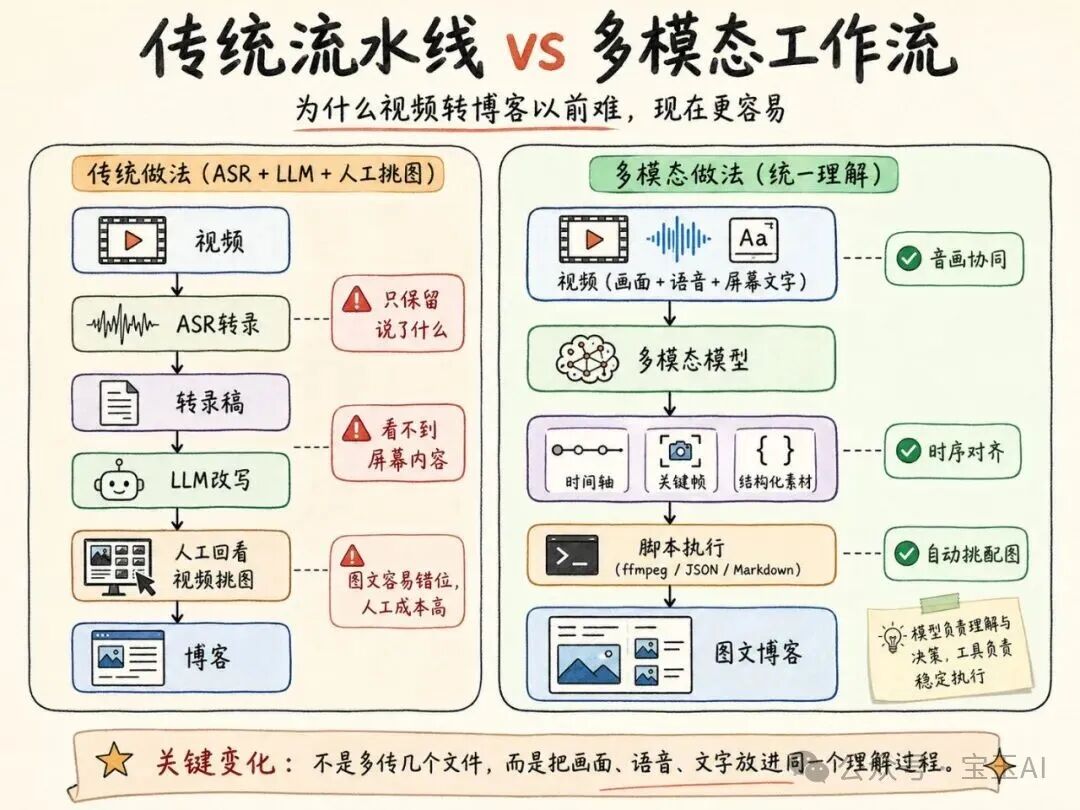
ステップ2:構造化された「記事の素材」を生成する。いきなり完成原稿を書かせない
長い動画で、モデルに一発で完全な記事を出力させるのはおすすめしません。より安定するのは、まず構造化素材を出力させ、それをもとに執筆する方法です。
Agentに与えるプロンプト:
この技術講演の動画をもとに、中国語の技術ブログを執筆するための構造化素材を出力してください。
音声だけでまとめず、画面・音声・画面上のテキストをすべて活用してください。

少なくとも以下を含めてください:
- 動画のテーマと一文での要約
- 時系列に沿って分割した章立て
- 各章の解説のポイント
- 画面に現れた重要なエビデンス(コード、アーキテクチャ図、コマンド、UIの状態)
- 原文のまま残すべき英語の専門用語、コマンド、ファイル名、API名
- 不確実な点、人の確認が必要な点
このステップでは、モデルにまず「著者」ではなく「リサーチアシスタント」として働いてもらい、事実の境界線を整理させます。
ヒント:構造化素材が手に入ったら、Agentは執筆フェーズに進み、素材をブログ初稿に書き直します。こうして書かれた記事は一発で仕上げるより安定し、チェックもしやすくなります。
ステップ3:記事から動画を逆引きし、キーフレームを自動選定する
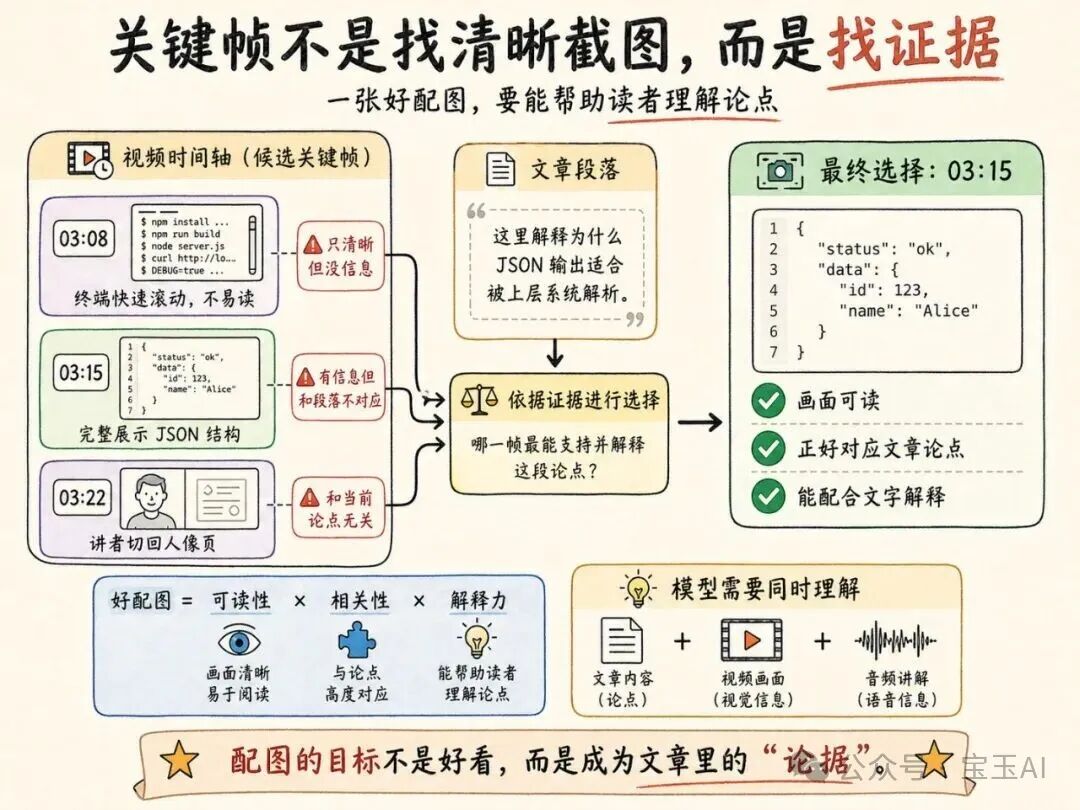
記事の初稿ができたら、Agentに「記事の内容」と「元動画」をまとめてマルチモーダルモデルへ渡し、ブログの配図を選ばせます。
出力される構造化JSON:
{
  "keyframes": [
    {
      "timestamp": "03:15",
      "timestamp_sec": 195.0,
      "description": "VS Code 中出现完整命令行输出,展示 JSON 结构",
      "suggested_caption": "图:结构化输出示例",
      "reason": "对应文章中关于 JSON 可被上层系统解析的论点"
    }
  ]
}最も重要なフィールドはreasonです。モデルは次の3つの問いに同時に答えなければなりません:
- 記事のこの部分は何を述べているか?
- 動画のこの瞬間、画面には何が映っているか?
- この図は読者の論点理解の助けになるか?
まさにこれが、従来のASR + LLMパイプラインにはできない領域です。
ステップ4:ffmpegでスクリーンショットを撮り、画像をMarkdownへ差し込む
キーフレームJSONを取得したら、(モデルではなく)決定論的なツールでスクリーンショットと挿入を行います:
mkdir -p imgs

i=0
jq -r '
  (.segments[0].text | fromjson | .keyframes[]) |
  [.timestamp_sec, .suggested_caption] | @tsv
' out/keyframe-extract.json |
while IFS=$'\t' read -r ts caption; do
  i=$((i + 1))
  file=$(printf "%02d.jpg" "$i")

  ffmpeg -hide_banner -loglevel error \
    -ss "$ts" -i talk.mp4 \
    -frames:v 1 -q:v 2 "imgs/$file"

  printf "%s[%s](imgs/%s)\n\n" "!" "$caption" "$file" >> frames.md
done注意:動画が複数セグメントに分割されていた場合、モデルが返す
timestamp_secはセグメント内のローカルタイムスタンプの可能性があります。Skillは結果をマージする際にsegment.start_secを加算し、元動画のグローバルタイムスタンプへ統一して変換する必要があります。
検証結果
短いAgentへの指示文1本で、フロー全体を完走できます:
/doubao-multimodal <~/downloads/xxx.mp4> という動画をもとに、内容の充実した図解つきの
技術ブログを書いてください。out の下に新しいディレクトリを作り、markdown と imgs をそこへ保存してください。
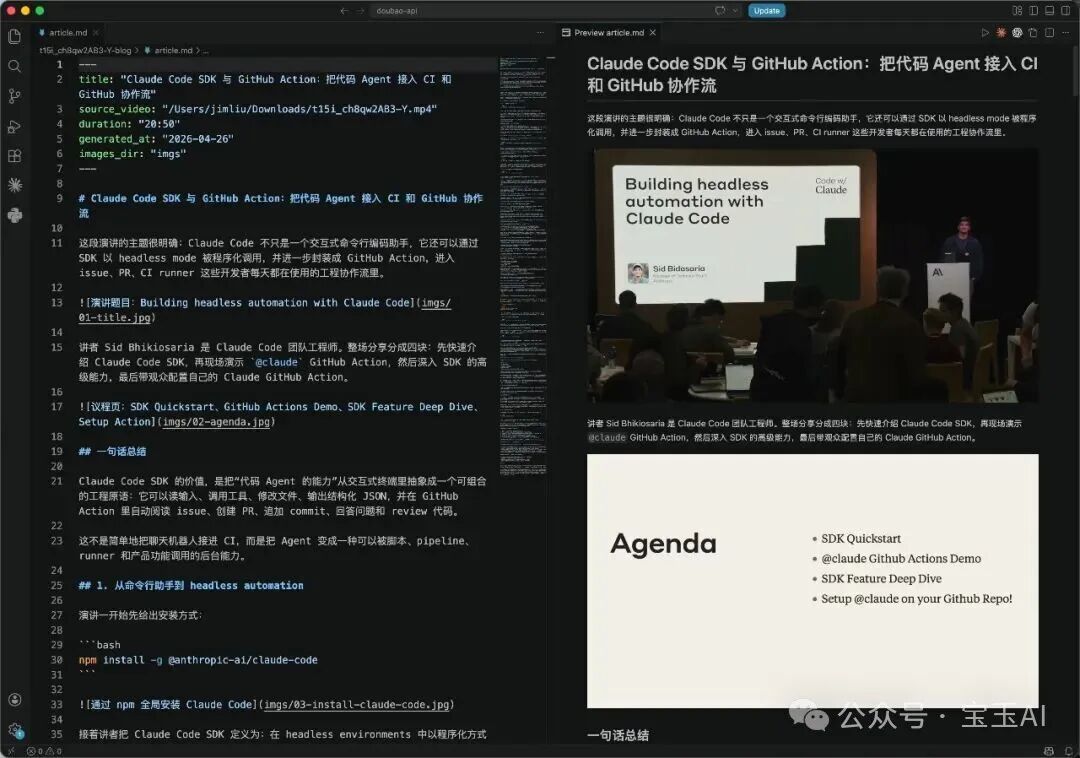
最終的に生成される記事には、構造化された本文、自動選定された動画キーフレームのスクリーンショット、対応するタイムスタンプの引用が含まれます。
よくある質問
- 長い動画が制限を超えたらどうする? Skillが自動で分割し並行処理するため、任意の長さの動画に対応します。
- タイムスタンプが不正確だったら? モデルは「どのあたりの瞬間がスクリーンショットに向いているか」を特定できます。画面の明瞭さに厳しい要求がある場合は、
timestamp_secの前後で候補フレームを複数枚取り、二次スクリーニングするとよいでしょう。 - 人間による校正は必要? 必要です。モデルは動画の理解、構成の整理、画像選びを手伝ってくれますが、具体的なAPI、バージョン、コマンド、事実判断に関わる部分は、公開前に人の目を通すのがベストです。
- このフローはリアルタイム処理に向いている? 向いていません。これは非同期のディープ理解ソリューションで、「録画後の処理」シーンに適しています。リアルタイムシーンには別のシステム設計が必要です。
応用シーン
このパターンは動画からブログへの変換に限らず、次のような用途にも転用できます:
- 競合のライブ配信トラッキング:GUI Agentによる定期収集 + マルチモーダル理解 + ダッシュボード生成
- オンライン授業レポート:学生のパフォーマンス分析。正答率だけでなく、集中度、流暢さ、感情状態まで
- ゲームの試合後レビュー:録画 + チームメイトの音声 + イベントタイムラインをまとめて分析
関連記事
OpenClaw必須のセキュリティプラグイン:Skill Vetter使い方ガイド
OpenClawのSkillsにはポイズニングリスクがあります。Skill Vetterなら、インストール前にプラグインの安全性を審査し、悪意あるコードの脅威を防げます
実践チュートリアル: 一言で AI マンガ動画を生成 (オープンソースプロジェクト)
オープンソースの AI マンガ動画プラットフォームの使い方を、台本生成・キャラクターの固定からコマ割り作成までステップバイステップで解説し、高品質なマンガをワンストップで仕上げる方法を紹介します。
実践チュートリアル: 指したところだけ直せる! Hyper3D Edit で 3D モデルを部分修正
Hyper3D Edit 機能の使い方をステップバイステップで解説。自然言語と範囲選択操作によって 3D モデルを正確に部分修正し、元のディテールをそのまま保てます。