ツール詳細
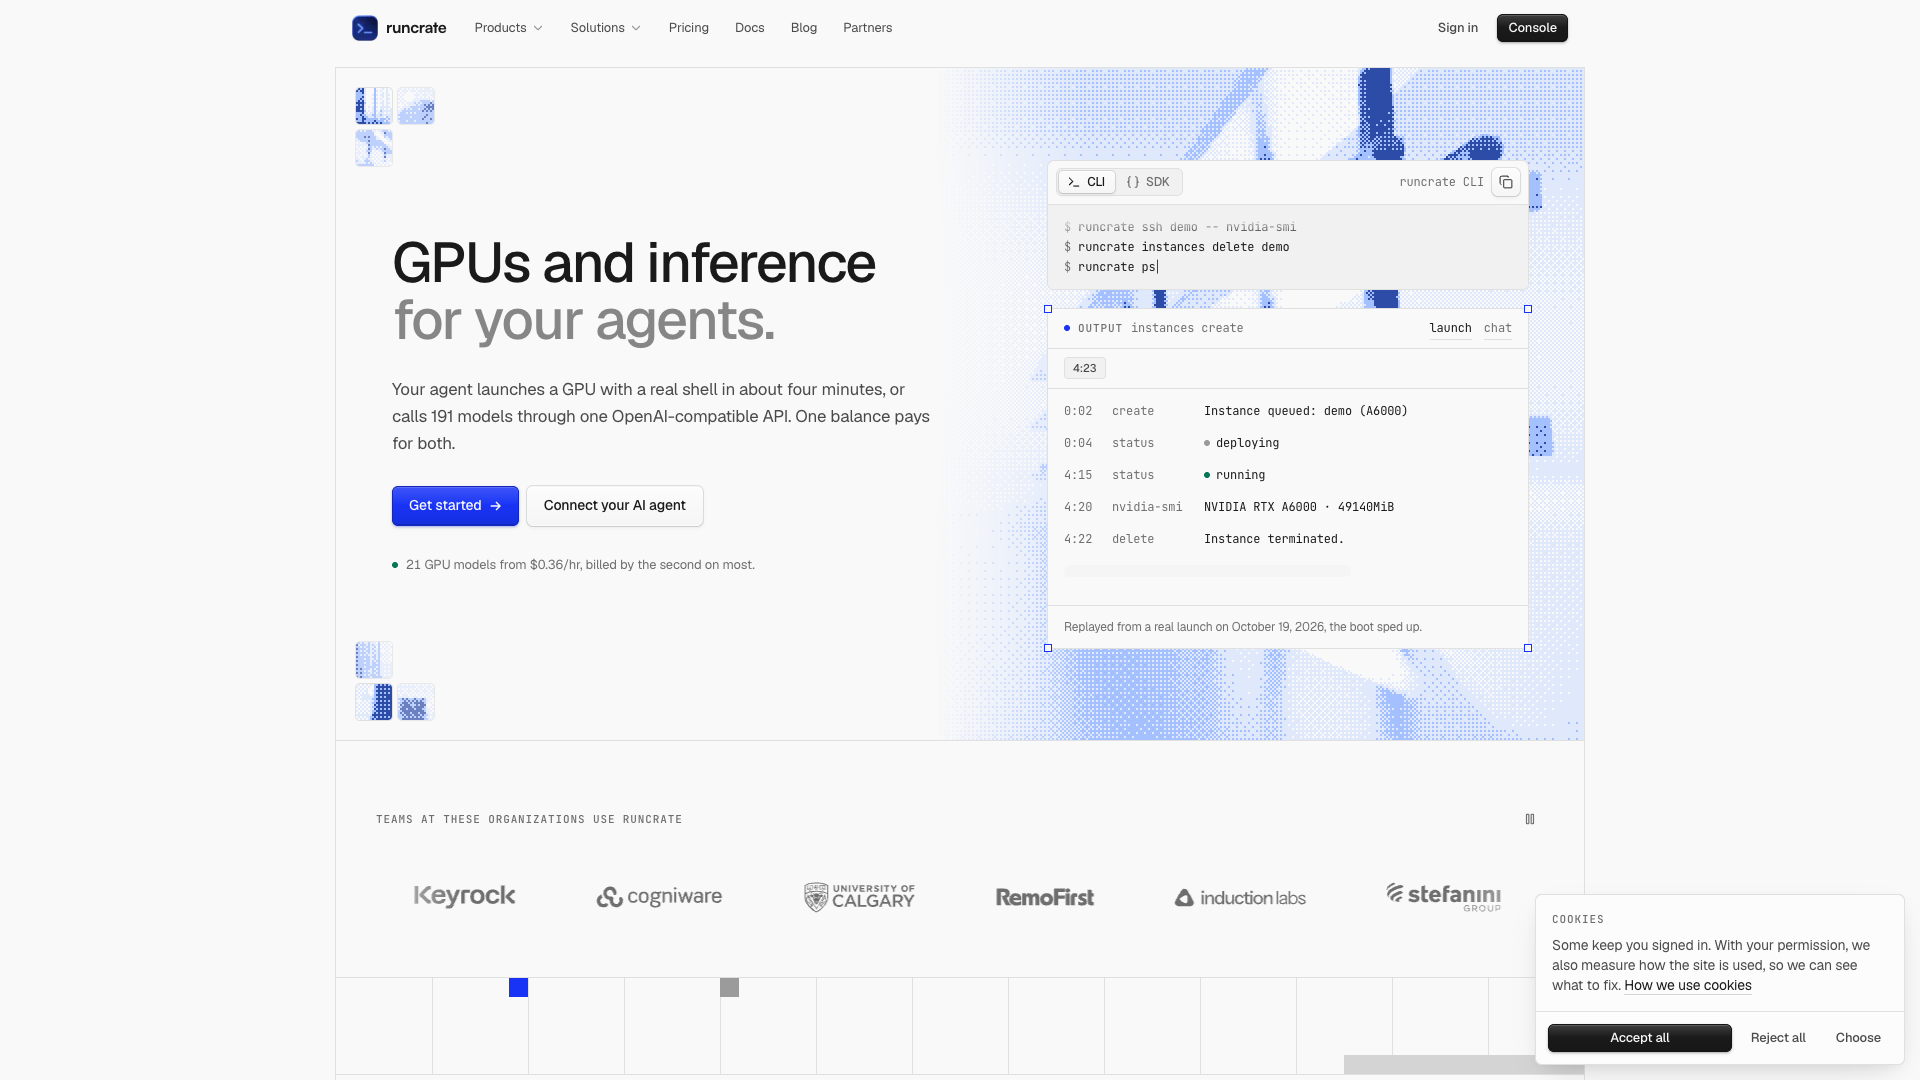
Runcrate は Aeonmind LLC が提供する AI クラウドプラットフォームで、OpenAI 互換の推論 API とオンデマンド GPU を単一のプリペイド残高にまとめています。API は実測で 191 モデルを返し、20 種の GPU の多くは秒単位課金です。制御プレーンは自社で構築しつつ、計算資源はパートナーのデータセンターから供給されており、本質は集約とオーケストレーションのレイヤーです。
主な機能
- OpenAI 互換推論:
base_urlを変えるだけで移行でき、Anthropic Messages エンドポイントも用意 - オンデマンド GPU:20 種の GPU を用意し、多くは秒単位課金で起動中は無料、root シェルと SSH、Jupyter、VS Code を利用可能
- MCP ネイティブ:OAuth の動的登録でキー不要、エージェントが自分でマシンを起動し SSH コマンドを実行できる
- Crates イメージ:Devbox、Finetune、Inference の各イメージをプリインストール済みで、Inference には vLLM または SGLang が入っている
- 予約クラスタ:B200、GB200、GB300、MI300X が在庫切れのときは複数ノードのシール入札に切り替え
- コストガードレール:Jobs には最長実行時間の指定が必須(1 分〜24 時間)で、アイドル停止と月次予算を併用
向いている用途 個人開発者や小規模チーム、コーディングエージェントで学習スクリプトを書いて実行するエンジニア、ファインチューニングや短期実験を行う研究者、画像・動画・音声を単一のエンドポイントに集めたいマルチモーダルチーム。エンタープライズ SLA や固定見積もりが必要な調達には向きません。
独自の強み RunPod や Vast.ai との違いは単体 GPU の最安値ではなく、単一の残高でトークンと GPU の両方を買えること、そしてエージェントがキーなしで接続できることです。秒単位課金や起動レイテンシのパーセンタイル公開といった率直さも珍しい点です。代償は明白で、供給は集約に依存し、同一モデルでも価格差が数倍に達し、表示価格は在庫を意味しません。
編集部の評価 能力は本物で、価格の示し方も十分に率直なので四つ星です。減点は信頼性にあります。規約は可用性を保証しないと明記し、返金は「at our discretion」、第三者による評価はほぼゼロ(G2、Capterra、Trustpilot に項目なし)で、5 人のチームが 191 モデル・20 種の GPU というカタログを支えています。コストに敏感で、自分で上限とチェックポイントを設定できるチームに向いています。
料金
フリーミアム$0(オープンソースモデル 5 個分の無料枠。GitHub アカウントが 30 日以上必要)無料枠は恒久的な無料プランではありません。GitHub アカウントが 30 日以上必要で、セッション単位と毎週(月曜リセット)の二重上限があり、超過分は共有キャパシティの半額で課金されます。サイト内に招待コードや待機列はありません。公式にはオープンソースモデル 5 個を無料で呼び出せますが、GitHub アカウントが 30 日以上必要です。枠はセッション単位と毎週(月曜リセット)の二重上限があり、超過分は共有キャパシティの半額で課金されます
191 モデルが実測で呼び出し可能で、課金単位は 7 種類(100万トークン単位、画像単位、秒単位、1,000 文字単位など)。OpenAI と Anthropic の SDK に対応しています
在庫のある GPU は 20 種で、V100 32GB の $0.36 から B300 の $9.74 まで。多くは秒単位課金で起動中は課金されず、削除後は約 30 秒の解体バッファがあります
B200、GB200、GB300、MI300X がオンデマンドで在庫切れのときは複数ノードのシール入札に切り替わり、提示額は並べて表示され、人手でマッチングされます
10〜10,000 GB の永続ボリュームを /workspace にマウントし、週単位で前払い。早期削除時は未使用分の日数が返金されます
補足情報
料金は /pricing と /inference/pricing の HTML 原文に基づきます。GPU 価格は上流の供給状況で変動し(H100 では $3.25、$3.38、$3.55、$3.69 といった複数の水準が確認されており、本記事では $3.55 を採用)、20 種は現在在庫のある型番を指します。機械可読なフィードは全 24 件で、ほかに 4 件は価格のみで在庫がありません。規約はいまも時間単位課金と記しており、ページの大半が秒単位であることと矛盾します。モデル数について運営は 200+ と 223 という数字も示していますが、本文は再現可能な 191 を採用しています。無料枠は /inference/free でのみ開示され、料金ページには一切触れられていません。これは集約レイヤーであり、規約にはインスタンスとモデルがパートナーのインフラ上で動作する場合があると明記されているため、同一型番でも価格差が数倍に及び、価格の逆転も起こります。決済は Stripe 直結で、ほかに USDC(≥$100)と銀行振込(≥$2,500)に対応し、返金は規約上 at our discretion です。
よくある質問
ユーザーレビュー
ユーザーレビュー
レビューはまだありません
このツールのレビューはまだありません