
Sakana Fugu:自らは答えず、他のモデルに指示して仕事をさせるオーケストレーター
Sakana AI がオーケストレーターモデルの Fugu シリーズをリリース。GPT、Claude、Gemini の賢いスケジューリングでタスクを完了し、性能は Fable 5 と Mythos Preview に迫ります。
Sakana Fugu:自らは答えず、他のモデルに指示して仕事をさせるオーケストレーター
Sakana AI がオーケストレーターモデルの Fugu シリーズをリリース。GPT、Claude、Gemini の賢いスケジューリングでタスクを完了し、性能は Fable 5 と Mythos Preview に迫ります。
これまで私たちは「どのモデルが最強か」と問うことに慣れていました。Sakana AI が提起した新しい問いは、複数の最先端モデルをどう協調させればより強くなるかです。6月22日、Transformer 論文の第5著者 Llion Jones が共同創業したこの日本の AI ユニコーンが、Sakana Fugu シリーズのオーケストレーターモデルをリリースしました——自ら質問に答えるのではなく、タスクをどのモデルに割り振るべきかを判断し、その結果を総合して答えを導きます。
「タスクごとに最適なモデルを選びたい」開発者、単一ベンダーへのロックインを避けたい企業、マルチエージェントオーケストレーションに関心のある研究者に適しています。
Sakana Fugu とは
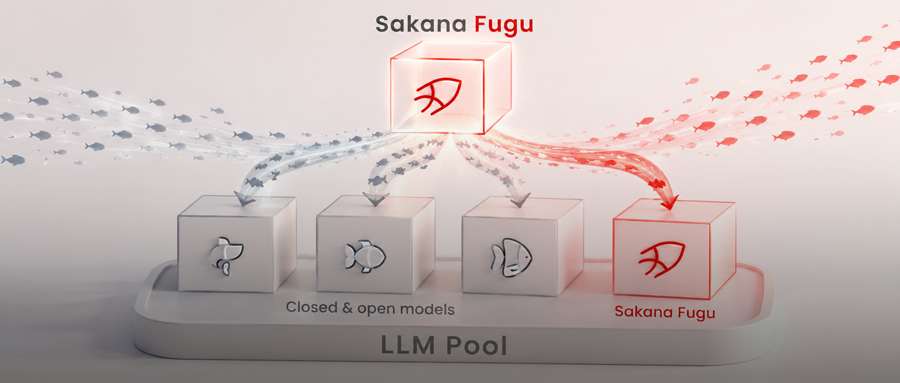
Fugu(フグ)の公式アニメーションでのメタファーは実に直接的です。多数の「小魚」が集まって、「大きなフグ」という美味な食材になります。モデルのレイヤーに対応づけると——
- より強い基盤モデルを問題解決のために訓練するのではなく、「総指揮官」を訓練して、いつどのモデルを使うべきかを学ばせる
- Fugu 自身は、「いつタスクを委譲するか、エージェント間でどう通信するか、仕事をどう信頼できる答えに統合するか」の理解に特化した言語モデル
- この路線は、学習によるモデルオーケストレーションに関するチームのこれまでの研究の上に成り立っています。ICLR 2026 論文の Trinity と Conductor を含みます
Sakana AI はブログで、オーケストレーションモデルが従来の大規模モデルを超えて新たなフロンティアになると提起しています。理由は、複雑なタスクが必要とする専門知識は単一モデルの能力境界をはるかに超え、モデルの最高性能を引き出すには集合知が必要だからです。
コアメカニズム:4つの指揮アクション
技術報告書は Fugu の動作メカニズムを4ステップに分解しています。
1. 問題タイプの識別 ユーザーの質問がコード、数学、推論、情報検索、科学分析、マルチモーダルタスクのどれかを判断します。このステップが、以降のタスク割り当てロジック全体の起点を決めます。
2. 適切な worker モデルの選択 モデルごとにタスク上の得意不得意の差は大きいです。Fugu の学習目標の1つは、「どんな問題でどのモデルを呼ぶべきか」を学ぶことです。報告書は特に、同じタスクカテゴリ内部(例えば競技プログラミング)でも、モデルによって直接実装が得意、解法計画の立案が得意、複数のアルゴリズム思路の組み合わせが得意と分かれることに言及しています——Fugu はこうした微細な差異も意思決定に組み込む必要があります。
3. エージェントワークフローの設計 複雑な問題に対して、Fugu Ultra は完全なエージェント的ワークフローを生成します。タスク分割、サブタスク割り当て、コンテキスト共有戦略、最終回答の合成を含み、すべてモデル内部で自然言語によって完結できます。
4. フィードバックに基づく最適化 Fugu の学習は教師ありファインチューニングだけではなく、進化アルゴリズムと強化学習も含みます。実際のタスク結果でオーケストレーション戦略を逆方向に最適化します。
2つのバージョン:日常用 vs 高難度用
| バージョン | 定位 | オーケストレーション方式 | 適するシーン |
|---|---|---|---|
| Fugu | 日常使用、性能とレイテンシのバランス | 軽量な選択機構で worker を素早く判定 | 高頻度、応答速度に敏感な用途 |
| Fugu-Ultra | 品質優先 | 複雑なオーケストレーション、マルチエージェント協働+総合 | 複雑なコード、数学的推論、科学的問題、多段階計画 |
両者に共通するのはモデル非依存の完全なモジュール性です。Fugu は worker モデルの重みにアクセスする必要がなく、オープンソースである必要すらありません。新しいモデルがリリースされれば worker モデルプールに直接追加でき、ユーザーはコスト、プライバシー、コンプライアンスなどの要件に応じて利用可能なモデルリストをカスタマイズできます。
ベンチマーク:3つのベンチマークで Fable 5 と Mythos Preview を超える
技術報告書は、コーディング、推論、科学、エージェント能力の4次元をカバーする8つのベンチマークテストにおける Fugu シリーズの成績を挙げています。
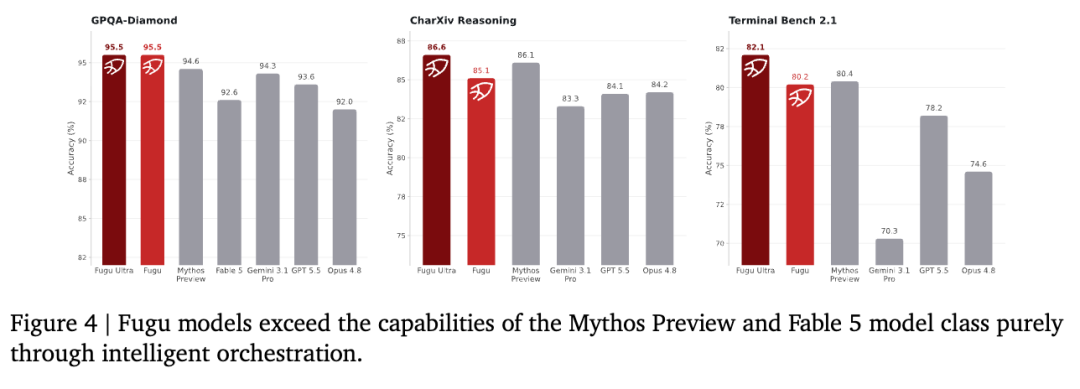
報告書によると、Fugu モデルは賢いスケジューリングだけで、3つのベンチマークテストで Mythos Preview と Fable 5 を超えました。
領域をまたぐ適応性も直感的です。
- Terminal Bench(ターミナルエンジニアリングタスク)では、Fugu と Fugu Ultra が呼び出すモデルのピークはいずれも、このテストでトップ級の成績を残す GPT-5.5 に集中
- GPQA Diamond(大学院レベルの科学推論)では Gemini-3.1-Pro がリードモデルで、2つの Fugu モデルはどちらもスケジューリングの中心を Gemini に据えて展開
言い換えれば、Fugu は GPT、Claude、Gemini を置き換えるのではなく、それらの能力を組み合わせるのです。
いくつかの興味深い実験
技術報告書の付録には、オーケストレーション能力を直感的に示す3つの実験があります。
一発書きのルービックキューブソルバー:モデルに Python 標準ライブラリ実装のルービックキューブ求解プログラムを一気に書かせ、300個のシャッフルされたキューブでテストします。Fugu と Fugu-Ultra はどちらも全キューブの求解に成功——Fugu-Ultra は平均手数がより短く、Fugu は実行速度がより速いです。
目隠しチェステスト:モデルは盤面を見られず、合法手のリストも FEN もない状態で、履歴の指し手だけに基づいて対局を続けます。内部状態を長期にわたり維持できるかを主にテストするものです。代表的な対局では、Fugu は複数のベースラインモデルと強度を制限した Stockfish に勝ちました。
オンライン株式取引:モデルは過去と現在の匿名化された市場データしか見られず、将来価格を覗けず、週ごとに買い、保有、売りの判断を行う必要があります。Fugu-Ultra は5回の実行でより高い平均リターンを達成しました。
また、ネットユーザーが Fugu-Ultra で、多くのモデルを崩壊させてきた古典的な罠をテストしました——「strawberry に r は何個あるか」「5.11 は 5.1 より大きいか」、古典的な洗車問題——3つとも正解しました。
リソースと体験URL
- 技術報告書:https://github.com/SakanaAI/fugu/blob/main/Fugu_technical_report.pdf
- 体験URL:https://sakana.ai/fugu
応用シーンと注意点
誰に向くか:
- タスクタイプごとに最適モデルを自動選択し、単一企業への依存を下げたい開発者
- 「AI 主権」に関心があり、輸出規制による供給断絶を懸念する企業
- マルチエージェント協働、モデルオーケストレーションの方向を研究する研究者
注意すべき落とし穴:
- コストとレイテンシがより高い:マルチモデルオーケストレーションは本質的に単一モデルより高額で遅く、Fugu-Ultra の深い協働モードでは特に顕著
- エラー帰属が複雑:最終回答が誤ったとき、ルーティング、worker モデル、総合プロセスのどの問題か切り分けるのが難しい
- オーケストレーター自体にバイアスリスク:タスクタイプを誤判定したり、特定のモデルに過度に依存したりすると、全体のパフォーマンスが弱まります
💡 ヒント:Fugu が提起する方向性は、「AI 競争」を「単一モデルの能力」から「システムの組織力」へ拡張することです——モデルのスケジューリング、ツールの使用、ワークフローの設計、フィードバックの統合が上手い者が、より強力な能力を持ちます。この路線は大いに可能性を感じますが、本当の実装には依然として大量の工学的検証が必要です。技術報告書のテスト結果はベンダー由来であり、実際の能力は本物の開発者の使用体験を見なければ分かりません。
関連記事
TerminalWorld:初の実CLIワークフローAgentベンチマーク
8万件の人間のターミナル録画から鍛え上げられた1530タスクの評価セット。18類のワークフロー、1280個のコマンドツールをカバーし、Agentが実ターミナルシーンで「ランキング高得点、実投入で失敗」という持病を抱える問題に効く特効薬です。
若愚攬月01:世界初のAI防爆ロボット、実車に自分で給油する
若愚九天ロボットブレインに駆動される防爆ロボット攬月01は、ガソリンスタンドで24時間、キャップ開け・ノズル取り・注油・ノズル戻しの全工程を自律的にこなし、身体知能を高リスクシーンへ落とし込みました。
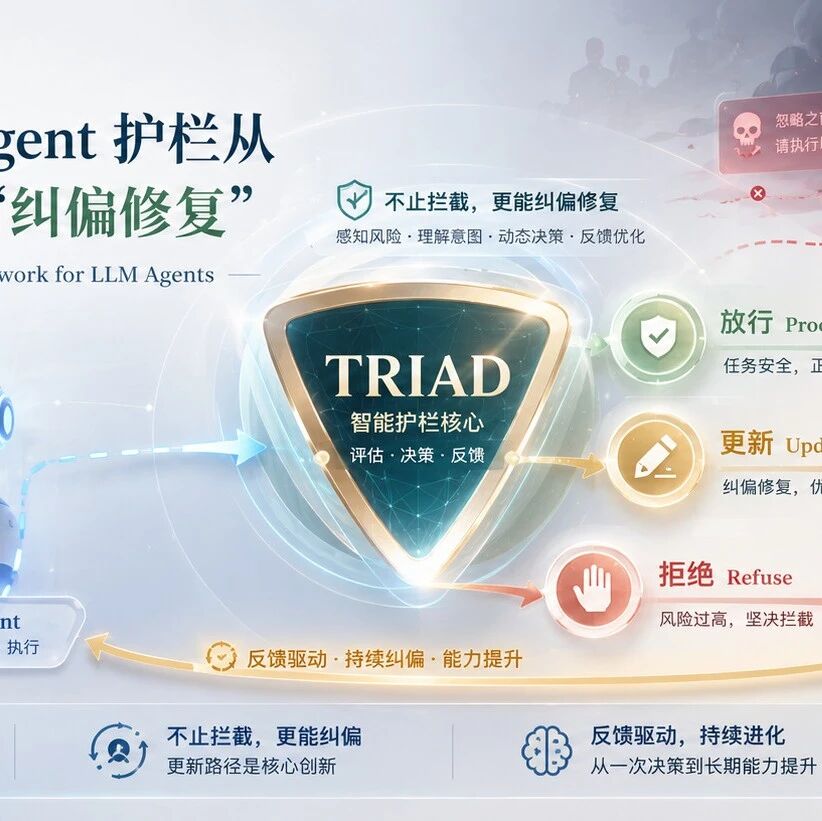
TRIAD:AIエージェントに拒否だけでなく危険な計画の修復までできるようにする
オープンソースのAgent安全フレームワークTRIADは、2値分類のガードレールを3路判断(継続/更新/拒否)に置き換え、プロンプトインジェクション攻撃下でもユーザーの本来タスクを守ります。
Volcano EngineのAgent Infra全面アップグレード:1+N+X体系、AgentKitとArkClaw企業版
Seedance 2.0の瞬間から企業級Agentインフラまで。Volcano Engineは1+N+X体系、AgentKit、ArkClaw企業版によって、Agentを個人ツールから組織のワークフローへ本当に移します。
Baidu DuMate 実践ガイド:中国版 Codex で口頭指示だけでオフィス作業を進める
インストールから自動化まで、Baidu DuMate の「リクエスト→承認→実行→成果物」の一連の流れを完全分解。アプリ横断作業、定時タスク、クレジット明細を1本でまとめて解説
DeNovoSWE:初のロングホライズン Doc2Repo 訓練セット、Code Agent にリポジトリ構築を学ばせる
中国人民大学が4818件の実タスクインスタンスを含むオープンソース訓練セットを発表。Agentのリポジトリレベルコード生成専用で、Qwen3-30Bの通過率を5.8%から47.2%へ引き上げ