
SkillOpt:ニューラルネットワークのようにAgentスキル文書を訓練する
Microsoftがオープンソース化したテキスト空間最適化フレームワーク。Agentのスキル文書を自動進化させ、52項目の評価すべてで最高性能を達成。
SkillOpt:ニューラルネットワークのようにAgentスキル文書を訓練する
Microsoftがオープンソース化したテキスト空間最適化フレームワーク。Agentのスキル文書を自動進化させ、52項目の評価すべてで最高性能を達成。
Agentのスキル文書(CLAUDE.md、Codexのskillファイル、system prompt)を書くのは、本質的に手作業の試行錯誤だと感じたことはないでしょうか。1版書いて、いくつかタスクを走らせ、うまくいかなければ直し、直してはまた走らせる。Microsoftがオープンソース化した SkillOpt はこのプロセスを自動化しました——スキル文書を「訓練可能なパラメータ」として扱い、ニューラルネットワークの訓練に似たループで、あなたのAgentのスキル文書を最適化します。
7つのモデル、6つのベンチマーク、3種類の実行環境を組み合わせた全52個の評価において、SkillOptが訓練したスキル文書はすべて最適または同率最適を達成しました。GitHubでは公開1週間で3.3k starを獲得しています。
SkillOpt とは何か
SkillOptはMicrosoftがオープンソース化したテキスト空間最適化フレームワークです。中心となる発想は、モデルの重みを訓練するのではなく、Agentの振る舞いを導く自然言語のスキル文書だけを訓練するというもの。スキル文書をAgentの「外部重み」とみなし、内部の重みが勾配降下で最適化できるなら、外部重みにも体系的な訓練手法があるはずだ、という考え方です。
主要リソース:
- 公式サイト:https://microsoft.github.io/SkillOpt/
- GitHub:https://github.com/microsoft/SkillOpt
- 論文:https://arxiv.org/abs/2605.23904
訓練ループ:4つのコアステップ
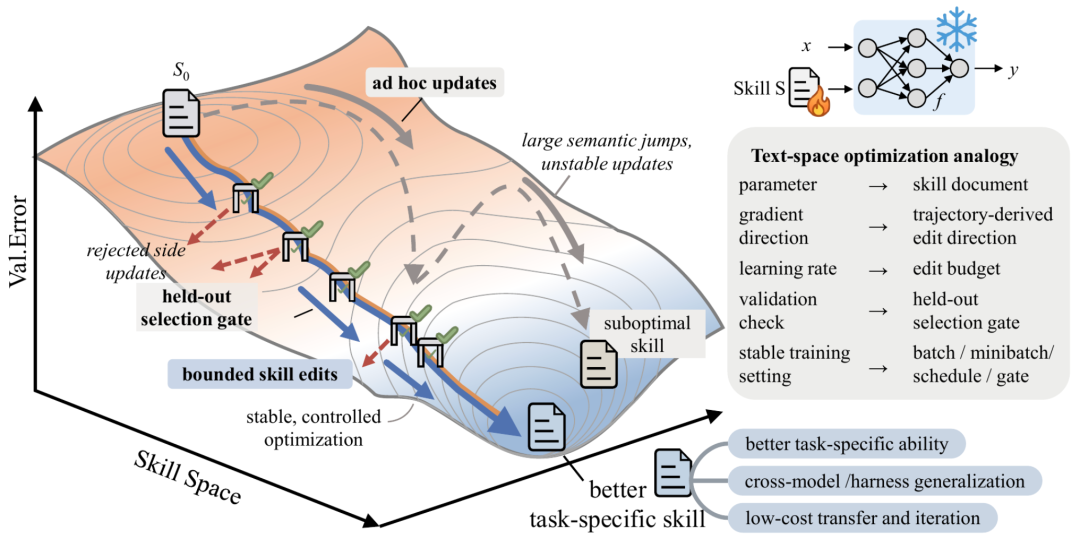
SkillOptの訓練ループは、深層学習の「順伝播-逆伝播-パラメータ更新」に直接対応していますが、テキスト空間で実行されます。
ステップ1:Rollout(順伝播)
凍結したターゲットモデルが現在のバージョンのスキル文書を持って一連のタスクを実行し、完全な実行軌跡——メッセージ、ツール呼び出し、検証フィードバック、最終スコアを含む——を記録します。このステップが産出するのは「証拠」で、ニューラルネットワークの順伝播の結果に相当します。
ステップ2:Reflect(逆伝播)
独立したオプティマイザモデルが、この一連の実行軌跡を分析します。鍵となる設計は、失敗ケースと成功ケースを分けて反省する点です。失敗のminibatchは「どの操作ルールを修正すべきか」の発見に、成功のminibatchは「どの既存ルールが機能していて、動かしてはいけないか」の確認に使われます。これは「テキスト空間の勾配」を計算することに相当します。
ステップ3:Edit(パラメータ更新)
オプティマイザモデルは反省の結果に基づいて、スキル文書への構造化された編集操作を提案します。新しいルールの追加(add)、無効になったルールの削除(delete)、修正が必要なルールの置換(replace)です。
ステップ4:Gate(検証ゲート)
候補となる新しいスキル文書は、必ずheld-out検証セットで一度走り、性能が厳密に向上した場合にのみ受け入れられます。これが過学習を防ぎ、毎回の更新が真の改善であることを保証します。
ループ全体で複数のepochを回し、各epoch内で複数のstepを回す、というリズムはニューラルネットワークの訓練とまったく同じです。
2つの精巧な訓練テクニック
テキスト学習率
ニューラルネットワークの訓練では、学習率が大きすぎると破滅的な忘却が起きます。SkillOptはテキスト空間でまったく同じ問題に直面します——一度の編集で変更が大きすぎると、それまでに学んだ有効なルールを上書きしてしまうおそれがあります。
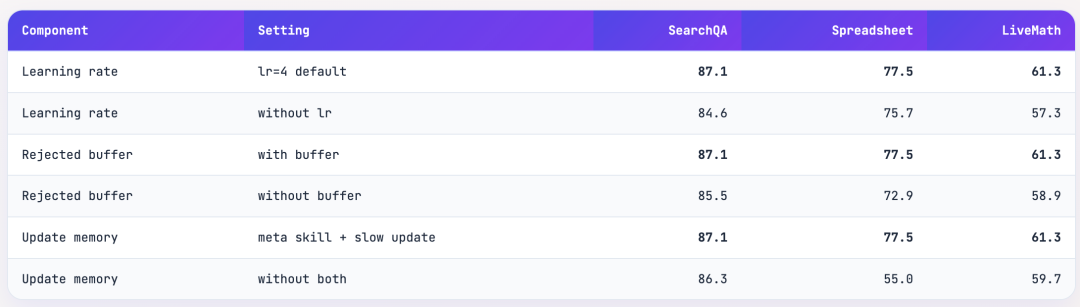
解決策が「テキスト学習率」です。各ステップで許される編集操作の数には上限があり、デフォルトは lr=4、つまり1ステップで最大4つのadd/delete/replace操作です。この設計の必要性はアブレーション実験でも検証されています。学習率の制約を外すと、SearchQAの性能は87.1%から84.6%へ、SpreadsheetBenchは77.5%から75.7%へ低下しました。
Rejected-Edit Buffer(負フィードバックメモリ)
編集提案が検証ゲートに拒否された場合、単に捨てられるのではなく、バッファに入れられます。オプティマイザは後続の反省ステージでこれらの「失敗した試み」を参照でき、類似した無効な編集を繰り返し提案するのを避けられます。これはオプティマイザに負の勾配情報を与えることに相当します。このバッファを外すと、SpreadsheetBenchは77.5%から72.9%へと急落しました。
評価結果:52項目すべてでリード
SkillOptの評価はカバー範囲がかなり広範です:
- ターゲットモデル:GPT-5.5、GPT-5.4、GPT-5.4-mini、GPT-5.4-nano、GPT-5.2、Qwen3.5-4B、Qwen3.6-35B-A3B
- ベンチマーク:SearchQA(質問応答)、SpreadsheetBench(コード生成)、OfficeQA(ツール拡張質問応答)、DocVQA(文書視覚質問応答)、LiveMathematicianBench(数学推論)、ALFWorld(身体性エージェント)
- 実行環境:直接対話、OpenAI Codex、Anthropic Claude Code
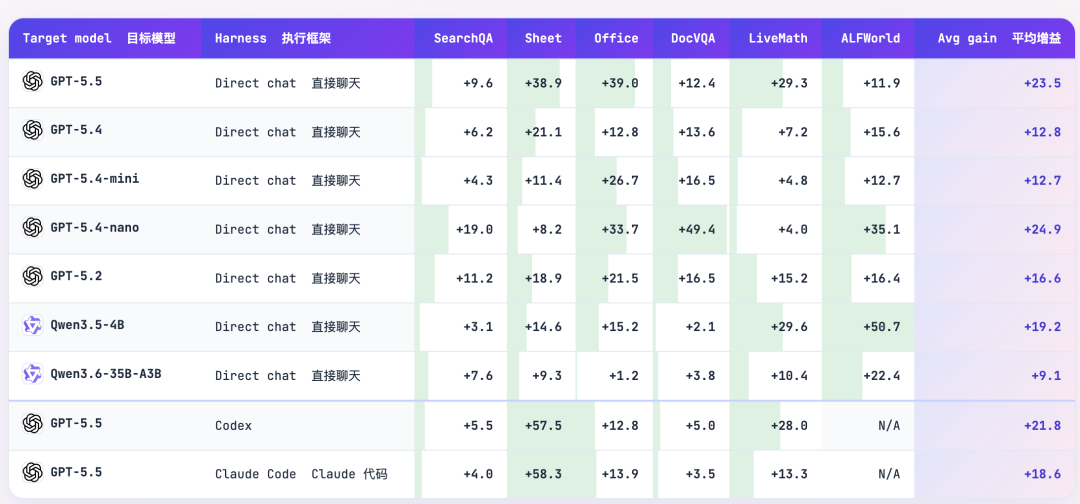
注目すべき数字をいくつか紹介します:
| モデル + 環境 | ベンチマーク | 向上幅 |
|---|---|---|
| GPT-5.5 直接対話 | SpreadsheetBench | +38.9 |
| GPT-5.5 直接対話 | OfficeQA | +39.0 |
| GPT-5.4-nano(最小モデル) | DocVQA | +49.4 |
| GPT-5.5 + Codex | SpreadsheetBench | +57.5 |
| GPT-5.5 + Claude Code | SpreadsheetBench | +58.3 |
小さいモデルほど向上幅が大きくなっています——良い操作マニュアルは、ベテランより初心者をはるかに助けるというわけです。
転移能力:1回の訓練を複数箇所でデプロイ
SkillOptが訓練したスキル文書は、強い転移能力を示します:
- モデル横断の転移:GPT-5.4で訓練したLiveMathスキルをGPT-5.4-nanoにそのまま転移して使うと、15.2ポイント向上
- 環境横断の転移:Codex環境で訓練したSpreadsheetBenchスキルをClaude Code環境にそのまま転移して使うと、31.8ポイント向上
- 自己最適化:GPT-5.4-nanoをターゲットモデルとオプティマイザの両方に使った(自分で自分を最適化した)場合でも、SpreadsheetBenchは10.4ポイント向上
デプロイは極めてシンプルです。最終的に必要なのは best_skill.md ファイル1つだけで、オプティマイザモデルも不要、記憶モジュールも不要、追加の推論オーバーヘッドも一切ありません。
使い方
SkillOptの使用フローは、次のステップにまとめられます:
- ターゲットモデルとタスクセットの準備:最適化したいAgentモデル(例:GPT-5.4)を選び、検証関数付きの一連のタスクを用意します
- 初期スキル文書の作成:簡単な手書きドラフトでもよく、空の文書でもかまいません
- オプティマイザモデルの設定:オプティマイザとして使うモデルを選びます(通常はターゲットモデルより強いモデルを選択)
- 訓練パラメータの設定:テキスト学習率(デフォルトはlr=4)、epoch数、各epochのstep数など
- 訓練ループの起動:Rollout -> Reflect -> Edit -> Gate のループを実行します
- 最終スキル文書の取得:訓練完了後、
best_skill.mdが出力されるので、そのままあなたのAgentにデプロイします
詳しい使い方はGitHubリポジトリのドキュメントとサンプルを参照してください。
向いている人
- Agent開発者:CLAUDE.mdやCodexのskillファイルなど、Agent設定ファイルをメンテナンスしている開発者
- プロンプトエンジニア:長文ドキュメントのプロンプトを体系的に最適化する必要がある実務者
- AIアプリケーションチーム:基盤モデルを入れ替えずにAgentの性能を向上させたいチーム
SkillOpt は重要な洞察を教えてくれます。Agentに関わるすべては自己学習可能であり、その振る舞いを導くスキル文書自体も例外ではない、ということです。
関連記事
GPT-5.6リリース:3段階の新モデル + ChatGPT Work、Codexはデスクトップ版へ統合
OpenAIがGPT-5.6シリーズ(Sol/Terra/Luna)とChatGPT Work agentをリリース。CodexはChatGPTデスクトップアプリに統合され、完全な料金体系と利用チャネルも併せて紹介。
ChatGPT音声の大規模アップグレード:全二重のGPT-Liveモード登場
OpenAIが全二重音声モデルGPT-Liveをリリース。ChatGPTがついに聞きながら話し、自然に相槌を打ち、沈黙のタイミングを知るようになった。従来のAdvanced Voice Modeを置き換える。
LingBot-World 2.0:オープンソースで遊べる無限長時間の対話型世界モデル
Ant Group傘下のRobbyantがLingBot-World-Infinityをオープンソース化。720p/60fps・時間単位のリアルタイム生成で、内蔵Agentがイベントを自動提案し、「動画を見る」が「世界に入る」に変わる。
2つのオープンソースSkill:Codex/Claude Codeに記事の図解とWebデザインを任せる
オープンソースのguizang-material-illustration記事図解Skillとweb-design-taste WebデザインSkill。コマンド1行でCodexに入れて、AI臭い図解とワンパターンなWebページにサヨナラ。
Tencent混元Hy3正式版:GLM-5.2に比肩する中国産Coding Agentモデル
Tencent混元Hy3正式版が登場。295B MoEアーキテクチャ、Agentタスク成功率は90%へ向上、API価格は1人民元/100万トークンで、WorkBuddy内では期間限定無料トライアル中。
Vidu S1:デジタルヒューマンとリアルタイム対話するオープンソース級の対話型動画モデル
生数科技のVidu S1がリアルタイム音声駆動の動画生成を実現。540P/25FPSでコンシューマーGPUでも動き、画像1枚が瞬時に会話できるデジタルヒューマンに変わる。