
STAR-PólyaMath:大モデルに「間違いに気づいたら直す」を学ばせるオープンソース推論フレームワーク
清華大学とMicrosoft Research Asiaが共同でオープンソース化したマルチエージェント推論フレームワーク。Reasoner、Verifier、Meta-Strategistの3役で長距離推論を検証可能・遡行可能にし、ApexベンチマークでGPT-5.5を13.5%上回る。
STAR-PólyaMath:大モデルに「間違いに気づいたら直す」を学ばせるオープンソース推論フレームワーク
清華大学とMicrosoft Research Asiaが共同でオープンソース化したマルチエージェント推論フレームワーク。Reasoner、Verifier、Meta-Strategistの3役で長距離推論を検証可能・遡行可能にし、ApexベンチマークでGPT-5.5を13.5%上回る。
最難関の数学競技問題を前にすると、最強の大モデルでも同じ間違いの上で空回りを繰り返す——一見もっともらしい路線に沿って細部を補い続け、説得力のある論証を書き連ねるが、「これは磨きをかけるべき解法ではなく、行き止まりだ」というメタ認識が欠けている。清華大学と Microsoft Research Asia が共同でオープンソース化した STAR-PólyaMath は、マルチエージェントフレームワークでこの問題を解決した。Reasoner、Verifier、Meta-Strategist の3役の循環駆動により、推論過程を検証可能・遡行可能・試行横断で経験を蓄積できるものにする。8大数学競技ベンチマークすべてで最良を達成し、Apex ベンチマークでは同一ベースの GPT-5.5 に13.5%の差をつけてリードした。
プロジェクト背景
- 論文タイトル:STAR-PólyaMath: Multi-Agent Reasoning under Persistent Meta-Strategic Supervision
- 論文リンク:arxiv.org/abs/2605.19338v1
- オープンソースリンク:github.com/Julius-Woo/STAR-PolyaMath
- 第一著者:呉嘉驁(清華大学人工知能学院 T-STAR Lab 博士課程)
- 責任著者:張憲(Microsoft Research Asia プリンシパル研究員)、董胤蓬(清華大学人工知能学院准教授)
フレームワークの着想は、ポリア(George Pólya)が『How to Solve It』で示した解題ステップ——問題を理解する、計画を立てる、計画を実行する、振り返って反省する——に由来し、探索、計画と分解、逐次実行とチャレンジの循環、解答生成の4段階へ構造化した。
長距離推論の三重の困難
最先端の大モデルは通常の推論ではすでに非常に強力だが、多段階の探索、仮説の検証、さらにはやり直しを要する長距離推論となると、3類の系統的な失敗モードが繰り返し現れる。
幻覚の蓄積と信頼性の問題。 モデルは自身の中間結論に対して高い確信を保つ傾向があり、一見微小な誤り(境界ケースの見落としなど)が後続の導出で増幅され続ける。
試行横断での記憶喪失。 ある証明経路が失敗して遡る必要があるとき、大方のシステムは過剰なコンテキスト情報を保持して誤り箇所を特定できなくなるか、逆に以前の試行の重要情報を失い、すでに反証された方向を繰り返し試す結果になる。
推論とツール使用の不均衡。 コードの実行は信頼できる検証手段だが、ツール使用データで訓練されたモデルは、コードへ系統的に偏り、数学構造の発見を軽視する。逆に、純粋な自然言語推論では、記号化された構築を要する問題を扱いにくい。
コアアーキテクチャ:3つのエージェント役割
フレームワーク全体は、推論能力を持たない Python のオーケストレータ(Orchestrator)が3つのエージェント役割を協調する構成だ。
Reasoner(推論者)
実際の問題解決を担当する。問題構造の探索、計画の提案、各ステップの推論や計算の実行を行い、異議を唱えられたときには自らの論証を弁護する。その出力は常に検証段階を通る必要がある。
1回の試行(1つの計画を順に実行すること)の中で、Reasoner は完全な記憶を保持する。しかし遡行して再計画するときは記憶をリセットし、誤った推論の汚染を減らす。
Verifier(検証者)
Reasoner の出力を独立に審査し、記憶は保持しない。審査には2つのゲート機構がある:
- Goal Gate(目標ゲート):そのステップが計画で宣言された目標を本当に完了したかを検査し、「意味的ドリフト」(論証は正しいが平凡な解答しか完了していない現象)を防ぐ。
- Logic Gate(論理ゲート):推論内容の正確性を審査する。
審査のあと、通過(Accept)、異議(Challenge)、遡行(Trace-Back)、再計画(Propose-Replan)の4判定のいずれかを下す。
Meta-Strategist(メタ戦略家)
これがこのフレームワークの最も重要な革新だ。具体的な数学推論は一切実行せず、より高い次元で指導を与える——経験豊富なメンターのように。問題解決の全過程を通じて単一の持続的セッションを維持し、それまでのすべての試行、放棄された戦略、長期化する失敗パターンを蓄積する。
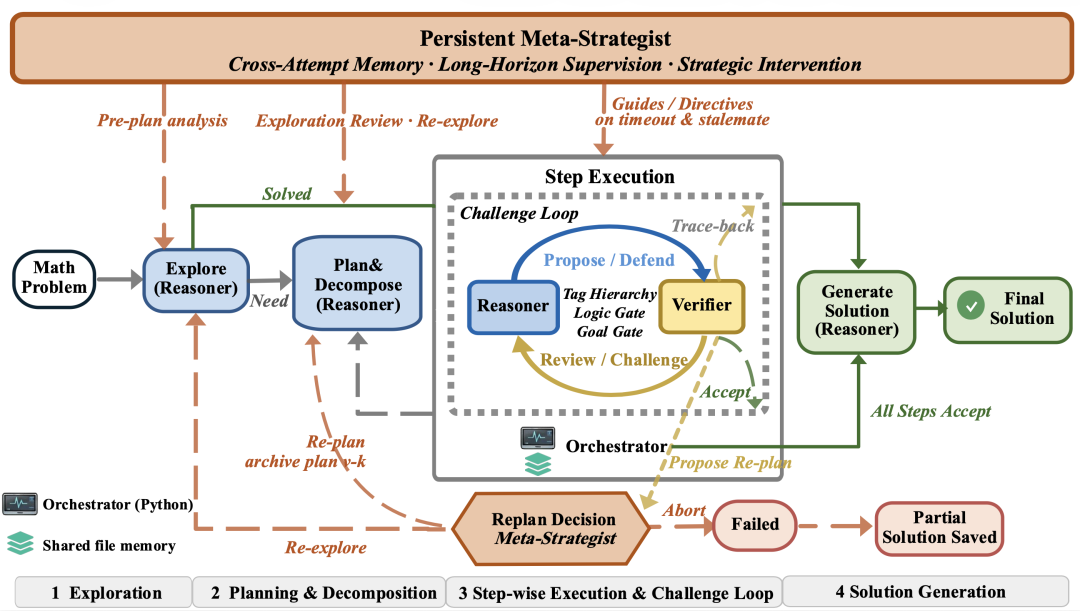
重要な局面では、Meta-Strategist が具体的な戦略提案を出す。たとえば Verifier が再計画を提起したときに最終判断を下す。Reasoner が無意味な計算待ちに連続して陥っていることを検出すると、コード使用を禁止した純粋推論モードへの切替を命じる強制指令を発することもできる。
1つの典型例
MathArena Apex 2025 Problem 2(Turkey TST 2025 P5 由来)は典型例で、正解は k = 1/2。最高思考強度の GPT-5.5 はこの問題に8回の独立試行を行い、正解はわずか1回だった——ある準最適構築(誤答3/4)へ急速に収束し、その誤った結論を支える論理的に自己整合した論証を懸命に積み上げたのだ。
同じ問題で、STAR-PólyaMath の Reasoner の最初の試行は同様に失敗した(3/4 を得た)が、Verifier はその証明過程を最後まで疑い続けた。3回のタイムアウト失敗を経て、Meta-Strategist は重大な判断を下した。「この方向は根本的に誤っている」。以後の推論が3/4に固定し直すのを明確に禁止し、再計画を許可した。新しいプランはより稠密な構築を見つけて結果を1/2 まで押し進め、数学的導出と実際の構築コードによる検証で厳密な証明を完了した。
💡 ヒント:ベースモデル差し替え実験により、性能向上がモデルそのものではなく構造化推論 harness フレームワーク由来であることが明確に示されている。ベースモデルを GPT-5.5 から GPT-5.2 や Claude Opus 4.7 に置き換えても、フレームワークはすべてのベンチマークで各モデルの直接呼び出し結果を上回った。つまり、より安いモデルで近い効果を出せるということだ。
検証機構:階層化された検証ラベル
STAR-PólyaMath は階層化された検証ラベルにより、長距離推論の各ステップに検査可能性を与える。各中間アサーションは次のいずれかにラベル付けされなければならない:
[verified]:コード検証を実行済み[easy-verify]:簡単な計算で確認可能[hard-verify]:厳密な数学審査が必要
このラベル群が Verifier の審査強度を決め、コード検証の結果はそのまま信頼できるものとされ、純粋な数学論証は最も厳しい論理審査を受ける。
実際の実行統計を見ると、この階層戦略には明確な適応性が現れている:
- AIME、HMMT(計算中心):約36〜43%のアサーションがコード検証を通過
- IMO、Putnam(証明中心):85%以上のアサーションが
[hard-verify]に該当
実験結果
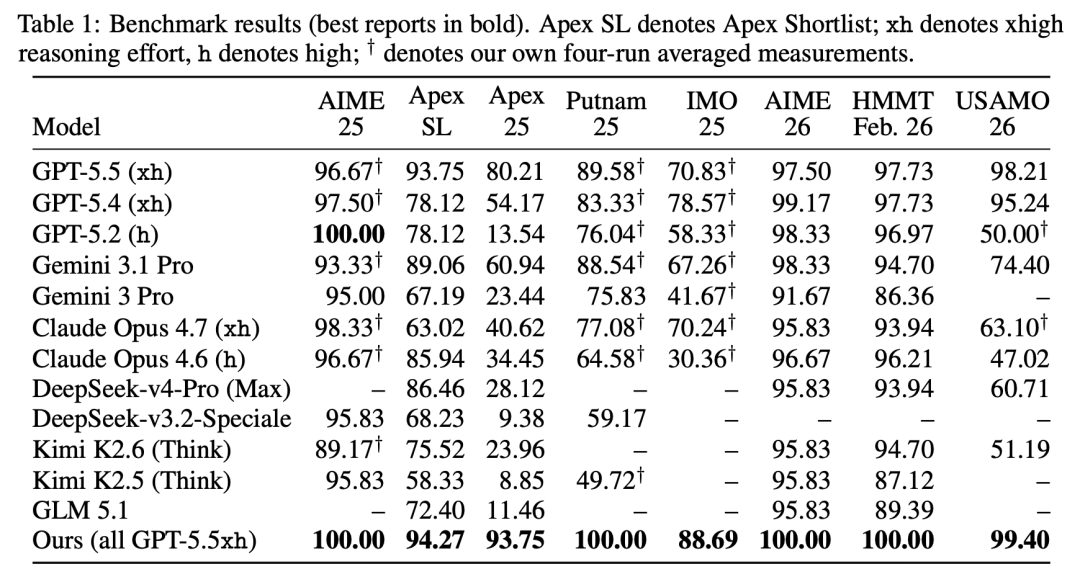
STAR-PólyaMath は GPT-5.5(xhigh effort)を3つのエージェントのベースモデルとして使い、8つのトップレベル数学競技ベンチマークすべてで最良成績を達成した。
ハイライトデータ:
- Apex 2025:93.75%に到達。同一ベースの GPT-5.5 の直接呼び出しはわずか80.21%で、差は13.5%に及ぶ。多段階の証明と戦略切替を要する最難関問題であり、Meta-Strategist が最大の価値を発揮するシーンだ。
- AIME 2025/2026、Putnam 2025、HMMT 2026:満点を獲得。
計算コストは問題の難度と強く相関する:
- AIME レベル:平均8分で完了。100%が探索段階で直接解決され、Meta-Strategist はほぼ起動しない。
- Apex 2025、IMO 2025 レベル:平均所要55分以上。Meta-Strategist は1問あたり平均1.6〜2.2回介入する。
フレームワークは易しい問題に不要なオーバーヘッドを課さず、真に難しい問題にだけ十分な計算資源を探索推論へ投じる。
数学を超えて:汎化可能な推論パラダイム
STAR-PólyaMath の設計は、数学領域の特殊な性質に依存していない。その核心機構(長距離タスクを検証可能なサブステップへ分解し、各ステップを構造化して検査し、試行横断で記憶し、高次元で監督する)は本質的に、長距離で遡行可能かつ検証可能な推論を要するあらゆるシーンに適用できる。
- コード生成:同様のフレームワークは「生成-テスト-デバッグ」の循環を、遡行付きの状態機械へ構造化できる。Meta-Strategist は修正を重ねても失敗が続いたあとで「現在のアーキテクチャの方向性自体に問題がある。書き直しが必要」と判断できる。
- 科学の発見:Reasoner が仮説と実験設計を提出し、Verifier が実験結果を審査し、Meta-Strategist が複数ラウンドの失敗のあと「実験方法を修正すべきか、根底の仮説を修正すべきか」を判断する。
プロジェクトは完全なコードフレームワーク、全役割の prompt と skill 定義、実行構成をオープンソース化しており、コミュニティがこの推論プロトコルを他の領域へ移行しやすくなっている。
💡 利用の推奨:多段階検証を要する複雑な推論(数学証明、アルゴリズム設計、科学探求)に関わる仕事なら、オープンソースコードを直接試してみてよい。単純なタスクにフル装備のフレームワークを適用しないこと——AIME レベルの問題は100%が探索段階で解決しており、余分なエージェントのスケジューリングはコストを増やすだけだ。
関連記事
Baidu が Unlimited OCR をオープンソース化:アクティブ500Mの小モデルが40ページを一息に記憶喪失なしで読み切る
Baidu がオープンソース化した Unlimited OCR は、総パラメータ3B / アクティブ500MのエンドツーエンドOCRモデル。OmniDocBench の SOTA を更新し、単一推論で数十ページの文書を記憶喪失なしに転写します。
Sakana Fugu:自らは答えず、他のモデルに指示して仕事をさせるオーケストレーター
Sakana AI がオーケストレーターモデルの Fugu シリーズをリリース。GPT、Claude、Gemini の賢いスケジューリングでタスクを完了し、性能は Fable 5 と Mythos Preview に迫ります。
Seko 無限キャンバスを実践:アイデアを放り込めば、Agent が AI 動画を一本仕上げる
Seko 無限キャンバス + Seedance 2.0 の実践ガイド。720P コストは50%ダイレクト値下げ、1080P は80%ダウンで、初心者でも10分で複数エピソードの AI 動画作品を作れます。
WeChat 小微 内部テスト実測:右スワイプひとつで WeChat 全体を Agent に変える
WeChat 公式 AI アシスタント「小微」の内部テスト体験。チャット要約、自動返信、ミニプログラム呼び出し、送金、モーメンツ閲覧、小ツール開発まで、8つの主要能力をひと目で把握できます。
教育部「陽光志願」AIアシスタント:志願入力プランを無料で生成
教育部が公式に「陽光志願」システムをアップグレード。AIアシスタント「智慧小招」が24時間対応し、公式データに基づいて「挑戦・安定・安全」の志願プランを無料で提供します。
GenShield:AI生成画像の検出+修復を一体化したオープンソースフレームワーク
北京大学などのチームがGenShieldをオープンソース化。AI生成画像の検出とアーティファクト修復を単一の自己回帰フレームワークに統合し、検出精度は98.8%に達する