
Harnessエンジニアリング:AIプログラミングの成功率を20%から100%へ跳ね上げる
AnthropicとOpenAIが同時に検証した結論:AIプログラミングエージェントが失敗する原因はモデルではなくHarnessにある。5ステップで最初のHarness設定を構築する方法を解説します。
Harnessエンジニアリング:AIプログラミングの成功率を20%から100%へ跳ね上げる
AnthropicとOpenAIが同時に検証した結論:AIプログラミングエージェントが失敗する原因はモデルではなくHarnessにある。5ステップで最初のHarness設定を構築する方法を解説します。
あなたの AI プログラミングエージェントは、「自信満々に動かないコードの塊を納品してくる」ことはありませんか? 問題はおそらくモデルそのものではなく、Harness を装備しているかどうかです。
Anthropic と OpenAI は2026年、ほぼ同時に実験で同じ結論を検証しました:AI プログラミングエージェントが失敗を繰り返す問題はモデルではなく、モデルの外側にある Harness インフラにあります。同じ Opus 4.5 モデルでも、裸で走らせれば9ドル使って全問失敗、Harness を付けると200ドルで成功率100%です。
Harness とは何か
Harness はツールでもなければ、プロンプトのテクニックでもありません。AI プログラミングエージェントの周囲に構築する一式のエンジニアリングインフラで、5つのサブシステムから成ります:
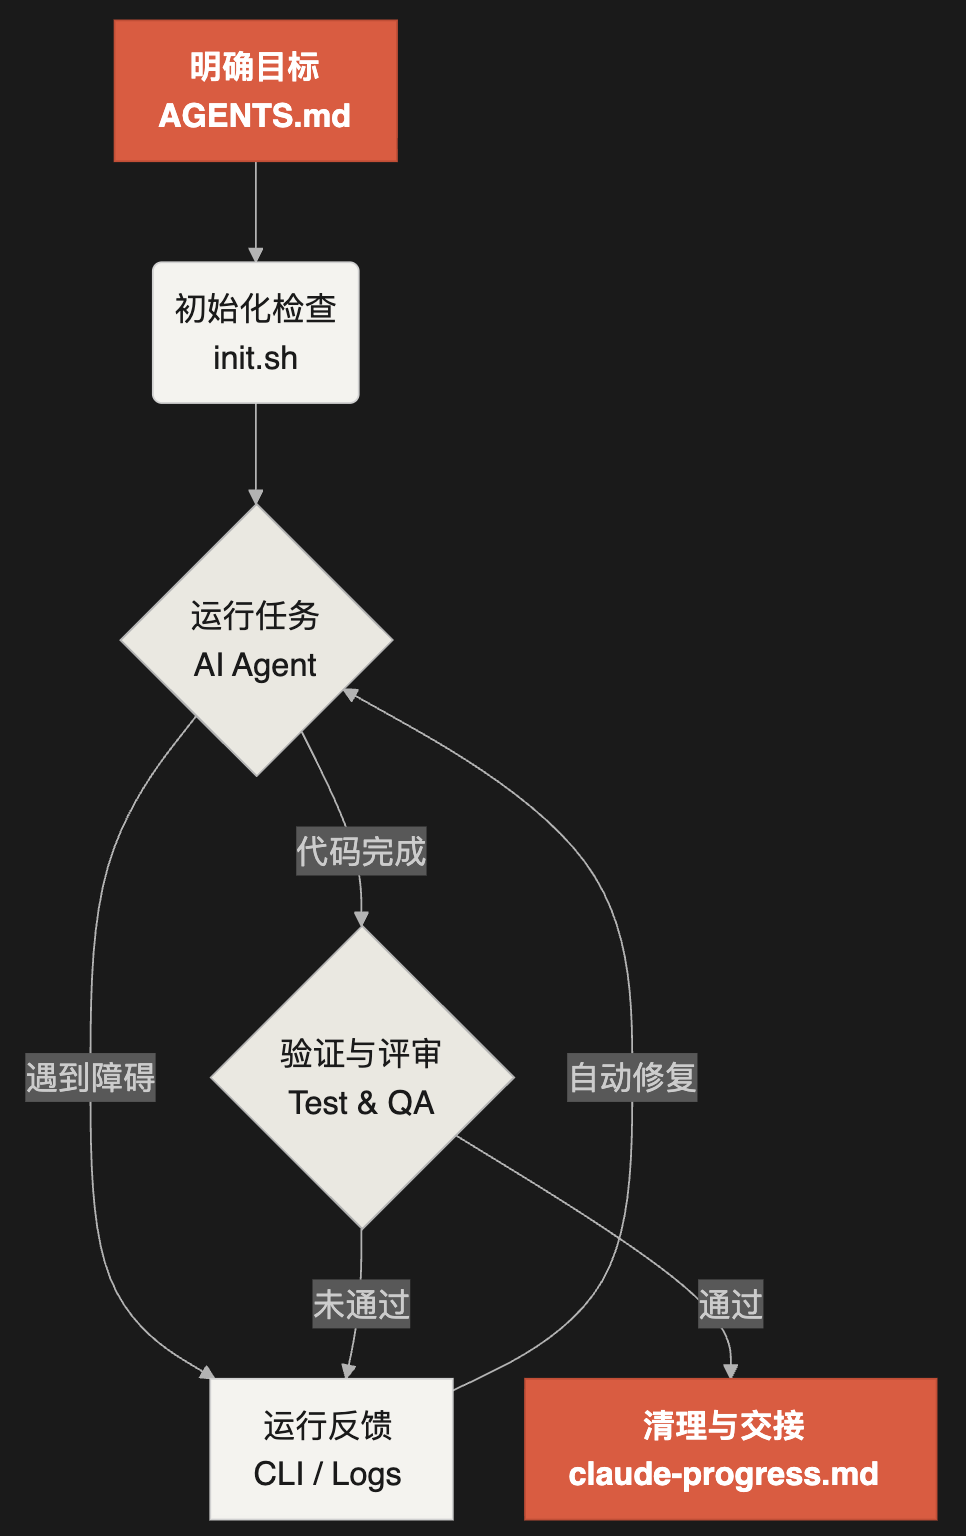
| サブシステム | 解決する問題 | 対応ファイル |
|---|---|---|
| 指示 (Instructions) | エージェントがプロジェクトの取り決めを知らず、場当たり的なコードを書く | AGENTS.md / CLAUDE.md |
| ツール (Tools) | 越権操作:rm -rf、git push --force | settings.json / config.toml |
| 環境 (Environment) | 手元では動くのに CI に行くと動かなくなる | setup.sh / Dockerfile |
| 状態 (State) | セッションをまたいで記憶を失い、衝突するコードを書く | PROGRESS.md |
| フィードバック (Feedback) | 早すぎる勝利宣言、コードがまったく動かない | type check / test / lint |
2つの対照実験
Anthropic の実験
同じ Opus 4.5 モデル、同じプログラミング問題です:
- 裸で実行:9ドル消費、成功率 0% -- コードスタイルは混乱、破壊的なコマンド、テストは未実施
- Harness 付き:200ドル消費、成功率 100% -- 余分に使った191ドルはすべて検証ループに投入
OpenAI の実験
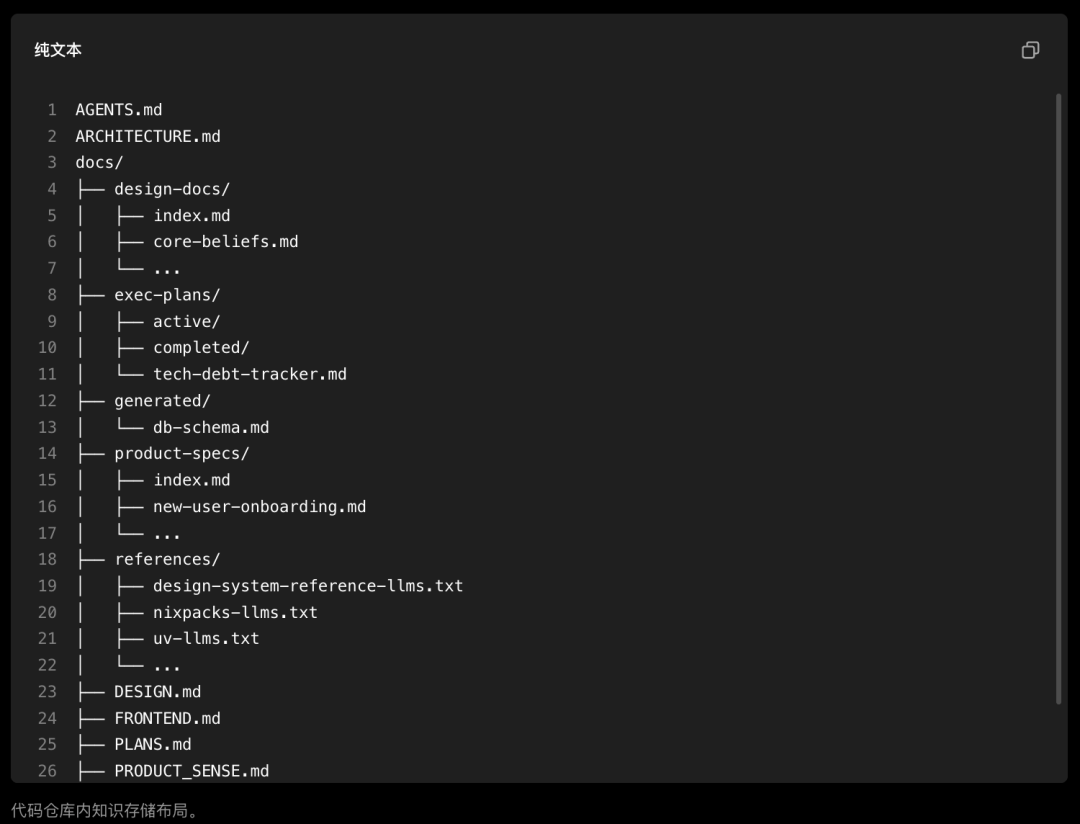
Codex チームは百万行の実リポジトリで検証しました。実験で変えたのは1点だけ -- リポジトリのルートに AGENTS.md ファイルを追加したことです。100行足らずの markdown です。
5ステップで Harness を構築する
以下の5ステップはテキストエディタだけで完了し、合計しても200行を超えない設定です。
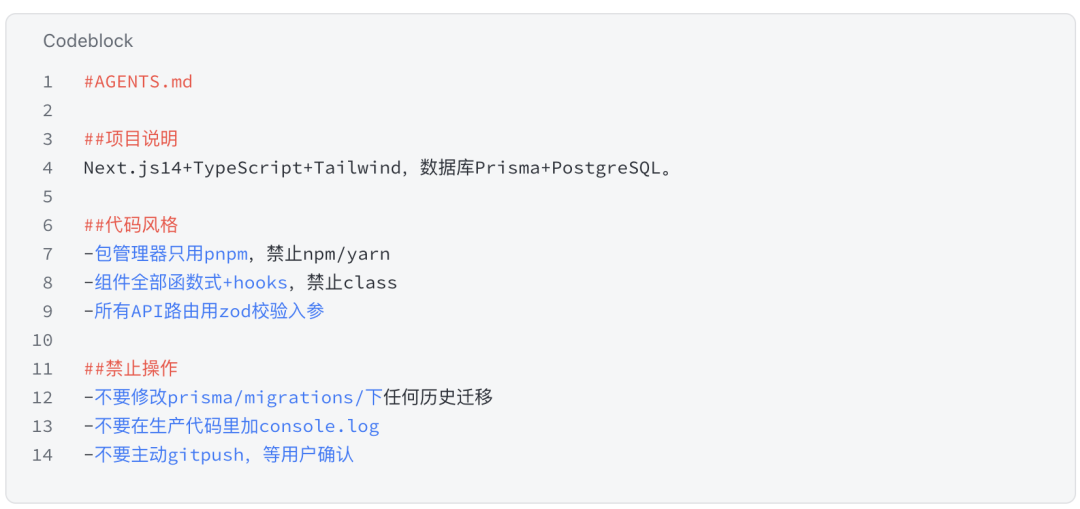
ステップ1:AGENTS.md(または CLAUDE.md)を作る
リポジトリのルートに markdown ファイルを作成します。OpenAI 陣営では AGENTS.md、Anthropic 陣営では CLAUDE.md と呼ばれます。Codex、Claude Code、Cursor は起動時に自動で読み込んでシステムプロンプトに注入します。
少なくとも3つのブロックを書きます:
# Project
これは Next.js + Prisma で構築された EC 管理画面です

# Forbidden
- git push --force の実行を禁止
- migrations ディレクトリの削除を禁止
- npm の使用を禁止(pnpm を使う)

# Done means
- pnpm typecheck が通る
- pnpm test がすべてグリーン
- pnpm lint で error ゼロ
15行足らずで、プロジェクトの取り決めを何度も言い聞かせるものから、起動時に自動注入されるものへと変えられます。
ステップ2:権限(Permissions)を設定する
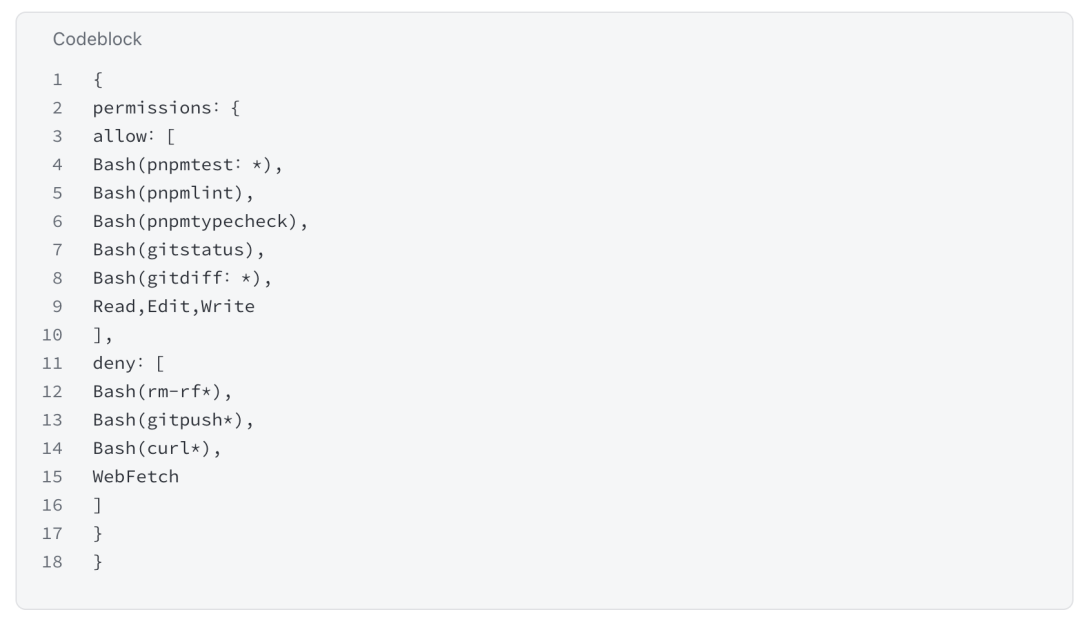
エージェントがどのコマンドを呼び出せるかを限定します。
Claude Code では .claude/settings.json、Codex では ~/.codex/config.toml を使います。
{
  "permissions": {
    "allow": ["pnpm install", "pnpm test", "pnpm typecheck"],
    "deny": ["rm -rf", "git push --force", "DROP TABLE"]
  }
}
許可されたものはそのまま実行し、禁止されたものは即座に拒否し、グレーゾーンには確認ダイアログを出します。
ステップ3:setup.sh を書いて環境を固定する
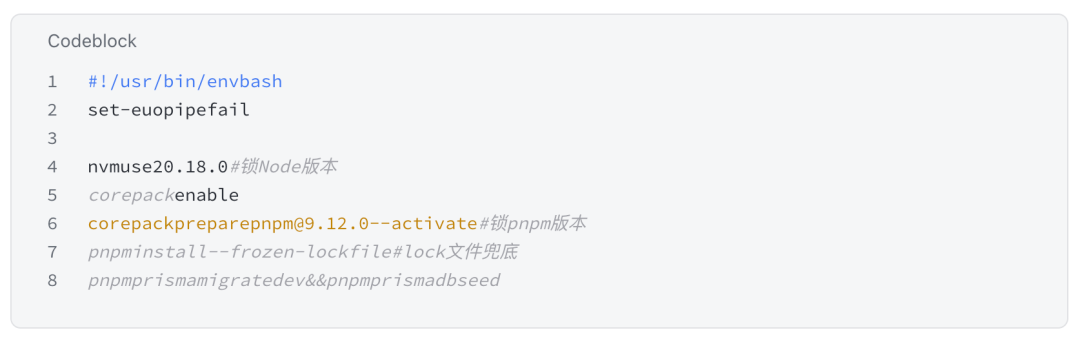
依存のバージョンとランタイム設定を固定します。すでに Dockerfile / devcontainer.json があればスキップでき、なければ setup.sh を書きます。
重要な1行:
pnpm install --frozen-lockfile--frozen-lockfile により、エージェントはどの依存も勝手にアップグレードできなくなります。
ステップ4:PROGRESS.md を作る
touch PROGRESS.md4つのセクションです:完了、進行中、未着手、既知の問題。git にコミットして、プロジェクト自身の一部として保守します。
AGENTS.md に取り決めを固定します:
## Rules
- 新しいセッションでの最初の仕事:PROGRESS.md を読む
- タスク完了やブレークポイント変化時:すぐ PROGRESS.md に書き戻す
- 衝突時はコードを優先 -- リポジトリが唯一の事実源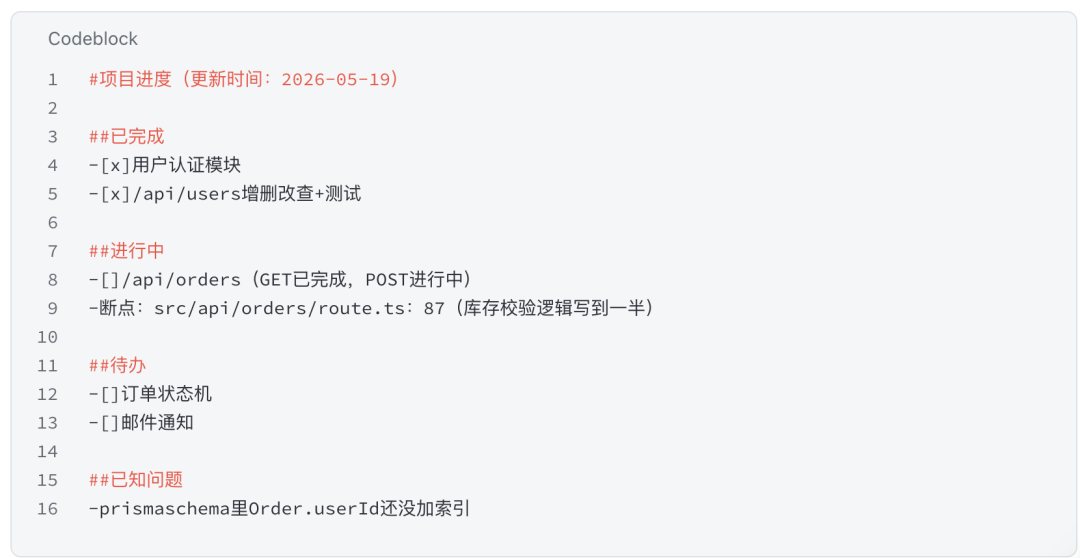
ステップ5:完了の定義を固定する(最重要)
AGENTS.md の末尾に検証コマンドを明記します:
## Done Definition
Task is NOT done until ALL of these pass:
- pnpm typecheck (exit code 0)
- pnpm test (exit code 0)
- pnpm lint (exit code 0)
- pnpm build (exit code 0)
終了コードが0でなければ、タスクは完了とみなされません。プロジェクトにまだこれらのコマンドがなければ、今日セットしましょう。
核心の教訓:前の4ステップをすべて正しくやっても、5ステップ目が欠けていれば、すべてが台無しです。フィードバックループがなければ、Harness を装備したのと同じことになりません。
3つの致命的な失敗パターン
Anthropic と OpenAI の実験が指し示したのは、エージェントに最も多い3つの失敗です:
1. 早すぎる勝利宣言
エージェントは500行の機能を書き終えると「完了」と出力します。コードをマージすると -- CI は赤一色、type check は12個のエラー、単体テストはひとつも走っていません。
解法:フィードバックサブシステム。判定権は終了コードに委ねます -- 終了コード != 0 なら、タスク != 完了です。
2. コンテキスト不安(Context Anxiety)
長時間タスクが70%まで進むと、コンテキスト Token がいっぱいになりそうになります。エージェントは進捗を急ぎ始めます -- テストをスキップし、境界処理を削り、stub を書いてまとめに入ります。
解法:状態サブシステム + 自主的な再起動。コンテキスト Token の使用量が70%を超えたら、自ら停止し、ブレークポイントを書き終えてから新しいセッションを開きます。
3. セッション横断の記憶喪失(Cross-Session Amnesia)
1つ目のセッションでユーザーモジュールを書いたのに、2つ目のセッションがまた getUserById を書き、インターフェースのシグネチャが衝突します。
解法:PROGRESS.md で完了機能のリストを保守 + AGENTS.md に初回読み取りの取り決めを明記。
核心の結論
モデルの能力が上限を決め、Harness はその上限を何割引き出せるかを決めます。
Harness がなければ、Opus 4.5 の書くコードはコンパイルすら通りません。Harness があれば、一段格下のモデルでも安定して納品できます。次のより強いモデルを待つより、先に Harness を整えましょう。
参考リンク:
Toolin 編集部
カテゴリ
関連記事
エッジ側で大モデルを動かす実践:Pi + LM Studioでローカルにエージェントコーディング環境を構築
Piエージェントフレームワーク+LM Studio推論サーバー+Dockerサンドボックスで、ローカルのM2 Mac上でGemma 4シリーズを動かし、エージェントコーディング、コード検査、ユニットテストまでこなす。精度はフロンティアモデルの約75%に達する。
微信「小微」グレースケール実測:12の入口がAIを情報フローに組み込む
微信のネイティブAIアシスタント「小微」のグレースケールテスト体験。メインモデルはWeLMで、12の入口がチャット履歴検索、ドキュメント要約、公式アカウント要約、ローカルライフなどの高頻度シーンをカバーする。
Baidu DuMate 実践ガイド:インストールからオフィス自動化まで
中国製の汎用オフィスエージェントDuMateの全プロセスチュートリアル。インストール、スキル、アプリ接続、自動化をカバーし、3分で使い始めて日常のオフィス業務をAIに任せる。
DeNovoSWE:初の長期Doc2Repo訓練セット、Code Agentにリポジトリ構築を学ばせる
中国人民大学高瓴学院がDeNovoSWEデータセットを公開。4818件の実タスクインスタンスでCode Agentにドキュメントからの完全なリポジトリ生成を学ばせ、Qwen3-30BはBeyondSWE-Doc2Repoで5.8%から47.2%へ向上。
Doubao Seed 2.1 Pro 実測:Codingがトップティア入り、マルチモーダルにも驚き
ByteDanceのDoubao Seed 2.1 Proを実測。Agent Codingとマルチモーダル能力が本番利用可能な水準を超え、スクリーンショットからのフロントエンド対話復元に対応。価格はClaude Opus 4.6比で約80%低下。
Hyper3D Rodin Gen-2.5:4秒で100万ポリゴン、3D生成にThinking機構を導入
影眸科技(Deemos)がHyper3D Rodin Gen-2.5を発表。3D生成で初めてLLM類似のThinking機構を導入し、4秒で100万ポリゴンのモデルを生成、1000万ポリゴン精度と12Kネイティブテクスチャを実現した。